Apache Superset: nền BI mã nguồn mở cho phòng đảm bảo chất lượng trường đại học tư thục
Đăng ngày 12/10/2026
Mục lục bài nghiên cứu
Superset trong một phút: công cụ BI cho người đã có kho dữ liệu
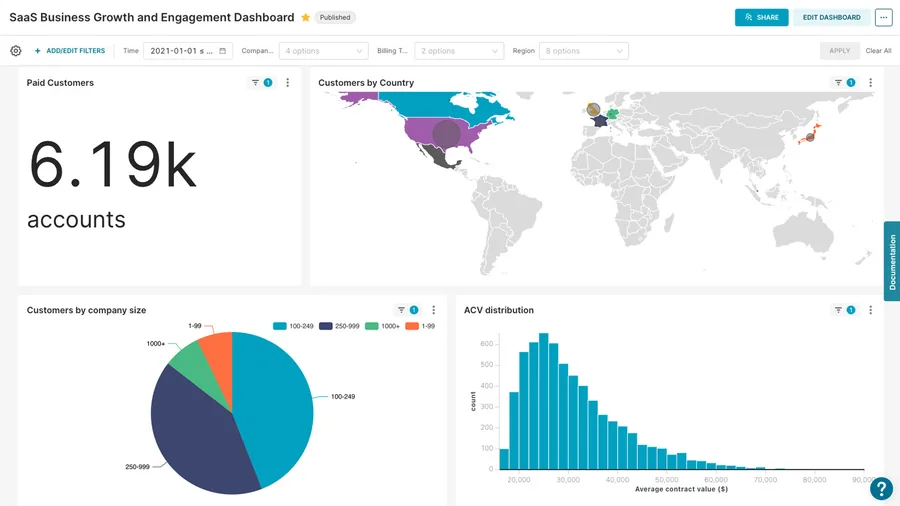
Apache Superset là ứng dụng web về trí tuệ kinh doanh (business intelligence, BI): người dùng truy vấn dữ liệu, dựng biểu đồ và gắn chúng vào bảng điều khiển. README mô tả một giao diện không cần mã để tạo biểu đồ, trình soạn thảo SQL, lớp ngữ nghĩa nhẹ, lớp bộ nhớ đệm có thể cấu hình, API và kiến trúc hướng đám mây. [1] Superset không tự chứa dữ liệu phân tích; nó đứng trước một cơ sở dữ liệu hoặc kho dữ liệu sẵn có.
Câu hỏi quyết định đầu tiên vì thế không phải là chọn biểu đồ nào, mà là dữ liệu đã được làm sạch ở đâu và ai chịu trách nhiệm về nó. Nếu tổ chức chưa có nơi tập hợp dữ liệu đáng tin, Superset chỉ làm lộ ra sự hỗn loạn đó bằng đồ thị đẹp hơn.
Về giấy phép, kho mã dùng Apache License 2.0 và là dự án của Apache Software Foundation, nên không có ranh giới open core giữa bản miễn phí và bản trả phí trong chính kho này. [1][2]
Khuyến nghị: cân nhắc Superset khi có đội kỹ thuật dữ liệu và nhu cầu dashboard cho nhiều bộ phận. Không nên chọn nếu chỉ cần vài biểu đồ tĩnh cho một người, hoặc nếu không ai đảm nhận vận hành một hệ thống gồm ứng dụng, cơ sở dữ liệu siêu dữ liệu, bộ nhớ đệm và tiến trình nền.
Số liệu có ở khắp nơi, nhưng không ai nhìn cùng một bảng
Một trường đại học tư thục thường có phần mềm quản lý đào tạo, phần mềm tuyển sinh, hệ thống thu học phí và bảng tính riêng của từng khoa. Mỗi báo cáo cuối kỳ được ghép thủ công, và con số của phòng đào tạo khó khớp với con số của phòng tài chính.
Superset giải quyết phần cuối của chuỗi đó: cho phép nhiều người cùng xem một định nghĩa chỉ số trên cùng nguồn dữ liệu, qua trình duyệt. Lớp ngữ nghĩa nhẹ mà README nhắc tới cho phép khai báo chiều và chỉ số tùy chỉnh để dùng lại. [1] Phần việc khó hơn nằm ở phía trước: thống nhất định nghĩa như thế nào là một sinh viên đang theo học, hay một khoản thu đã quyết toán.
Điều Superset không làm thay là sửa dữ liệu nguồn. Theo tài liệu bảo mật, chính dự án nhắc rằng Superset là nền tảng trực quan hóa và khám phá dữ liệu, không phải tường lửa cơ sở dữ liệu. [6]
Bốn khối lắp ghép: ứng dụng, siêu dữ liệu, bộ nhớ đệm và tiến trình nền
Tài liệu quản trị chia một bản cài Superset thành bốn thành phần: ứng dụng, cơ sở dữ liệu siêu dữ liệu (metadata database), lớp bộ nhớ đệm và cặp worker cùng beat. Hai thành phần cuối là tùy chọn nhưng cần cho một số tính năng. [4] Ứng dụng gồm backend Flask bằng Python, lớp API và giao diện React. [4]
Cơ sở dữ liệu siêu dữ liệu lưu định nghĩa biểu đồ, dashboard, thông tin người dùng và nhật ký; đây không phải kho dữ liệu phân tích. Tài liệu cho biết Superset được kiểm thử với PostgreSQL và MySQL cho vai trò này, còn SQLite hay container PostgreSQL của Docker Compose không được khuyến nghị cho sản xuất. [4]
Lớp bộ nhớ đệm làm hai việc: lưu kết quả truy vấn để biểu đồ mở lần hai không phải hỏi lại kho dữ liệu, và đóng vai trò message broker cho worker. Worker thực thi tác vụ như truy vấn bất đồng bộ hay chụp báo cáo, còn beat là bộ lập lịch, thường dùng Celery. [4]
Ngoài lõi, kho còn có hai hướng mở rộng đáng chú ý. Một là hệ thống extension với gói lõi cho frontend và backend, bảng extensions trong cơ sở dữ liệu và việc nạp mô-đun frontend bằng Module Federation. [5] Hai là dịch vụ MCP (Model Context Protocol), chạy như tiến trình riêng nhưng dùng chung cơ sở dữ liệu và cấu hình với Superset. [3]
Từ lần nhấp vào biểu đồ tới truy vấn SQL và trở lại
Tài liệu mô tả vòng đời cơ bản rất ngắn: người dùng mở biểu đồ hoặc dashboard, việc đó kích hoạt một truy vấn SQL tới kho dữ liệu chứa tập dữ liệu, và kết quả được hiển thị thành biểu đồ. [4]
Bộ nhớ đệm có nhiều tầng cấu hình riêng. Trạng thái bộ lọc dashboard và dữ liệu biểu mẫu của Explore là bắt buộc; bộ nhớ đệm siêu dữ liệu và dữ liệu biểu đồ là tùy chọn. Nếu hai loại bắt buộc không được định nghĩa, Superset dùng bộ nhớ đệm tích hợp lưu trong cơ sở dữ liệu siêu dữ liệu. [7] Thời gian hết hạn có thể đặt theo từng biểu đồ, tập dữ liệu hoặc cơ sở dữ liệu, và giá trị -1 tắt bộ nhớ đệm. [7]
Với truy vấn chạy nền, tài liệu Celery cho biết cần một broker và một nơi lưu kết quả, cấu hình CELERY_CONFIG giống nhau ở web server và worker. SQL Lab chỉ chạy bất đồng bộ khi cơ sở dữ liệu được bật tùy chọn tương ứng. [8] Với biểu đồ chạy bất đồng bộ toàn cục, tài liệu bộ nhớ đệm giải thích một chi tiết dễ sai: kết quả được worker ghi vào bộ nhớ đệm dữ liệu rồi trình duyệt đọc lại, nên thời gian sống quá ngắn có thể làm biểu đồ kẹt ở trạng thái chạy lại; mặc định sàn thời gian sống là 300 giây. [7]
Báo cáo định kỳ đi một đường khác: beat lập lịch, worker dùng trình duyệt không giao diện chụp ảnh hoặc PDF rồi gửi qua email, Slack hoặc webhook. [9] Đường đi này tiêu tốn bộ nhớ và CPU ở worker chứ không phải ở web server.
Tính năng đã đối chiếu và ranh giới giữa bản phát hành với nhánh chính
README liệt kê các nhóm chức năng: trình dựng biểu đồ không cần mã, SQL Editor, lớp ngữ nghĩa nhẹ, hỗ trợ gần như mọi cơ sở dữ liệu SQL có trình điều khiển DB-API và dialect SQLAlchemy, bộ nhớ đệm, vai trò bảo mật mở rộng được và API. [1]
Phần cảnh báo và báo cáo hỗ trợ định dạng PDF, PNG cho biểu đồ và dashboard, còn CSV, XLSX và văn bản chỉ cho từng biểu đồ. Email và Slack là kênh chính, webhook là kênh bổ sung phải bật bằng cờ tính năng. [9] Muốn gửi thật, phải tắt chế độ chạy thử có sẵn trong cấu hình Docker mẫu. [9]
Cần phân biệt bản phát hành với nhánh chính. Bản phát hành mới nhất lúc thu thập là 6.1.0, nhưng tài liệu cảnh báo trên nhánh này có câu nói từ phiên bản 7.0.0 Superset chụp màn hình chỉ bằng Playwright. [9] Đó là hành vi của phiên bản chưa phát hành, không phải tính năng của 6.1.0.
Tương tự, dịch vụ MCP có mục nêu hướng tương lai như hỗ trợ async/await, thêm lớp bộ nhớ đệm và cập nhật theo sự kiện qua WebSocket. [3] Bài xếp những mục này vào kế hoạch, không phải tính năng hiện có. Tài liệu MCP cũng mô tả các công cụ phần lớn thiên về đọc và các thao tác ghi đi qua mẫu command của Superset. [3]
Ai sẽ hưởng lợi, ai nên đứng ngoài
Superset hợp với tổ chức đã có kho dữ liệu hoặc ít nhất một cơ sở dữ liệu quan hệ tập trung, và có người viết được SQL hoặc quản lý mô hình dữ liệu. Người dùng cuối như trưởng khoa hay chuyên viên phân tích có thể dựng biểu đồ qua giao diện không cần mã, trong khi kỹ sư dữ liệu chuẩn bị tập dữ liệu và quyền. [1]
Nhóm khác là đội sản phẩm muốn nhúng biểu đồ vào ứng dụng nội bộ. Tài liệu bảo mật nhắc đến token khách cho dashboard nhúng và việc phải đặt SameSite thành None khi nhúng iframe, điều làm giảm một số bảo vệ CSRF của trình duyệt. [6]
Không phù hợp nếu tổ chức mong có một phần mềm làm sạch dữ liệu, mô hình hóa quy trình ETL hay lập báo cáo tài chính theo mẫu biểu cố định. Cũng không phù hợp với đội không có ai vận hành Redis, Celery và cơ sở dữ liệu siêu dữ liệu.
Tình huống đề xuất: phòng đảm bảo chất lượng của một trường đại học tư thục
Tình huống này là giả định, không phải trường hợp đã triển khai. Một trường đại học tư thục khoảng vài nghìn sinh viên ở Đồng Nai muốn phòng đảm bảo chất lượng theo dõi tuyển sinh, tỷ lệ đăng ký học phần, học lực và tỷ lệ thôi học theo khoa, phục vụ báo cáo tự đánh giá định kỳ. Nguồn là phần mềm đào tạo, phần mềm tài chính và bảng tính tuyển sinh.
Thiết kế đề xuất có bốn lớp. Một đêm một lần, quy trình ETL do bộ phận công nghệ viết đổ dữ liệu đã ẩn danh vào một cơ sở dữ liệu phân tích riêng, bảng chỉ chứa mã sinh viên đã băm. Superset kết nối tới cơ sở dữ liệu đó bằng một tài khoản chỉ có quyền SELECT. Tập dữ liệu định nghĩa các chỉ số như tỷ lệ giữ chân sinh viên. Dashboard theo vai trò: lãnh đạo xem toàn trường, mỗi trưởng khoa chỉ thấy khoa mình qua row-level security (bảo mật theo hàng), tính năng mà tài liệu MCP mô tả là định nghĩa ở mức tập dữ liệu, lọc theo thuộc tính người dùng. [3]
Báo cáo định kỳ PDF gửi tới các trưởng khoa mỗi đầu tháng nhờ worker và beat. [9] Sử dụng tài khoản đăng nhập một lần của trường qua OAuth hoặc LDAP thay cho tài khoản nội bộ, theo khuyến nghị sản xuất. [6]
Ranh giới cần giữ: dữ liệu sinh viên là dữ liệu cá nhân, nên trước khi lên dashboard phải có quy định về mục đích sử dụng, thời hạn lưu và người được xem. Dashboard không thay thế hồ sơ chính thức của phòng đào tạo. Kết luận từ biểu đồ như xác định nguyên nhân thôi học cần được người có chuyên môn thẩm định chứ không suy trực tiếp từ hình.
Vận hành: những việc xảy ra sau ngày cài đặt
Cài đặt từ PyPI chỉ tạo ứng dụng, còn bộ nhớ đệm, worker và beat do người dùng tự cấu hình. Với Docker Compose hoặc Kubernetes, các thành phần này được tạo sẵn. [4] Tài liệu Kubernetes hiện nêu rõ Helm chart trong kho đã bị đánh dấu ngừng khuyến nghị cho triển khai mới; hướng đi chính là Kubernetes Operator có tài liệu và kho riêng, chưa nằm trong phạm vi đã đọc của bài. [10]
Có vài quy tắc vận hành cụ thể trong tài liệu. Các node worker và web server phải dùng chung cơ sở dữ liệu siêu dữ liệu, nên SQLite không phù hợp. Trong toàn hệ thống chỉ nên chạy một beat; chạy nhiều bản sẽ khiến công việc định kỳ bị lập lịch lặp, ví dụ gửi báo cáo hai lần. [8]
Ở lớp ứng dụng, quản trị viên phải chuẩn bị cơ chế sao lưu cơ sở dữ liệu siêu dữ liệu, vì mất nó là mất định nghĩa biểu đồ và dashboard. [4] Nếu dùng dịch vụ MCP, tài liệu mô tả mỗi worker có một bộ kết nối riêng nên tổng số kết nối tính bằng kích thước pool nhân số worker, một con số cần so với giới hạn của cơ sở dữ liệu. [3]
Bảo mật: khóa bí mật, phiên đăng nhập và vai trò của cơ sở dữ liệu
Tài liệu bảo mật đặt SUPERSET_SECRET_KEY ở mức quan trọng nhất. Khóa này ký cookie phiên và liên quan đến mã hóa thông tin nhạy cảm trong cơ sở dữ liệu siêu dữ liệu như thông tin kết nối. Mỗi môi trường phải có khóa riêng, lưu trong biến môi trường hoặc hệ thống quản lý bí mật chứ không để trong tệp cấu hình hay kho mã. [6] Đổi khóa làm vô hiệu mọi phiên đăng nhập và có quy trình riêng phải theo đúng. [6]
Về phiên đăng nhập, tài liệu khuyến nghị mạnh dùng phiên phía máy chủ qua Redis hoặc tương tự, đặt thời hạn phiên ngắn thay vì mặc định 31 ngày, và bật các cờ Secure, HttpOnly, SameSite. Talisman, thư viện đặt tiêu đề bảo mật, tắt theo mặc định từ phiên bản 4.0 nên phải bật thủ công. [6]
Với dữ liệu, tài liệu khuyên dùng tài khoản cơ sở dữ liệu quyền hạn tối thiểu, tránh quyền ghi hay quản trị, và coi danh sách hàm SQL bị cấm chỉ là lớp phòng thủ bổ sung. Các bí mật khác như GUEST_TOKEN_JWT_SECRET và WEBSOCKET_JWT_SECRET cũng cần được đưa vào danh mục xoay vòng. [6]
Những khuyến nghị trên là cấu hình của quản trị viên, không tự động có sẵn. Bài chưa xét danh sách lỗ hổng đã công bố; trước khi triển khai nên đọc trang CVE của dự án và cập nhật bản vá thường xuyên, như chính tài liệu khuyên. [6]
Apache 2.0 và những điều giấy phép không nói thay
Tệp LICENSE.txt tại thư mục gốc là văn bản Apache License 2.0. [2] README cũng mang tiêu đề bản quyền của Apache Software Foundation và huy hiệu giấy phép Apache 2.0. [1] Tại commit đã khảo sát, bài không phát hiện tệp giấy phép riêng cho thư mục con trong các nguồn đã đọc, nhưng cũng chưa duyệt toàn bộ cây thư mục để kết luận tuyệt đối.
Apache 2.0 cho phép dùng, sửa đổi và phân phối cho mục đích thương mại, kèm điều kiện giữ thông báo bản quyền và nêu thay đổi; nó còn có điều khoản cấp quyền bằng sáng chế. Đây không phải tư vấn pháp lý.
Phạm vi giấy phép là mã nguồn tại commit này. Nó không bao phủ thư viện bên thứ ba phụ thuộc, trình điều khiển cơ sở dữ liệu cài thêm, bản extension do bên khác viết, nhãn hiệu, dịch vụ đám mây do công ty khác cung cấp, hay dữ liệu của bạn. Mỗi trình điều khiển cơ sở dữ liệu và gói bộ nhớ đệm mà tài liệu khuyên cài thêm có giấy phép riêng cần kiểm tra. [7][8]
Chi phí: ít ở bản quyền, nhiều ở con người và hạ tầng dữ liệu
Không có phí bản quyền cho chính kho mã theo giấy phép Apache 2.0, nhưng tổng chi phí sở hữu không bằng không. Bài không đưa con số tiền cụ thể vì các tệp đã đọc không có bảng giá và mọi đơn giá sẽ lỗi thời.
Nhóm chi phí đầu là con người. Cần một kỹ sư dữ liệu hoặc quản trị cơ sở dữ liệu xây tập dữ liệu và quy trình nạp; một quản trị Superset lo vai trò, nâng cấp và sao lưu; và thời gian đào tạo người dùng cuối. Thiếu người sở hữu định nghĩa chỉ số là rủi ro lớn hơn thiếu máy chủ.
Nhóm thứ hai là hạ tầng: máy chủ ứng dụng, cơ sở dữ liệu siêu dữ liệu độc lập, Redis hoặc bộ nhớ đệm tương đương, ít nhất một worker và một beat, cộng thêm kho dữ liệu phân tích. [4] Worker chạy báo cáo cần đủ bộ nhớ cho trình duyệt không giao diện. [9] Truy vấn dashboard cũng tạo tải cho kho dữ liệu nên bộ nhớ đệm hợp lý có thể giảm chi phí đó. [7]
Nhóm cuối là các dịch vụ ngoài nếu dùng, như Slack hoặc dịch vụ gửi email.
Các hướng thay thế: BI thương mại, BI mã nguồn mở khác, hay bảng tính
Phần này so sánh ở cấp cách tiếp cận. Công cụ BI thương mại như Power BI hay Tableau thường đóng gói trải nghiệm hoàn chỉnh kèm hỗ trợ từ nhà cung cấp, đổi lại là phụ thuộc vào mô hình thương mại của nhà cung cấp; bài không so sánh chức năng chi tiết. README Superset tự định vị là có thể thay thế hoặc bổ sung công cụ BI độc quyền cho nhiều nhóm, một lời giới thiệu của dự án. [1]
Các công cụ BI mã nguồn mở khác như Metabase hay Grafana có triết lý và giấy phép riêng; muốn chọn phải đọc giấy phép và mô hình thương mại của từng dự án.
Phương án tối giản là bảng tính cộng cơ sở dữ liệu có sẵn công cụ báo cáo. Nó đủ cho đội nhỏ và ít người xem. Superset đáng chọn khi số người xem, số nguồn dữ liệu và yêu cầu phân quyền tăng đến mức bảng tính trở thành điểm nghẽn. Quyết định nên dựa vào khả năng vận hành lâu dài hơn là danh sách biểu đồ.
Hạn chế và điều kiện không nên triển khai
Hạn chế lớn nhất là yêu cầu vận hành. Một hệ thống đủ dùng cho sản xuất không phải là một container duy nhất; tài liệu kiến trúc, bộ nhớ đệm, Celery và báo cáo cho thấy nhiều thành phần phải cấu hình đồng bộ. [4][7][8][9]
Hạn chế thứ hai là bảo mật mặc định. Nhiều biện pháp như Talisman, phiên phía máy chủ và thời hạn phiên ngắn phải tự bật. [6] Triển khai nhanh theo hướng dẫn thử nghiệm rồi giữ nguyên cho sản xuất là cách tạo ra rủi ro.
Hạn chế thứ ba là tốc độ thay đổi của tài liệu. Nhánh chính đã nhắc tới hành vi của phiên bản 7.0.0 khi bản phát hành mới nhất là 6.1.0, Helm chart đã chuyển sang trạng thái ngừng khuyến nghị và dịch vụ MCP còn nhiều mục kế hoạch. [3][9][10] Cần ghim phiên bản và đọc tài liệu đúng nhánh.
Không nên dùng Superset khi: dữ liệu nguồn chưa có người chịu trách nhiệm, mục tiêu là báo cáo pháp lý theo mẫu cố định, hoặc không thể cấp quyền SELECT hạn chế mà phải dùng tài khoản quản trị.
Thử nghiệm tám tuần với phòng đảm bảo chất lượng
Hai tuần đầu dành cho dữ liệu, chưa đụng tới Superset. Chọn ba chỉ số, ví dụ số hồ sơ tuyển sinh, tỷ lệ đăng ký học phần và tỷ lệ thôi học, viết định nghĩa bằng văn bản và để hai bộ phận cùng ký xác nhận. Tiêu chí hoàn thành: hai nguồn tính ra cùng một con số trên một mẫu dữ liệu cũ.
Tuần ba và bốn, dựng môi trường thử bằng Docker Compose với dữ liệu đã ẩn danh, một cơ sở dữ liệu siêu dữ liệu PostgreSQL, Redis, worker và đúng một beat. [4][8] Tiêu chí: dashboard mở trong ngưỡng thời gian nhóm tự đặt trước, và khi tắt Redis hệ thống phục hồi được theo kịch bản.
Tuần năm và sáu, kiểm thử phân quyền: tài khoản trưởng khoa A không xem được dữ liệu khoa B qua dashboard, SQL Lab hay xuất tệp. Đồng thời rà danh mục kiểm tra sản xuất trong tài liệu bảo mật. [6] Thử báo cáo định kỳ PDF với chế độ chạy thử đã tắt, chỉ gửi cho người trong nhóm. [9]
Tuần bảy và tám, cho năm người dùng thật dùng trong hai chu kỳ họp. Thu thập số lần phải nhờ kỹ sư sửa và số lần con số bị phản đối. Điều kiện thoát: dừng nếu quyền hàng không đáp ứng, nếu thời gian vận hành vượt năng lực đội, hoặc nếu định nghĩa chỉ số vẫn gây tranh cãi sau hai vòng hiệu chỉnh.
Kết luận
Superset là lớp hiển thị và khám phá dữ liệu trưởng thành về mặt kiến trúc, giấy phép rõ ràng và có tài liệu quản trị khá chi tiết. [1][2][4] Giá trị của nó chỉ xuất hiện khi phía dưới đã có dữ liệu được quản trị.
Với trường đại học trong kịch bản, hướng đi hợp lý là bắt đầu từ một vài chỉ số có người chịu trách nhiệm, dùng dữ liệu đã ẩn danh, tuân theo danh mục bảo mật sản xuất và đo gánh nặng vận hành trước khi mở rộng.
Các phần mới như extension và MCP nên được theo dõi nhưng chưa nên là điều kiện bắt buộc của quyết định đầu tiên. [3][5]
Nguồn và phương pháp
Bài này là nghiên cứu bàn giấy (desk research), không phải công trình khoa học đã qua phản biện. Tác giả không cài đặt, chạy, đo hiệu năng hay triển khai Superset; mọi nhận định dựa trên văn bản trong kho tại commit f4fe4e13c47d204dffca5e9408e388811d220f9f, kiểm tra ngày 2026-10-12.
Dự án được chọn từ kho lưu trữ GitHub Trending: apache/superset xuất hiện một lần, ngày 2026-07-26, danh sách Python, vị trí 7. [11] Kho lưu trữ này chỉ phủ các danh sách Python, Go, JavaScript và Swift, thiếu hai ngày 2026-09-03 và 2026-10-12, và không phải bảng xếp hạng top 100 chính thức.
Các tệp đã đọc gồm README và LICENSE.txt [1][2], tài liệu kiến trúc dịch vụ MCP [3], kiến trúc cho quản trị viên [4], kiến trúc extension [5], và năm tài liệu bổ sung về bảo mật, bộ nhớ đệm, truy vấn bất đồng bộ Celery, cảnh báo cùng báo cáo, và Kubernetes [6][7][8][9][10]. Một bản sao tài liệu kiến trúc của phiên bản 6.0.0 trong kho cũng được liệt kê nhưng không dùng. Bản phát hành mới nhất lúc thu thập là 6.1.0, ngày 2026-05-13.
Các điểm chưa xác minh đã được nêu ngay trong từng mục.
Xem mã nguồn Apache Superset trên GitHub