Bảo trì dự đoán: dữ liệu, bằng chứng và điều kiện thử
Đăng ngày 26/10/2026
Mục lục bài nghiên cứu
Tóm tắt và điều cần nhớ
Bảo trì dự đoán là cách dùng thông tin về thiết bị để dự báo vấn đề có thể xảy ra và hỗ trợ quyết định bảo dưỡng trước khi hỏng. AI có thể tham gia phân tích dữ liệu, nhưng cảm biến và mô hình chưa tự tạo thành một quy trình bảo trì hữu ích. Nhà máy cần biết cảnh báo sẽ dẫn tới hành động nào và ai chịu trách nhiệm kiểm.
- Chọn một dạng hỏng hoặc quyết định bảo trì cụ thể trước khi chọn AI.
- Dữ liệu cần gắn với thiết bị, thời gian, chế độ vận hành và lịch sử can thiệp.
- Phân biệt phát hiện bất thường với dự báo một sự cố trong tương lai.
- Giữ riêng kết quả thử nghiệm kỹ thuật và hiệu quả kinh tế đã được đối chiếu.
- Bài chưa có bằng chứng hoàn vốn độc lập đủ để áp chung cho doanh nghiệp vừa và nhỏ Việt Nam.
Dự báo để làm gì, khác theo dõi tình trạng thế nào?
Theo dõi tình trạng giúp biết thiết bị đang biểu hiện ra sao. Bảo trì dự đoán đi thêm bước hỏi vấn đề có thể xảy ra khi nào hoặc cần can thiệp trước điểm nào. Bài Hoffmann và Lasch mô tả khả năng dự báo sớm để lên kế hoạch và sử dụng thông tin vòng đời còn lại [1]. Đây là cách tiếp cận phân tích, không phải lời bảo đảm mọi kiểu hỏng đều dự báo được.
Một ngưỡng rung hoặc nhiệt độ có thể giúp phát hiện bất thường mà chưa cần một mô hình AI phức tạp. Nếu dùng AI, cần xác định nó dự báo trạng thái nào và người bảo trì làm gì với kết quả. Một xác suất không gắn với thời hạn, điều kiện sử dụng và hành động có thể làm người nhận khó quyết, dù phần mềm hiển thị rất nhiều dữ liệu.
Ví dụ giả định, nhà máy muốn biết khi nào cần kiểm một ổ trục, không phải để công cụ tự điều khiển toàn bộ dây chuyền. Người vận hành cần đủ thời gian để xác nhận, bố trí bảo trì và ghi kết quả. Nếu cảnh báo chỉ xuất hiện ngay lúc máy đã dừng, mô hình có thể nhận ra sự cố nhưng chưa giúp được việc chuẩn bị trước.
Bằng chứng hiện có mạnh đến đâu?
Nghiên cứu đa ca của Hoffmann và Lasch nêu đạt bão hòa thông tin sau 15 ca phân tích. Các đoạn đã đọc trình bày quan điểm người được hỏi về lợi ích, dữ liệu và triển khai; không phải thử nghiệm phân nhóm để tính tác động kinh tế. Phần tổng hợp nêu trở ngại như đầu tư cảm biến, hạ tầng, thiếu người có kỹ năng và thời gian hoàn vốn chưa rõ [1]. Bài không biến các ý kiến ấy thành tỷ lệ tiết kiệm cho Việt Nam.
Một tổng quan về AI và thiếu dữ liệu trong bảo trì dự đoán tìm trên Scopus ngày 09/02/2025, giai đoạn công bố 2018–2025. Tác giả chọn 40 nghiên cứu từ 417 kết quả theo ba nhóm truy vấn. Nguồn lưu ý nhiều mô hình làm tốt trong môi trường kiểm soát nhưng khó khái quát sang bối cảnh công nghiệp khác; dữ liệu nhiễu, thiếu hoặc không nhất quán làm giảm độ tin cậy [2]. Đây là tổng quan, không phải 40 thử nghiệm hoàn vốn ở doanh nghiệp nhỏ.
Vì thế, không nên nói toàn bộ bằng chứng đều yếu, nhưng cần nói đúng loại bằng chứng. Một nghiên cứu định tính giúp hiểu vướng mắc; một thử nghiệm kỹ thuật giúp kiểm mô hình trong điều kiện xác định; một dự án thực tế cần thêm dữ liệu về chi phí và hành động. Nguồn có thể trả lời tốt một câu hỏi mà chưa đủ để trả lời câu hỏi khác.
Danh sách kiểm dữ liệu trước khi làm mô hình
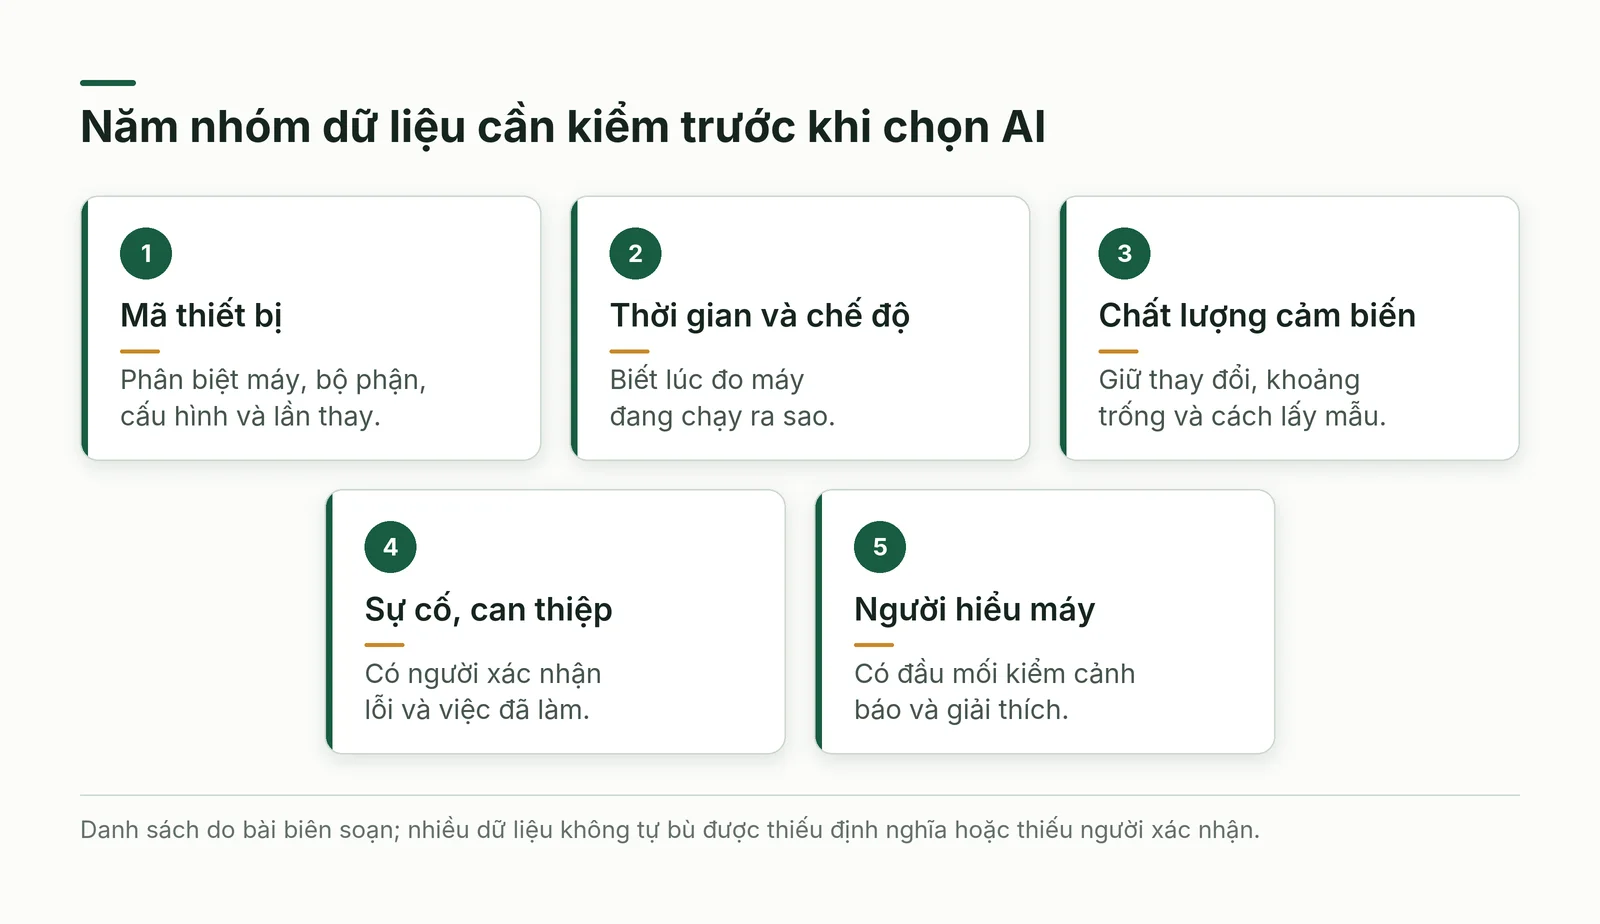
Bài đề xuất năm nhóm thông tin để xét mức sẵn sàng, không phải bộ tiêu chuẩn chứng nhận. Trước hết là danh tính thiết bị và bộ phận: có mã ổn định, thông số, lịch thay hay sửa không? Nếu cùng tên máy nhưng cấu hình khác nhau bị nhập chung, AI có thể học những khác biệt cấu hình thay vì dấu hiệu xuống cấp cần dự báo.
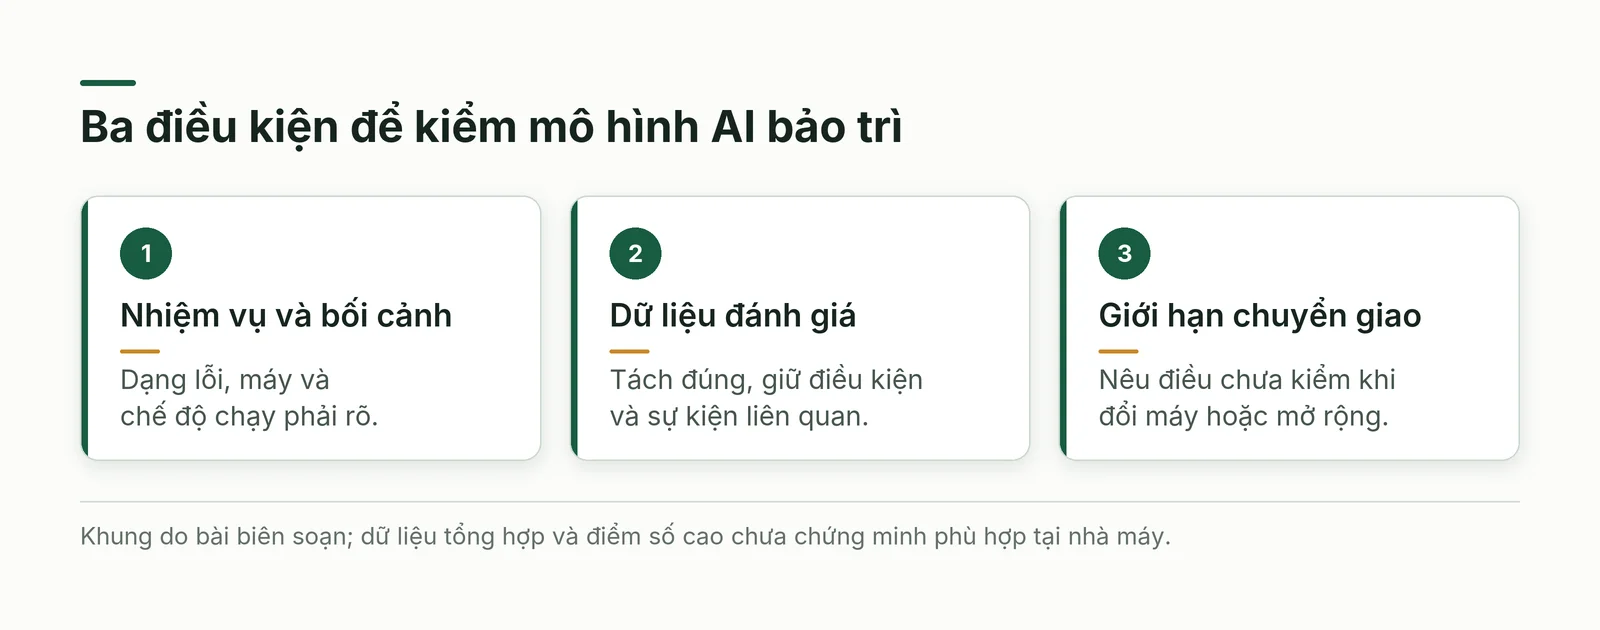
Nhóm thứ hai là thời gian và chế độ chạy. Cần biết tín hiệu được đo khi máy tải nhẹ, tải nặng, vừa khởi động hay đang dừng. Nhóm thứ ba là chất lượng đo: cảm biến có khoảng trống, thay vị trí hoặc thay cách lấy mẫu không? Chưa làm rõ những điều ấy thì một đồ thị thay đổi chưa tự cho biết thiết bị xấu đi.
Nhóm thứ tư là sự cố và can thiệp đã được xác nhận: khi nào có lỗi, đã kiểm thấy gì và thay bộ phận nào. Với mô hình học có giám sát để dự báo dạng hỏng cụ thể, cần nhãn phù hợp; không mặc định một dấu dừng máy luôn là hỏng thiết bị. Nhóm thứ năm là người hiểu máy, có thể xem lại những tình huống mô hình AI gắn cờ.
Trang NASA về C-MAPSS mô tả dữ liệu từ mô phỏng hệ động cơ với suy giảm và sự cố được đưa vào [3]. Bài báo kỹ thuật trên kho NASA, ghi ngày 20/04/2020, cũng nói dữ liệu quỹ đạo tới hỏng là tổng hợp, có sử dụng điều kiện bay ghi nhận thực để xây mô phỏng [4]. Không nên gọi một mô hình tốt trên dữ liệu như vậy là đã được kiểm trên dây chuyền của nhà máy mình.
Cảnh báo đúng chưa đủ nếu không có đường xử lý
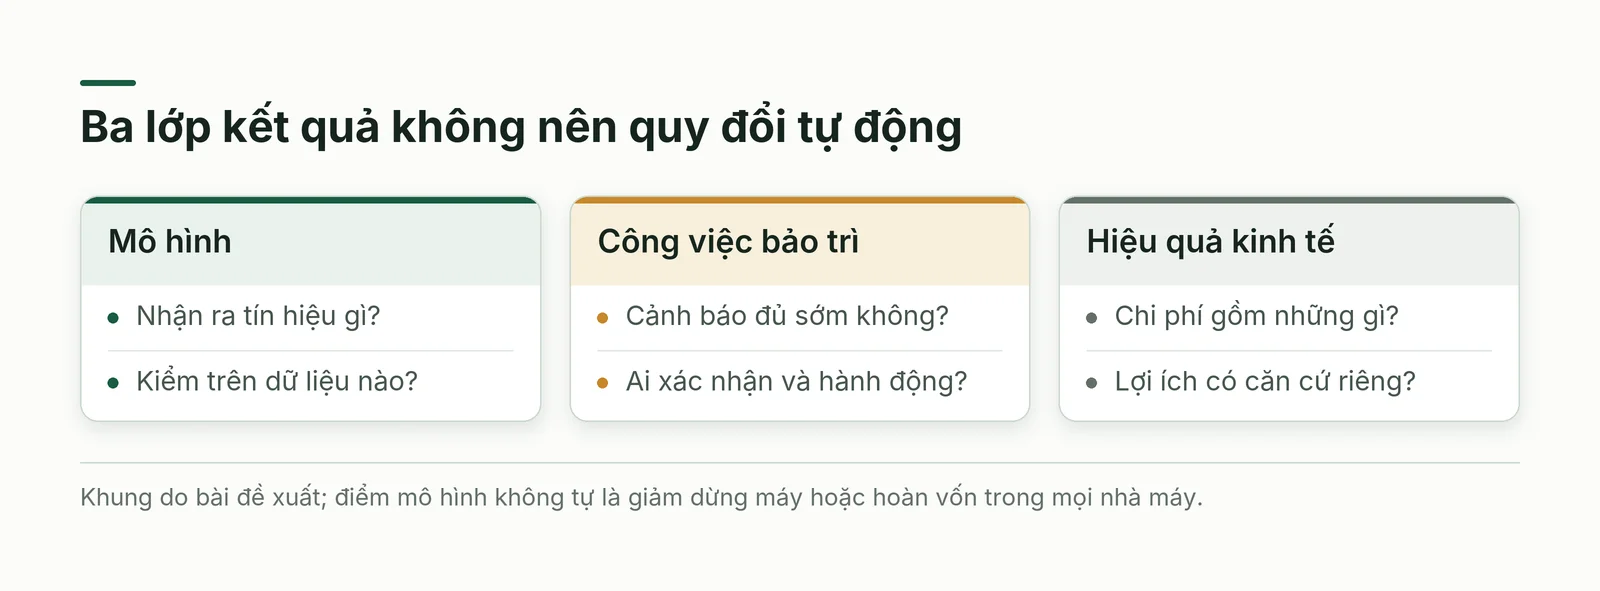
Bài đề xuất đánh giá một cảnh báo theo ba câu hỏi: có báo đúng việc cần quan tâm không, có đủ sớm để hành động không và người nhận có xử lý được không? Một mô hình AI có điểm kiểm cao nhưng gửi quá nhiều báo động giả có thể gây mệt mỏi. Ngược lại, giảm cảnh báo bằng cách bỏ sót tình huống quan trọng cũng chưa phải cải thiện.
Trong tình huống giả định về ổ trục, cần ghi một cảnh báo là một lần gửi hay một sự kiện sau khi gộp tín hiệu lặp. Ghi người nhận, thời điểm kiểm, kết quả và việc đã làm. Nếu mỗi lần lấy mẫu đều được tính thành một lần đúng, số báo động có thể rất lớn nhưng không giúp biết bao nhiêu vấn đề đã được xử lý phù hợp.
Khi thử AI, nên giữ cơ chế hiện có và để người bảo trì kiểm các cảnh báo trong phạm vi được duyệt. Đừng thay ngay lịch kiểm bắt buộc hoặc cách bảo vệ thiết bị chỉ vì mô hình vừa chạy tốt trên dữ liệu cũ. Bài không đặt một mức độ chính xác đủ để cho phép tự động hóa; yêu cầu phụ thuộc hậu quả của sai và điều kiện vận hành cụ thể.
Digital twin không tự đồng nghĩa hiệu quả bảo trì
Một nghiên cứu về phát triển digital twin trên Production Engineering mô tả máy rửa linh kiện nối dữ liệu vận hành với mô hình và điều khiển đáp ứng theo giá năng lượng. Thử nghiệm thực địa ghi giảm 78,45% chi phí năng lượng [5]. Phải gọi đúng đó là kết quả của thử nghiệm điều khiển năng lượng trong bối cảnh thiết bị ấy, không phải mức giảm chi phí bảo trì mà mọi nhà máy sẽ nhận được.
Cùng nghiên cứu nêu các điều kiện như quan sát trạng thái, điều khiển được và bảo vệ kết nối. Một bản sao số để hiển thị khác mô hình có thể hỗ trợ thử điều khiển; chỉ có hình 3D hoặc bảng dữ liệu chưa chứng minh đã đạt mức đó. AI có thể là một thành phần, nhưng cần kiểm vai trò và bằng chứng riêng thay vì gọi mọi mô phỏng là mô hình dự báo hỏng.
Tại Việt Nam: đọc rõ đã làm và hướng sẽ làm
Bản tin EVN ngày 12/03/2024 về hội nghị kỹ thuật nói áp dụng bảo dưỡng theo tình trạng trong khối lưới điện, nhằm đánh giá thiết bị và phát hiện khiếm khuyết [6]. Nguồn dùng tên CBM gần với bảo trì dự đoán; bài vẫn phân biệt đầu ra giám sát với dự báo cụ thể bằng AI. Đây là tình huống ngành điện, không phải khảo sát hiệu quả ở nhà máy vừa và nhỏ.
Bài về EVNSPC ngày 10/10/2025 tự công bố ứng dụng AI và cảm biến trong giám sát, chẩn đoán; phần 2026–2030 nêu hướng triển khai AI cho bảo trì dự đoán [7]. Cần giữ ranh giới giữa điều nguồn nói đã làm với kế hoạch mới. Bài không lấy mức cải thiện độ tin cậy chung trong bản tin để tính tác động riêng của một mô hình dự báo hoặc áp sang nhà máy khác.
Thông cáo WEF tháng 1/2026 nêu cơ sở Foxconn tại Bắc Ninh dùng nhiều giải pháp số và AI cho mục tiêu bền vững [8]. Đây là trường hợp được mạng lưới giải thưởng chọn, không phải mẫu đại diện cho mọi doanh nghiệp hoặc phép kiểm riêng bảo trì. Ba tình huống giúp nhìn bối cảnh áp dụng; chưa cung cấp tỷ lệ hoàn vốn độc lập phù hợp để hứa cho nhà máy nhỏ.
Theo quy mô nhà máy, nên thu hẹp khác nhau thế nào?
Doanh nghiệp nhỏ có nhà máy thường cần giữ nhật ký và trách nhiệm thiết bị rõ trước. Nếu không có người kiểm cảnh báo hoặc cảm biến không đủ ổn định, nên sửa những điểm ấy thay vì bắt đầu bằng gói AI rộng. Có thể chọn một máy quan trọng và một dạng vấn đề để tìm hiểu, nhưng không vì phạm vi nhỏ mà bỏ kiểm an toàn hoặc đánh giá quyền truy cập.
Doanh nghiệp vừa có đội bảo trì nhưng ít nhân lực dữ liệu nên tổ chức thử cùng người vận hành, kỹ thuật và người hiểu dữ liệu. Mỗi vai trò cần biết kết quả phải giải thích được bằng gì. Khi thuê ngoài AI, hãy hỏi cách lấy dữ liệu, lưu lịch sử và tiếp tục vận hành nếu thay nhà cung cấp; tránh để toàn bộ hiểu biết về mô hình chỉ nằm ở bên bán.
Doanh nghiệp lớn với nhiều dây chuyền cần kiểm khác biệt về máy, cảm biến, sản phẩm và chế độ chạy trước khi dùng lại mô hình. AI tốt ở một dây chuyền chưa tự chuyển được sang dây chuyền khác. Nên giữ lịch sử phiên bản, người duyệt mở rộng và cách theo dõi khi chất lượng giảm, thay vì chỉ tính số máy đã kết nối vào một nền tảng.
Nhà máy thuộc tập đoàn cũng không nên lấy chuẩn dữ liệu cấp nhóm thay cho việc kiểm tại hiện trường. Bảng tổng hợp cần cho thấy nơi nào đang đo, nơi nào mới thử và nơi nào chưa đủ dữ liệu. Khi điều kiện giữa đơn vị khác nhau, nên ghi giới hạn chuyển giao; không ép một mức chính xác hoặc một lịch hoàn vốn chung cho mọi nơi.
Góc nhìn AI: thiếu dữ liệu không được chữa bằng kết quả đẹp
Với bài toán dự báo hỏng cụ thể, dữ liệu huấn luyện phải giúp mô hình học điều liên quan tới sự cố và điều kiện vận hành. Dừng máy vì đổi ca, thiếu nguyên liệu hoặc bảo dưỡng theo lịch không tự là cùng một nhãn hỏng. AI có thể học nhầm dấu hiệu nếu cách ghi nhận không rõ; người biết thiết bị cần tham gia xác định điều mô hình thực sự phải dự báo.
Tổng quan về thiếu dữ liệu đề cập phương pháp tạo dữ liệu tổng hợp bằng GAN để tăng mẫu, đồng thời lưu ý cần kiểm độ trung thực và khả năng chuyển sang bối cảnh khác [2]. Vì vậy, không nên dùng dữ liệu do mô hình tạo ra làm bằng chứng nhà máy sẽ vận hành tốt. Những hướng mới có thể là đối tượng nghiên cứu, chưa tự thay được dữ liệu đánh giá phù hợp từ tình huống cần phục vụ.
Trong AI RMF 1.0 phát hành tháng 1/2023, phần MEASURE của NIST nhấn mạnh ghi bộ kiểm, thước đo và đánh giá trong điều kiện gần triển khai, cùng giới hạn khái quát [9]. Khung này định hướng quản lý rủi ro nói chung; nó không chứng nhận một hệ thống bảo trì cụ thể. Bài vận dụng bằng cách yêu cầu công bố mô hình được thử với máy, chế độ chạy và khoảng dữ liệu nào.
Bài đề xuất kiểm AI theo thời gian và theo nhóm thiết bị phù hợp, tránh dùng cùng một sự kiện vừa để dạy vừa để kiểm. Ghi các thay đổi bảo dưỡng có thể làm tín hiệu khác đi. Một điểm số tốt trên dữ liệu đã biết chưa trả lời mô hình sẽ phản ứng thế nào với máy vừa thay bộ phận hoặc một chế độ sản xuất chưa xuất hiện trong mẫu.
Nếu chưa có đủ ca hỏng để đánh giá dự báo, hãy giữ tên nhiệm vụ hẹp và mức tin cậy đúng. Có thể thử phát hiện bất thường có người xác nhận hoặc cải thiện thu thập dữ liệu trước; chưa gọi đó là hệ thống dự báo đã được kiểm. Không tự trao quyền điều khiển cho AI nhằm che việc chưa biết cách đo chất lượng hoặc chưa xác định hậu quả của cảnh báo sai.
Thử nhỏ cần có điều kiện đi tiếp và dừng
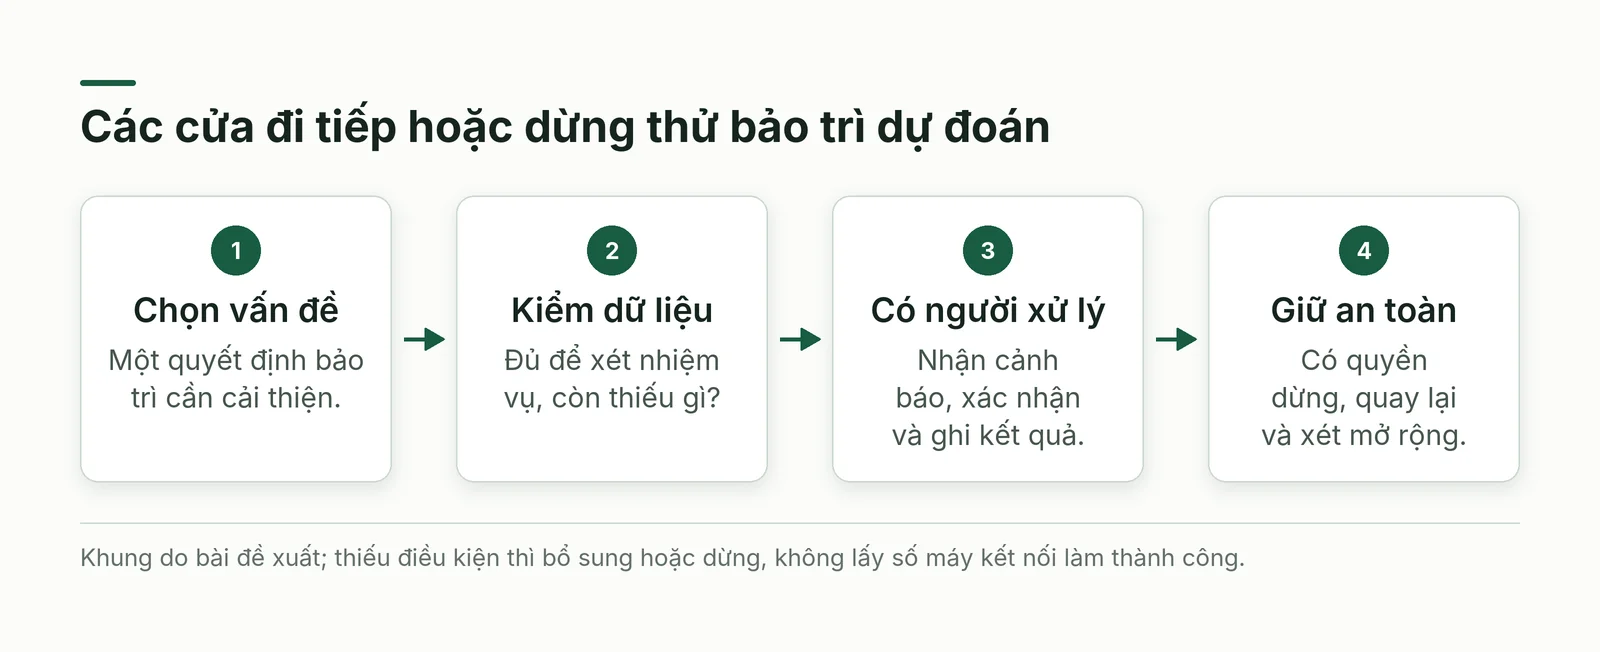
Bài đề xuất bắt đầu từ mô tả lỗi và quyết định người bảo trì cần đưa ra. Kiểm dữ liệu hiện có, thống nhất cách ghi sự kiện rồi mới chọn công cụ AI. Trước khi thử, xác định người nhận cảnh báo và cách phản hồi. Nếu không bố trí được bước xử lý, nên dừng ở hoàn thiện quy trình thay vì lắp thêm cảm biến để tạo một bảng theo dõi không ai dùng.
Tiếp đó thử trong phạm vi đã duyệt và so với cách làm hiện có theo cùng định nghĩa. Ghi cảnh báo có ích, báo sai, việc bỏ sót có thể kiểm được và công người phải bỏ ra. Đừng chỉ chọn những ca AI dự báo đúng để trình diễn. Nếu dữ liệu chưa đủ để kết luận về một dạng lỗi, kết quả cần nêu chưa đủ, không thay bằng tỷ lệ chính xác mặc định.
Chỉ cân nhắc mở rộng sau khi biết mô hình hỗ trợ được công việc nào và có thể vận hành, kiểm, quay lại ra sao. Các điều kiện này do bài biên soạn, chưa bảo đảm một tỷ lệ thành công. Người phụ trách cần biết ai có quyền dừng AI khi chất lượng dữ liệu hoặc cảnh báo đổi, và khi dừng thì quy trình bảo trì nào tiếp tục chịu trách nhiệm.
Tính chi phí cả dữ liệu, người kiểm và phần duy trì
Chi phí bảo trì dự đoán không chỉ là phần mềm hoặc cảm biến. Bài đề xuất ghi riêng thu thập dữ liệu, tích hợp, công kiểm, vận hành mô hình và hỗ trợ sau thay đổi. Với AI, cần tính thời gian người kỹ thuật giải thích cảnh báo và giữ nhãn; bỏ phần công ấy có thể làm bản dự toán rẻ trên giấy nhưng không đủ người để sử dụng.
Khi tính lợi ích, chỉ dùng phần tránh được có căn cứ, theo phạm vi và thời gian so phù hợp. Không mặc định mọi giờ dừng ít hơn đều do AI, hoặc mọi lần cảnh báo đều tránh một sự cố lớn. Nếu chưa tách được tác động, ghi đó là kết quả vận hành quan sát. Bài không có giá thị trường hay khoảng hoàn vốn đủ tin để áp chung cho nhà máy vừa và nhỏ.
An toàn vận hành phải được giữ khi thêm kết nối
NIST SP 800-82 bản sửa đổi 3, tháng 9/2023, giới thiệu hướng dẫn bảo vệ công nghệ vận hành với yêu cầu riêng về hiệu năng, độ tin cậy và an toàn. Trang nguồn còn chỉ tới dự thảo bản 4 công bố lấy ý kiến trong 2026 [10]. Bài dùng phần giới thiệu bản 3, không khẳng định đã kiểm toàn bộ hướng dẫn hoặc rằng đó là yêu cầu pháp luật của Việt Nam.
Thêm cảm biến, đường truyền hoặc dịch vụ AI cần được người phụ trách đánh giá trong phạm vi thiết bị thật. Bài đề xuất tách việc quan sát và gợi ý khỏi quyền thay tham số đang chạy, giữ cách thu hồi kết nối và quay lại. Không vô hiệu hóa bảo vệ hiện có để thử mô hình; nếu thay đổi có thể ảnh hưởng an toàn, phải xử lý theo thẩm quyền và quy trình phù hợp của đơn vị.
Giới hạn bằng chứng cần giữ trong quyết định
Bộ nguồn đã đọc chưa có một phép đo hoàn vốn độc lập đủ đại diện cho nhà máy vừa và nhỏ Việt Nam. Nghiên cứu ca, tổng quan, dữ liệu mô phỏng và bản tin doanh nghiệp cho thông tin khác nhau. Bài không gom chúng thành một tỷ lệ tiết kiệm chung. Đặc biệt, kết quả điều khiển năng lượng của thiết bị hoặc thành tích của cơ sở được chọn chưa phải tác động riêng của AI bảo trì.
Hỏi đáp về bảo trì dự đoán bằng AI
Có cần AI ngay khi bắt đầu bảo trì dự đoán không? Chưa chắc. Trước hết cần xác định vấn đề, dữ liệu và hành động phù hợp. Có khi theo dõi tình trạng hoặc một ngưỡng đơn giản đã giúp công việc. Mô hình phức tạp hơn chỉ đáng thử khi có lý do và cách kiểm; không nên lấy tên AI làm mục tiêu đầu tư thay cho việc giảm một vướng mắc rõ.
Nhà máy ít ca hỏng có thể triển khai không? Có thể bắt đầu từ cải thiện dữ liệu hoặc nhiệm vụ phát hiện bất thường hẹp, có người kiểm. Nhưng ít ca hỏng làm việc đánh giá dự báo khó hơn. Cần nói đúng giới hạn thay vì gọi điểm số trên một bộ chuẩn bên ngoài là bằng chứng mô hình phù hợp với mọi máy tại nhà máy mình.
Dữ liệu tổng hợp có thay lịch sử thiết bị thật không? Không nên mặc định như vậy. Nó có thể hỗ trợ nghiên cứu và thử phương pháp nhưng cần kiểm độ phù hợp. Điều kiện máy, cảm biến và chế độ vận hành có thể khác. Hãy giữ riêng dữ liệu tạo ra, dữ liệu quan sát và bộ đánh giá; một mô hình tốt trên dữ liệu mô phỏng chưa tự chứng minh hiệu quả tại hiện trường.
Giảm 78,45% chi phí trong nghiên cứu có dùng lập dự toán không? Chỉ nên hiểu đúng đó là chi phí năng lượng trong thử nghiệm máy rửa linh kiện được nêu [5]. Bài không dùng mức này làm tỷ lệ tiết kiệm bảo trì cho thiết bị khác. Lập dự toán cần dữ liệu và phạm vi riêng, gồm công người kiểm, tích hợp và duy trì chứ không chỉ lợi ích kỳ vọng.
Khi nào nên dừng thí điểm AI? Khi chưa có người xử lý, dữ liệu không đủ kiểm nhiệm vụ, không giữ được an toàn hoặc không biết mô hình đã làm tốt hơn điều gì. Dừng để bổ sung điều kiện là một kết quả có ích, không cần che bằng số máy kết nối. Nếu tiếp tục, phải giữ người chịu trách nhiệm và tiêu chí đánh giá đã thống nhất trước.
Kết luận: bắt đầu từ một quyết định bảo trì cần cải thiện
Hãy chọn một dạng vấn đề trên một nhóm thiết bị và ghi người nhận cảnh báo sẽ làm gì. Kiểm dữ liệu, cách xác nhận và điều kiện an toàn trước khi chọn AI. Trong thử nghiệm, ghi cả cảnh báo sai, phần chưa đủ bằng chứng và công duy trì. Việc mở rộng cần dựa vào kết quả giải thích được trong điều kiện đang sử dụng. Bảo trì dự đoán có ích khi hỗ trợ hành động đúng lúc; điểm mô hình hoặc một tỷ lệ tiết kiệm ở nơi khác chưa đủ thay thế điều đó.
Nguồn và phương pháp
Truy cập ngày 26/10/2026. Bài được AI hỗ trợ nghiên cứu và biên soạn nguyên bản, không phải bản dịch. Danh sách dữ liệu, ba lớp kết quả, điều kiện thí điểm và cửa quyết định là đóng góp thực hành của bài, chưa được kiểm nghiệm chứng minh tác động. Ví dụ tự dựng đều là giả định. Nội dung không phải tư vấn pháp lý, thuế, tài chính hoặc thiết kế kỹ thuật cho một dây chuyền cụ thể.
Đã dùng năm truy vấn và 24 lượt truy xuất kể cả lỗi rồi dừng. Hai nguồn MDPI về tổng quan 2021 và 2026 trả 429; không thử XML, đường khác hay tiếp tục gọi nguồn đó. Bản tin nghiên cứu LED trên cổng IGIP mở lỗi nên không dùng số hoặc kết quả từ tìm kiếm. Hoffmann và Lasch chỉ đọc các đoạn ca, rào cản, lợi ích được công cụ trả về; chưa xác minh đầy đủ cách chọn người, bảy ngành hoặc phạm vi địa lý từ bản gốc, nên không đưa các chi tiết ấy từ danh mục cũ.
Tổng quan Scopus chỉ dùng phần phương pháp và các đoạn dữ liệu, khả năng chuyển mô hình đã đọc; không chuyển 40 nghiên cứu thành thử nghiệm hoàn vốn. Chưa đọc đủ kết luận về học liên bang nên không khẳng định mức triển khai của hướng này. Bài digital twin chỉ dùng phần thiết bị và kết quả chi phí năng lượng được trả về; 78,45% không phải hiệu quả bảo trì chung.
NASA được đọc trang mô tả dữ liệu và phần đầu bài kỹ thuật 2020; dữ liệu mô phỏng không phải thử nghiệm nhà máy Việt Nam, không tải hoặc kiểm lại tập dữ liệu trong lượt này. NIST chỉ dùng đoạn MEASURE của AI RMF 1.0 và giới thiệu OT bản 3 có liên kết dự thảo 4. Hai bản tin EVN là thông tin tự công bố; WEF là trường hợp được chọn và chương trình có hợp tác với nhà tư vấn. Chưa kiểm chứng độc lập số hiệu quả doanh nghiệp hoặc khả năng khái quát cho nhà máy vừa và nhỏ tại Việt Nam.