Dagster: điều phối theo tài sản dữ liệu, partition và kiểm tra chất lượng
Đăng ngày 12/10/2026
Mục lục bài nghiên cứu
Dagster trong một đoạn: điều phối quanh tài sản dữ liệu thay vì quanh tác vụ
Dagster là bộ điều phối pipeline dữ liệu được thiết kế để phát triển và duy trì tài sản dữ liệu (data asset) như bảng, tập dữ liệu, mô hình học máy hay báo cáo. Người dùng khai báo tài sản bằng hàm Python; Dagster chạy các hàm đó đúng lúc và giữ tài sản luôn cập nhật, kèm lineage, tức dòng phả hệ cho biết dữ liệu sinh ra từ đâu, cùng khả năng quan sát. [1]
Công cụ này đáng cân nhắc khi câu hỏi quan trọng là con số trong báo cáo đến từ đâu, đã cập nhật chưa, có qua kiểm tra chất lượng không, chứ không chỉ là job đêm qua có chạy hay không. Partition (chia dữ liệu thành các lát theo ngày hay theo danh mục), asset check và schedule là các cơ chế trả lời trực tiếp loại câu hỏi đó. [2][4][5]
Chưa nên chọn Dagster nếu nhu cầu là quy trình nghiệp vụ có người phê duyệt, nếu chỉ có vài truy vấn chạy theo lịch, hoặc đội chưa có người viết Python. Bản OSS đòi hỏi tự vận hành ba dịch vụ chạy lâu dài; Dagster+ là nền tảng thương mại được quản lý, xây trên engine mã nguồn mở. [3][6]
Khi job báo xanh nhưng báo cáo doanh thu vẫn sai
Ở nhiều doanh nghiệp, pipeline dữ liệu được quản lý như danh sách tác vụ: tải tệp, làm sạch, tổng hợp, gửi báo cáo. Bộ lập lịch báo thành công khi mọi lệnh kết thúc không lỗi, kể cả khi một chi nhánh quên gửi dữ liệu, một cột bị đổi tên hay số liệu bị nhân đôi. Người quản lý chỉ phát hiện khi con số trong cuộc họp lệch với tiền thu thực tế.
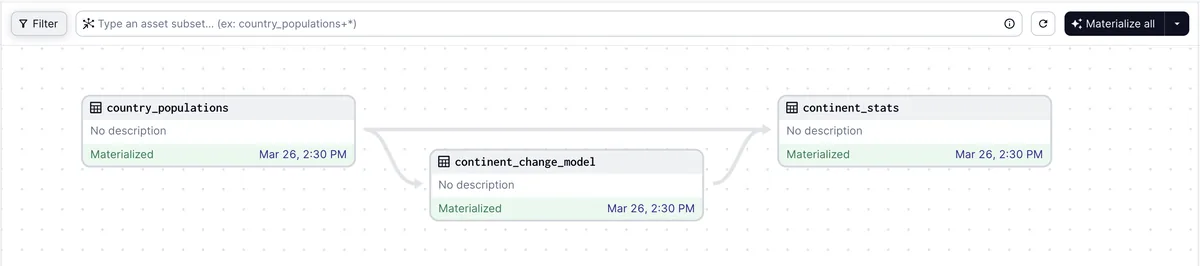
Dagster chuyển đối tượng quản lý từ tác vụ sang tài sản. Mỗi bảng hay báo cáo là một asset có phụ thuộc, có lịch sử materialization, tức những lần được tạo hoặc cập nhật, có thể chia partition và gắn kiểm tra chất lượng. Asset check chạy khi asset được thực thi và lưu metadata về kết quả, nhờ đó lỗi dữ liệu trở thành tín hiệu nhìn thấy được. [2][4][5]
Cách nhìn này có giá: nhóm phải mô hình hóa dữ liệu thành đồ thị tài sản, đặt khóa định danh, chọn cách chia partition và học nhiều khái niệm hơn một lịch cron. Lợi ích chỉ xuất hiện khi có người chịu trách nhiệm định nghĩa thế nào là đúng cho từng tài sản.
Asset, Definitions, code location và ba dịch vụ chạy nền của bản OSS
Trung tâm là asset, đơn vị dữ liệu logic; các asset phụ thuộc nhau tạo thành lineage. Mọi định nghĩa được gom vào đối tượng Definitions cấp cao nhất, và chỉ thực thể có trong Definitions mới được triển khai, hiện trên giao diện. Code location là tập định nghĩa triển khai trong một môi trường Python xác định, cho phép tách phụ thuộc giữa các nhóm. [2]
Quanh asset có resource cung cấp kết nối tới cơ sở dữ liệu hay API; IO manager quy định cách lưu và đọc dữ liệu giữa các bước; job chọn một tập asset để thực thi; schedule chạy theo chu kỳ; sensor kích hoạt khi có sự kiện như tệp mới; automation condition mô tả khi nào asset cần chạy dựa trên trạng thái của chính nó và các asset thượng nguồn. [2]
Về hệ thống, bản OSS cần ba dịch vụ chạy lâu: dagster-webserver phục vụ giao diện và GraphQL, có thể nhiều bản sao; dagster-daemon vận hành schedule, sensor và hàng đợi run, không hỗ trợ nhiều bản sao; máy chủ code location cung cấp metadata về định nghĩa, mỗi code location chỉ một bản sao. Lưu trữ, executor và run launcher đều thay thế được; mặc định thông tin run nằm trong SQLite và có thể chuyển sang PostgreSQL. [3]
Cấu hình chia ba tầng: dagster.yaml cho thành phần toàn instance như cơ sở dữ liệu, workspace.yaml mô tả cách nạp mã, và run config cho từng lần chạy job; với Helm chart trên Kubernetes, hai tầng đầu được sinh từ giá trị Helm. [3]
Đường đi của một lần materialize, từ webserver tới run worker và IO manager
Khi người dùng bấm materialize trên giao diện, webserver gọi run coordinator, lớp có thể đưa run vào hàng đợi cho daemon. Daemon lấy run và gọi run launcher để khởi tạo run worker dưới dạng tiến trình, container hay pod Kubernetes. Run worker duyệt đồ thị và dùng executor thực thi từng bước. Run do schedule hay sensor tạo ra đi qua cùng chuỗi, chỉ khác ở chỗ daemon thực hiện bước đầu. [3]
Trong run worker, asset đọc nguồn qua resource và ghi kết quả qua IO manager vào nơi lưu trữ đã cấu hình, còn Dagster ghi nhận sự kiện materialization, metadata và kết quả asset check. Với asset có partition, mỗi partition được materialize trong một run riêng; chọn nhiều partition cùng lúc thì daemon phải đang chạy để xếp hàng các run. [2][4][5]
Ở Dagster+ Hybrid, luồng có thêm agent chạy trong hạ tầng khách hàng: agent hỏi API của Dagster+ xem có việc không, khởi chạy mã trong code server, và mã người dùng gửi metadata ngược về qua GraphQL trên HTTPS. Theo mặc định, run worker còn tải log stdout và stderr lên Dagster+, có thể tắt trong thiết lập agent. [7]
Partition, asset check, schedule và sensor qua lăng kính tài liệu chính thức
Tài liệu partition mô tả các dạng theo thời gian; theo danh mục cố định; hai chiều qua MultiPartitionsDefinition, ví dụ ngày và khu vực với khóa dạng 2024-08-01|us; và động qua DynamicPartitionsDefinition khi danh mục chỉ biết lúc chạy. Partition theo lịch tùy biến cho phép loại ngày nghỉ. Tài liệu khuyến nghị mỗi asset không quá 100.000 partition để giao diện tải nhanh. [4]
Asset check kiểm tra một thuộc tính như cột không rỗng, đúng lược đồ hay dữ liệu còn mới. Mặc định job nhắm tới asset sẽ chạy kèm check liên quan; check thất bại không chặn asset hạ nguồn trừ khi đặt blocking=True; check theo partition đang ở trạng thái Preview. Cảnh báo khi check thất bại được ghi là dành cho Dagster+, còn bản OSS có thể tự dựng bằng schedule và sensor, ví dụ gửi email khi job kiểm tra thất bại. [5]
README cho biết Dagster dùng được từ phát triển cục bộ, kiểm thử đơn vị, kiểm thử tích hợp tới staging và production, hỗ trợ chính thức Python 3.9 đến 3.14 và có thư viện tích hợp với nhiều công cụ dữ liệu. Component sinh asset, check, schedule hay sensor từ cấu hình YAML hoặc Python gọn nhẹ, làm khuôn mẫu cho phần lặp lại. [1][2]
Chuỗi bán lẻ, chuỗi nhà hàng và nhóm dữ liệu nhỏ: ai cần mô hình asset
Dagster hợp với tổ chức có ít nhất một kỹ sư dữ liệu và nhiều nguồn phải hợp nhất thành báo cáo định kỳ: chuỗi bán lẻ, chuỗi nhà hàng, logistics, thương mại điện tử, tài chính nội bộ. Nhóm khoa học dữ liệu cũng có lợi khi mô hình học máy được quản lý như một asset có phụ thuộc rõ ràng, giống ví dụ ba asset trong README. [1][2]
Đơn vị xây hệ thống tri thức, chẳng hạn kiểu “bộ não thứ hai” được bàn trong loạt bài trên phamvanthu.com, có thể mượn tư duy asset và lineage để biết mỗi bản tóm tắt sinh từ tài liệu gốc nào và đã cũ chưa. Đó là gợi ý về cách tổ chức dữ liệu, không phải tuyên bố rằng hệ thống nào đã dùng Dagster.
Ngược lại, quán ăn đơn lẻ chỉ cần báo cáo từ phần mềm bán hàng, nhóm không viết Python, hay tổ chức cần điều phối phê duyệt và giao dịch dài ngày nên chọn công cụ khác. Bản OSS cần người vận hành hạ tầng; nếu không có, có thể xét Dagster+, kèm câu hỏi metadata nào sẽ nằm ở control plane của nhà cung cấp. [6][7]
Chuỗi nhà hàng lẩu với partition theo ngày và chi nhánh cho doanh thu, tồn kho và hao hụt
Kịch bản giả định: một chuỗi khoảng mười hai nhà hàng lẩu ở Hà Nội và vài tỉnh lân cận, có bếp trung tâm sơ chế nước dùng, thịt bò, rau nấm. Mỗi tối, phần mềm bán hàng của từng chi nhánh xuất hóa đơn, quản lý kho nhập số tồn cuối ngày, và bếp trung tâm cần đề xuất lượng hàng cho hôm sau. Việc tổng hợp đang làm bằng bảng tính lúc gần nửa đêm, và hao hụt chỉ lộ ra khi kiểm kê cuối tháng.
Đề xuất dùng partition hai chiều theo ngày và chi nhánh. Asset hoa_don_tho nhận tệp từng chi nhánh; doanh_thu_sach loại hóa đơn hủy; tieu_hao_ly_thuyet nhân số món đã bán với định mức nguyên liệu; ton_kho_thuc_te lấy số kiểm kê; chenh_lech_hao_hut so sánh hai bên; de_xuat_dat_hang tính lượng chuẩn bị cho bếp trung tâm. Schedule chạy lúc hai giờ sáng cho partition ngày hôm trước, giống ví dụ lịch một giờ sáng trong tài liệu; chi nhánh mới thêm qua partition động. [4]
Asset check chặn số liệu sai: mã hóa đơn không rỗng, số lượng không âm, tổng doanh thu khớp báo cáo chốt ca. Check trên doanh_thu_sach đặt blocking=True để đề xuất đặt hàng không bị tính từ dữ liệu lỗi. Khi một chi nhánh sửa dữ liệu bán hàng, nhóm chỉ materialize lại các partition bị ảnh hưởng thay vì chạy lại cả tháng. [4][5]
Đây là thiết kế đề xuất, không phải dự án đã diễn ra; giá trị của nó phụ thuộc chất lượng định mức nguyên liệu và kỷ luật xuất dữ liệu ở từng chi nhánh. Dagster làm lộ ra chênh lệch, còn giải thích chênh lệch là việc của quản lý bếp và kho.
Tự host Dagster OSS: daemon một bản sao, code location và lựa chọn lưu trữ
Triển khai OSS gồm webserver, daemon và một hoặc nhiều máy chủ code location. Vì daemon không chạy được nhiều bản sao và mỗi code location chỉ có một bản sao máy chủ, các tiến trình này cần giám sát và cơ chế tự khởi động lại; daemon dừng thì schedule, sensor và hàng đợi run cũng dừng. Nếu không có daemon, webserver gọi thẳng run launcher và bỏ qua run coordinator, chỉ hợp cho phát triển cục bộ. [3]
Lưu thông tin run bằng SQLite mặc định đủ cho thử nghiệm; vận hành thật nên chuyển sang PostgreSQL qua dagster.yaml và có kế hoạch sao lưu. Run launcher quyết định mỗi run là tiến trình mới, container hay pod; executor quyết định các bước trong run chạy ở đâu. Với chuỗi nhà hàng, một máy chủ chạy run dạng tiến trình thường đủ cho giai đoạn đầu; bộ cài khởi đầu theo README gồm dagster, dagster-webserver và dagster-dg-cli. [1][3]
Dagster+ có hai dạng là Serverless và Hybrid. Ở Hybrid, phía khách hàng chỉ vận hành agent và code server; tài liệu liệt kê agent cho Amazon ECS, Azure, Docker và Kubernetes, agent cục bộ để thử nghiệm và tùy chọn nhiều agent để dự phòng. [6][7]
Dữ liệu doanh thu nằm ở đâu giữa OSS tự host, Dagster+ Hybrid và telemetry
Với bản OSS tự host, dữ liệu nghiệp vụ lẫn metadata nằm trong hạ tầng doanh nghiệp. Tài liệu kiến trúc OSS mô tả webserver phục vụ giao diện và GraphQL nhưng không đề cập cơ chế đăng nhập hay phân quyền người dùng; bài đề xuất đặt giao diện sau VPN hoặc proxy có xác thực, rồi kiểm tra lại với phiên bản sẽ triển khai. [3]
Dagster thu thập telemetry sử dụng ở cả frontend và backend. Tài liệu khẳng định không thu thập dữ liệu do pipeline xử lý và không thu thập thông tin định danh về định nghĩa như tên asset, op hay job; log telemetry backend nằm trong thư mục logs của DAGSTER_HOME, và có thể tắt bằng mục telemetry với enabled: false trong dagster.yaml. [8]
Với Dagster+ Hybrid, tài liệu nhà cung cấp mô tả mô hình bảo mật chia sẻ: mã người dùng không rời môi trường khách hàng, không cần mở cổng chiều vào. Dù vậy control plane lưu nhiều loại metadata: tên và khóa asset, lineage, chủ sở hữu có thể là email, tên cột, số dòng, metadata tùy biến kể cả bản xem trước dữ liệu nếu được định nghĩa, cùng log tính toán nếu không tắt. Tuyên bố về chứng nhận SOC 2 Type II và mã hóa là thông tin nhà cung cấp, cần kiểm chứng qua hợp đồng. [7]
Với dữ liệu khách hàng thân thiết của chuỗi nhà hàng, không nên đưa số điện thoại hay tên khách vào metadata, bản xem trước hoặc log, dù chạy OSS hay Hybrid.
Apache 2.0 ở gốc, croniter vendored theo giấy phép kiểu MIT và ranh giới Dagster+
Tệp LICENSE ở gốc kho là Apache License 2.0, ghi bản quyền Dagster Labs năm 2025, và README cũng nêu Dagster theo giấy phép Apache 2.0. Giấy phép cho phép dùng, sửa và phân phối, có điều khoản cấp quyền sáng chế, yêu cầu giữ thông báo và tệp NOTICE nếu có, đồng thời không cấp quyền dùng nhãn hiệu. [1][9]
Kho là monorepo gồm nhiều gói và có mã bên thứ ba được vendored, tức sao chép thẳng vào cây mã. Thư mục _vendored/croniter trong gói dagster mang thông báo giấy phép kiểu MIT với bản quyền Matsumoto Taichi giai đoạn 2010–2012, khác Apache 2.0 ở gốc; bản phân phối lại phải giữ thông báo của từng phần như vậy. [10]
Dagster+ là nền tảng quản lý thương mại xây trên engine mã nguồn mở, không được cấp phép bởi tệp LICENSE trong kho. Một số khả năng như cảnh báo khi asset check thất bại được gắn với Dagster+, và tài liệu nhắc tới cơ chế tín dụng sử dụng của dịch vụ này; bài không bàn giá hay điều khoản thương mại. Giấy phép cũng không bao phủ dữ liệu doanh nghiệp, thư viện cài từ PyPI hay công cụ bên ngoài được tích hợp. [5][6]
Nguồn lực cho mười hai chi nhánh: người mô hình hóa asset, máy chủ và kho dữ liệu
Giả định: mười hai chi nhánh, mỗi ngày vài chục nghìn dòng hóa đơn, sáu asset chính, partition hai chiều, dữ liệu nghiệp vụ đặt trong PostgreSQL của doanh nghiệp. Khoản lớn nhất là thời gian một kỹ sư dữ liệu trong hai đến ba tháng đầu để mô hình hóa asset, viết check và làm việc với quản lý bếp về định mức.
Hạ tầng gồm một máy chủ cỡ vừa chạy webserver, daemon, code location và run dạng tiến trình, cộng nơi lưu trữ của Dagster và kho dữ liệu nghiệp vụ, có thể chung một cụm PostgreSQL nhưng tách schema. Mười hai chi nhánh trong năm năm tạo khoảng 21.900 partition mỗi asset, vẫn dưới ngưỡng 100.000 mà tài liệu khuyến nghị. [4]
Chi phí định kỳ gồm cập nhật phiên bản, theo dõi daemon, xử lý backfill và hỗ trợ chi nhánh khi tệp lỗi. Với Dagster+, phần control plane do nhà cung cấp vận hành và tài liệu có nhắc tới hạn mức tín dụng sử dụng (credit); bài không nêu giá vì không có nguồn giá trong phạm vi khảo sát, và mọi con số quy mô ở đây là giả định. [5][6]
Đơn vị quản lý khác nhau: đặt Dagster cạnh cron, Airflow, Prefect và dbt
Chuỗi script chạy bằng cron là điểm xuất phát rẻ nhất, nhưng thiếu lineage, kiểm tra chất lượng và khả năng chạy lại đúng phần dữ liệu bị ảnh hưởng. Nếu báo cáo chỉ có một nguồn và một người phụ trách, phương án này có thể vẫn đủ.
Các bộ điều phối workflow khác như Apache Airflow hay Prefect cũng chạy được pipeline của chuỗi nhà hàng. Câu hỏi không phải công cụ nào “tốt hơn”, mà mỗi công cụ lấy gì làm đơn vị trung tâm, tác vụ, lần chạy hay tài sản dữ liệu, và điều đó ảnh hưởng thế nào tới partition theo chi nhánh, chạy lại dữ liệu cũ và chặn dữ liệu lỗi. Nên chấm điểm bằng cùng một pipeline thử.
Ở một trục khác là công cụ chuyển đổi dữ liệu như dbt; tài liệu asset check cho biết tích hợp dbt của Dagster có thể đưa kiểm thử dbt sẵn có thành asset check, nên hai hướng có thể kết hợp thay vì loại trừ. Mọi kết luận về công cụ nào phù hợp hơn cần dựa trên phép thử đó; bài này dừng ở mức tiêu chí. [5]
Những trường hợp Dagster quá nặng hoặc lệch mục đích
Về kiến trúc, daemon không hỗ trợ nhiều bản sao và mỗi code location chỉ một bản sao máy chủ, nên dự phòng của bản OSS dựa vào cơ chế khởi động lại của hạ tầng. Số partition nên giữ dưới 100.000 mỗi asset; check theo partition còn ở Preview; check thất bại không tự chặn hạ nguồn nếu không bật blocking. [3][4][5]
Về phạm vi, README định vị Dagster cho việc phát triển và duy trì tài sản dữ liệu; tài liệu đã đọc không trình bày nó như engine cho quy trình nghiệp vụ có người phê duyệt kéo dài nhiều ngày. Một số tiện ích như cảnh báo khi asset check thất bại được gắn với Dagster+, nên đội dùng OSS phải tự xây phần tương ứng. [1][5]
Không nên dùng Dagster khi dữ liệu nguồn còn hỗn loạn đến mức chưa xác định được bảng nào là nguồn sự thật, khi không ai chịu trách nhiệm định nghĩa check, hoặc khi yêu cầu bảo mật không cho metadata rời hạ tầng mà tổ chức lại thiếu người tự vận hành. Khi đó, chuẩn hóa khâu thu thập dữ liệu nên đi trước việc chọn công cụ điều phối.
Tám tuần với ba chi nhánh: chỉ số, mốc kiểm tra và điều kiện dừng
Tuần 1–2: dựng instance OSS với PostgreSQL, tắt telemetry nếu chính sách nội bộ yêu cầu, mô hình hóa ba asset đầu là hóa đơn thô, doanh thu sạch và tiêu hao lý thuyết cho ba chi nhánh có khối lượng khác nhau. Mốc kiểm tra: đồ thị lineage trên giao diện khớp sơ đồ nghiệp vụ mà quản lý bếp đã duyệt. [8]
Tuần 3–6: chạy hằng đêm song song với bảng tính hiện tại. Chỉ số theo dõi gồm tỷ lệ partition ngày hôm trước hoàn tất trước sáu giờ sáng; số lần asset check bắt được lỗi thật so với cảnh báo nhầm; độ lệch giữa doanh thu sạch và báo cáo chốt ca; thời gian materialize lại một tuần dữ liệu của một chi nhánh sau khi sửa tệp nguồn.
Tuần 7–8: bật asset đề xuất đặt hàng ở chế độ tham khảo để bếp trung tâm so với lượng đặt thực tế. Điều kiện mở rộng: chi nhánh gửi dữ liệu đúng hạn ổn định, check chặn được lỗi trước khi tới đề xuất, và người vận hành xử lý được sự cố daemon theo runbook. Dừng hoặc lùi lại nếu tỷ lệ tệp nguồn lỗi quá cao, vì khi đó vấn đề nằm ở khâu thu thập. Kế hoạch là đề xuất, chưa có số liệu đo.
Kết luận về Dagster: giá trị nằm ở khả năng giải thích từng con số
Dagster mang lại một mô hình nhất quán gồm tài sản dữ liệu có phụ thuộc, partition, kiểm tra chất lượng và lịch chạy, cùng kiến trúc OSS được mô tả rõ với webserver, daemon và code location. Giấy phép Apache 2.0 ở gốc cho phép tự host, còn Dagster+ là lựa chọn quản lý tách biệt. [2][3][6][9]
Với chuỗi nhà hàng hay doanh nghiệp bán lẻ nhiều điểm, partition theo ngày và chi nhánh cùng asset check có chặn hạ nguồn là hai cơ chế đáng thử nhất. Ngược lại, chi phí học khái niệm và vận hành ba dịch vụ là có thật, và Dagster không phải công cụ cho quy trình phê duyệt hay giao dịch.
Thước đo cuối cùng không phải số pipeline chạy được, mà là khi giám đốc vận hành hỏi vì sao chi nhánh này hao hụt thịt bò cao bất thường, đội dữ liệu có chỉ ra ngay asset, partition và lần chạy đã tạo ra con số đó hay không.
Ghi chú phương pháp: nguồn tuyển chọn, commit khảo sát và phạm vi
Trong loạt nghiên cứu năm 2026, Dagster được xếp vào nhóm Tự động hóa và tích hợp. Căn cứ tuyển chọn là trang lưu trữ GitHub Trending ngày 05/02/2026, nơi dagster-io/dagster đứng thứ mười trong danh sách Python. [11] Dữ liệu ứng viên chỉ ghi nhận đúng một lần xuất hiện này. Nguồn này độc lập với GitHub, giới hạn ở các mục Python, Go, JavaScript, Swift và không có dữ liệu cho 03/09 cũng như 12/10; danh sách của loạt bài vì vậy là tuyển chọn biên tập chứ không phải Top 100 chính thức.
Các tệp được đọc tại commit ea313f0665515c94baf4739c9629c5ef0f214f0c (ngày commit 09/10/2026), kiểm tra ngày 12/10/2026: README, LICENSE, tổng quan triển khai, kiến trúc triển khai OSS, kiến trúc Dagster+ Hybrid, trang khái niệm, hướng dẫn partition, hướng dẫn asset check, trang telemetry và LICENSE của croniter vendored. Mã ở commit này có thể khác bản phát hành doanh nghiệp sẽ cài. [1][2][3][4][5][6][7][8][9][10]
Cách làm là khảo sát văn bản có trợ giúp của AI: pipeline không được dựng hay chạy, độ trễ không được đo. Kịch bản chuỗi lẩu, phần nguồn lực và kế hoạch tám tuần là đề xuất phân tích. Đây không phải bài báo khoa học qua phản biện; mô tả tiếp thị kiểu “best-in-class” hay số sao không được coi là bằng chứng.
Xem mã nguồn Dagster trên GitHub