Embedding tiếng Việt: kiểm tài liệu song ngữ trước khi chọn
Đăng ngày 27/10/2026
Mục lục bài nghiên cứu
Tóm tắt: thử đúng cặp câu hỏi và nguồn trước khi lập kho
Embedding tiếng Việt là biểu diễn số của văn bản, thường dùng để tìm những đoạn có liên quan với câu hỏi. Khi doanh nghiệp có tài liệu Việt–Anh, điều cần kiểm không dừng ở việc mô hình nhận được cả hai thứ tiếng. Cần xem câu hỏi tiếng Việt có tìm đúng nguồn tiếng Anh, chiều ngược lại có làm được và các điều kiện dễ nhầm có còn được phân biệt. Một đoạn gần nghĩa vẫn có thể thuộc gói dịch vụ khác hoặc nói điều ngược với câu hỏi.
Bài đề xuất hai công cụ thực hành: phiếu cặp chứng cứ để xây bộ thử theo công việc và hộ chiếu không gian biểu diễn để lưu cấu hình tạo vector. Tình huống xuyên suốt là công ty dịch vụ giả định có mô tả gói hỗ trợ thiết bị bằng hai ngôn ngữ. Trợ lý chỉ tìm tài liệu và soạn dự thảo cho nhân viên kiểm, không xác nhận quyền lợi khách hàng hoặc tự cam kết cung cấp dịch vụ. Bài chưa chạy mô hình, API hay đo tại doanh nghiệp.
Tài liệu Sentence Transformers phân biệt tìm kiếm đối xứng, như tìm câu hỏi tương tự, với tìm kiếm bất đối xứng, như dùng câu ngắn tìm đoạn giải thích dài. Cách mã hóa câu hỏi và tài liệu có thể dùng chỉ dẫn hoặc chế độ riêng; chúng cũng có thể giống nhau nếu mô hình không được huấn luyện với sự phân biệt đó. Vì thế, một phép thử cặp câu đồng nghĩa chưa đủ đại diện cho tìm đoạn nguồn để trả lời trong kho nghiệp vụ[1].
Tách gần nghĩa khỏi đồng nhất trong công việc
“Có hỗ trợ từ xa” và “có hỗ trợ tại địa điểm khách” có thể cùng xuất hiện trong văn bản về bảo trì thiết bị. Đối với người dùng hỏi cách liên hệ, hai đoạn có thể đều liên quan. Đối với câu hỏi về phạm vi một gói cụ thể, một đoạn có thể sai. Trước khi chọn mô hình, người phụ trách cần viết rõ mục tiêu là tìm chủ đề, tìm đối tượng hay tìm đủ điều kiện để chuẩn bị câu trả lời. Các mục tiêu đòi hỏi nhãn đánh giá khác nhau.
Điểm độ gần không nên được diễn giải thành xác suất điều kiện áp dụng. Khoảng cách chỉ có nghĩa trong cách biểu diễn và phép đo đã chọn. Doanh nghiệp cần giữ các trường định danh, mã gói, phiên bản và phạm vi nguồn để đối chiếu sau khi tìm. Trong phép thử đề xuất, tài liệu đúng chủ đề nhưng sai gói được ghi là ứng viên gây nhầm. Nếu chỉ chấm mức giống văn phong hoặc chung nhiều từ chuyên môn, đội dự án có thể đánh giá nhầm sự hữu ích.
Sự khác biệt ấy cũng làm rõ trách nhiệm nhân viên. Người dùng có thể chọn một hồ sơ để xem, còn hệ thống vẫn phải cho biết điều kiện nào được nguồn chứng minh và điều kiện nào chưa rõ. Không dùng vector để âm thầm thay gói dịch vụ người hỏi đã xác nhận. Khi câu hỏi chưa đủ thông tin nhận diện, hành vi phù hợp có thể là hỏi thêm. Việc trả về một lựa chọn dễ giải thích đáng giá hơn việc luôn trả một đoạn văn tự tin.
Đọc phương pháp huấn luyện để biết đang so điều gì
Báo cáo Multilingual E5 mô tả tiền huấn luyện tương phản trên cặp văn bản rồi tinh chỉnh bằng dữ liệu có nhãn; giai đoạn sau có mẫu âm khó và chưng cất từ mô hình so cặp. Biến thể có chỉ dẫn nhiệm vụ được trình bày riêng với các biến thể trước đó. Đây là thông tin về cách học quan hệ giữa văn bản, không phải chứng nhận cho mọi tình huống tiếng Việt. Các phần đánh giá tiếng Anh, truy hồi đa ngôn ngữ và tìm cặp dịch cũng không phải một nhiệm vụ duy nhất[2].
Người chọn mô hình nên ghi loại công việc công bố bên cạnh tên mô hình. Một bộ thử phân loại chủ đề có thể cho biết khả năng gom nhóm nhưng chưa cho biết tìm điều khoản áp dụng. Một phép tìm hai câu dịch tương ứng có thể hữu ích cho tài liệu song song, song chưa tái hiện câu hỏi ngắn tìm trong nhiều trang hướng dẫn. Sự phù hợp không thể suy chỉ từ tên “đa ngôn ngữ”, kích thước mô hình hoặc số ngôn ngữ được nhà phát triển liệt kê.
Cần đọc thêm bản triển khai đang dùng. Một họ mô hình có thể có nhiều cấu hình, kích thước hoặc phiên bản tinh chỉnh khác nhau. Người vận hành ghi chính xác tên kho, bản sửa đổi và chức năng đang lấy từ mô hình; tránh ghi chung một nhãn gia đình rồi coi mọi bản thay thế được cho nhau. Kết quả thử phải đi cùng cấu hình đó. Nếu đổi biến thể mà vẫn giữ bảng kết quả cũ, hồ sơ lựa chọn đã mất khả năng giải thích.
Phân biệt đánh giá nhiều ngôn ngữ với tìm xuyên ngôn ngữ
MIRACL mô tả truy hồi trên nhiều ngôn ngữ nhưng trong từng bài toán, câu hỏi và kho Wikipedia ở cùng ngôn ngữ. Nghiên cứu gọi rõ đây là truy hồi đơn ngữ trên nhiều ngôn ngữ, phân biệt với câu hỏi một ngôn ngữ tìm tài liệu ở ngôn ngữ khác. Các đánh giá liên quan được người bản ngữ thực hiện trong phạm vi bộ dữ liệu. Vì vậy điểm của mô hình trên một benchmark mang nhãn đa ngôn ngữ không tự chứng minh câu Việt tìm đúng tài liệu Anh trong kho doanh nghiệp[3].
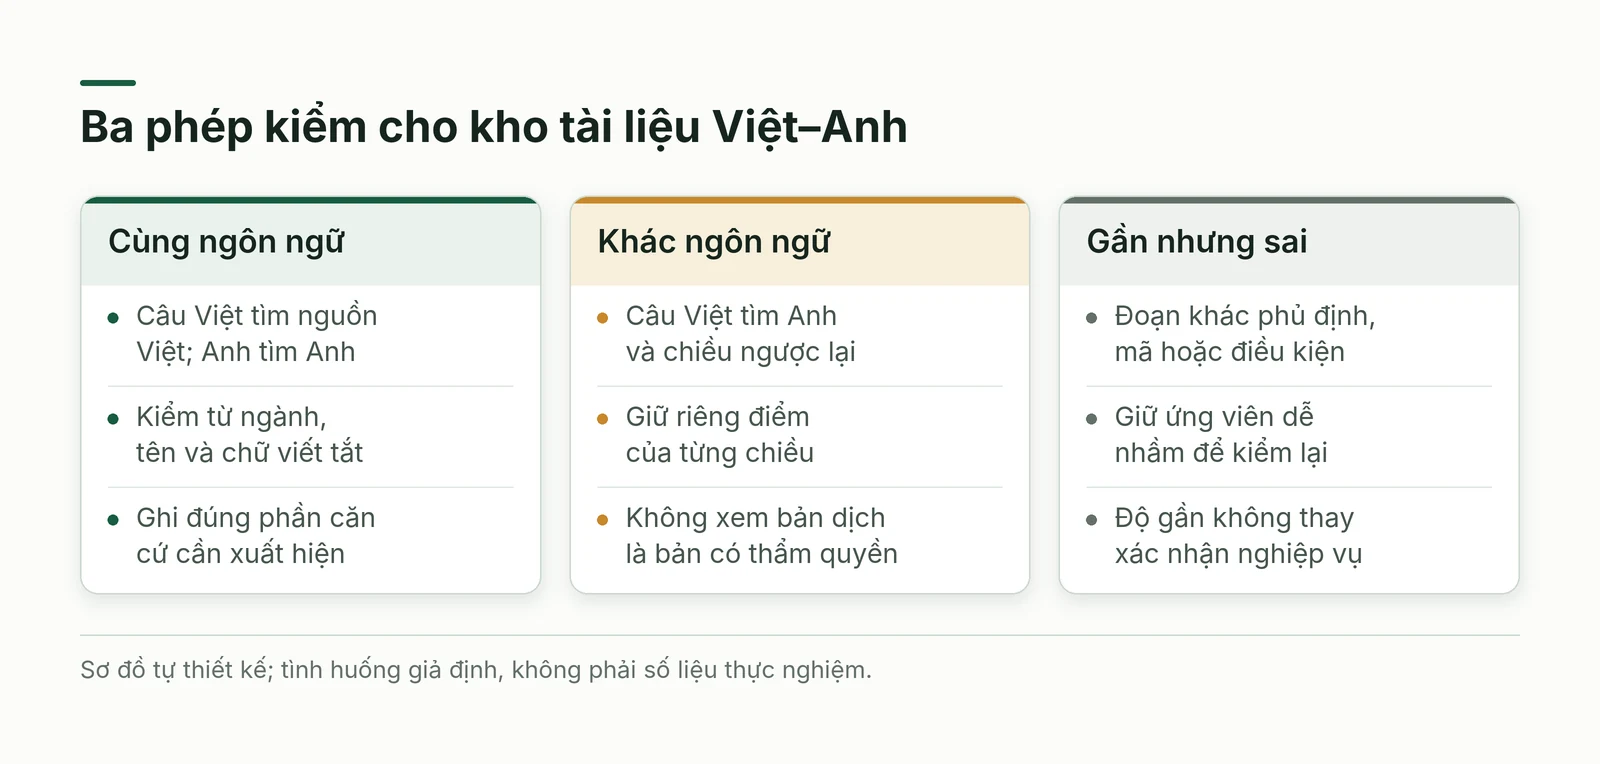
Bộ thử đề xuất chia bốn chiều: câu Việt tìm nguồn Việt, câu Anh tìm nguồn Anh, câu Việt tìm nguồn Anh và câu Anh tìm nguồn Việt. Giữ kết quả từng chiều để thấy bất cân xứng. Không bắt buộc chúng phải có số câu giống nhau nếu tần suất công việc khác nhau, nhưng phải công bố cơ cấu đã thử. Nếu doanh nghiệp chủ yếu hỏi bằng tiếng Việt trong khi tài liệu mới thường ở tiếng Anh, chiều Việt–Anh cần được xem kỹ ngay từ đầu.
Tài liệu hai ngôn ngữ cũng có thể không tương đương về trạng thái. Bản tiếng Anh mới bổ sung ngoại lệ trong khi bản tiếng Việt đang chờ cập nhật không phải hai nguồn thay thế hoàn toàn. Kho cần ghi quan hệ bản dịch và bản nguồn cùng người xác nhận. Khi phát hiện khác biệt, trợ lý nêu mâu thuẫn cho người quản lý tài liệu, không chọn bản có điểm độ gần cao hơn để tự quyết bản nào đang chi phối công việc.
Đọc benchmark theo nhiệm vụ, phiên bản và cách tổng hợp
MMTEB mở rộng đánh giá embedding trên nhiều loại nhiệm vụ và ngôn ngữ, yêu cầu thông tin về dữ liệu, nhãn, giấy phép và phương ngữ. Nghiên cứu cũng xây các tập benchmark có lựa chọn nhiệm vụ và phân biệt cách tổng hợp thứ hạng với điểm theo nhóm nhiệm vụ. Điều này giải thích vì sao một điểm trung bình không đại diện trọn vẹn cho truy hồi nội bộ. Bài dùng bản v4 tháng 11/2025 để đọc phương pháp, không coi bảng mô hình trong đó là thứ hạng hiện tại[4].
Khi xem một kết quả công bố, phiếu lựa chọn nên giữ tên bộ thử, bản dữ liệu, loại nhiệm vụ, tập câu và cách chấm. Cần biết kết quả là cùng ngôn ngữ hay xuyên ngôn ngữ, đoạn ngắn hay tài liệu dài, và cấu hình có chỉ dẫn nào. Nếu hai mô hình chỉ có số điểm ở hai tập khác nhau, doanh nghiệp chưa có phép so trực tiếp. Có thể dùng kết quả ấy để chọn ứng viên thử, nhưng không nên dùng để tuyên bố mô hình này phù hợp hơn cho kho riêng.
Người làm nghiệp vụ không cần đọc mọi bảng số trước khi khởi động. Họ cần biết những điều kiện nào của phép đo giống công việc của mình và điều kiện nào khác. Đội kỹ thuật có thể chuẩn bị một trang ghi điểm giống, điểm thiếu và câu cần thử bổ sung. Việc thừa nhận khoảng trống giúp bộ thử nội bộ có mục đích. Nó cũng tránh biến bài lựa chọn công cụ thành cuộc thi chạy theo nhãn dẫn đầu mà bỏ qua lỗi quan trọng của người dùng.
Cấu hình câu hỏi và tài liệu phải đúng với mô hình
Model card của multilingual-e5-large-instruct yêu cầu chỉ dẫn nhiệm vụ cho câu hỏi, trong khi tài liệu truy hồi không cần thêm chỉ dẫn ấy. Ví dụ sử dụng còn có bước gộp đầu ra, chuẩn hóa và giới hạn đầu vào; phần giải thích lưu ý thứ tự tương đối của điểm. Những chi tiết này cho thấy gọi đúng tên mô hình chưa đủ để tái hiện cách dùng. Không nên lấy một ngưỡng độ gần bất kỳ rồi xem như mức tin cậy chung cho mọi cấu hình[5].
Trong thử nghiệm đề xuất, đội kỹ thuật ghi một mẫu chỉ dẫn duy nhất cho loại nhiệm vụ đã xác định, rồi giữ cố định khi so các câu trong cùng cấu hình. Nếu muốn thử cách diễn đạt chỉ dẫn khác, coi đó là cấu hình khác và lưu kết quả riêng. Không chỉnh từng câu đến khi tìm đúng rồi báo toàn bộ tập đã đạt. Phần tài liệu cũng cần giữ cách thêm tiêu đề, mã gói hoặc ngữ cảnh vì chúng làm thay đổi văn bản được biểu diễn.
Model card BGE-M3 nêu cách dùng không còn đòi thêm chỉ dẫn cho câu hỏi như một số bản BGE trước; card cũng ghi lại việc sửa lỗi đánh giá MIRACL liên quan đến loại nhầm các đoạn theo mã. Đây là lời nhắc phải kiểm cách nhập và cả cách chấm, không sao chép công thức từ một họ mô hình sang họ khác. Thông báo sửa kết quả do tác giả đưa ra được xem như lịch sử phương pháp, không phải bằng chứng chất lượng trong kho Việt–Anh[6].
Một mô hình có thể cho nhiều kiểu biểu diễn khác nhau
Bản v5 của nghiên cứu M3-Embedding trình bày ba chức năng: vector dày, biểu diễn thưa theo từ và nhiều vector với tương tác ở mức token. Chúng có cách tạo biểu diễn và tính độ liên quan khác nhau. Chỉ dùng đầu ra vector dày không đồng nghĩa đã chạy cả ba phương pháp trong bài nghiên cứu. Khi một công cụ tích hợp nêu có hỗ trợ BGE-M3, doanh nghiệp vẫn phải xác nhận chức năng thực sự được lấy và cách hệ thống tìm trên chức năng ấy[7].
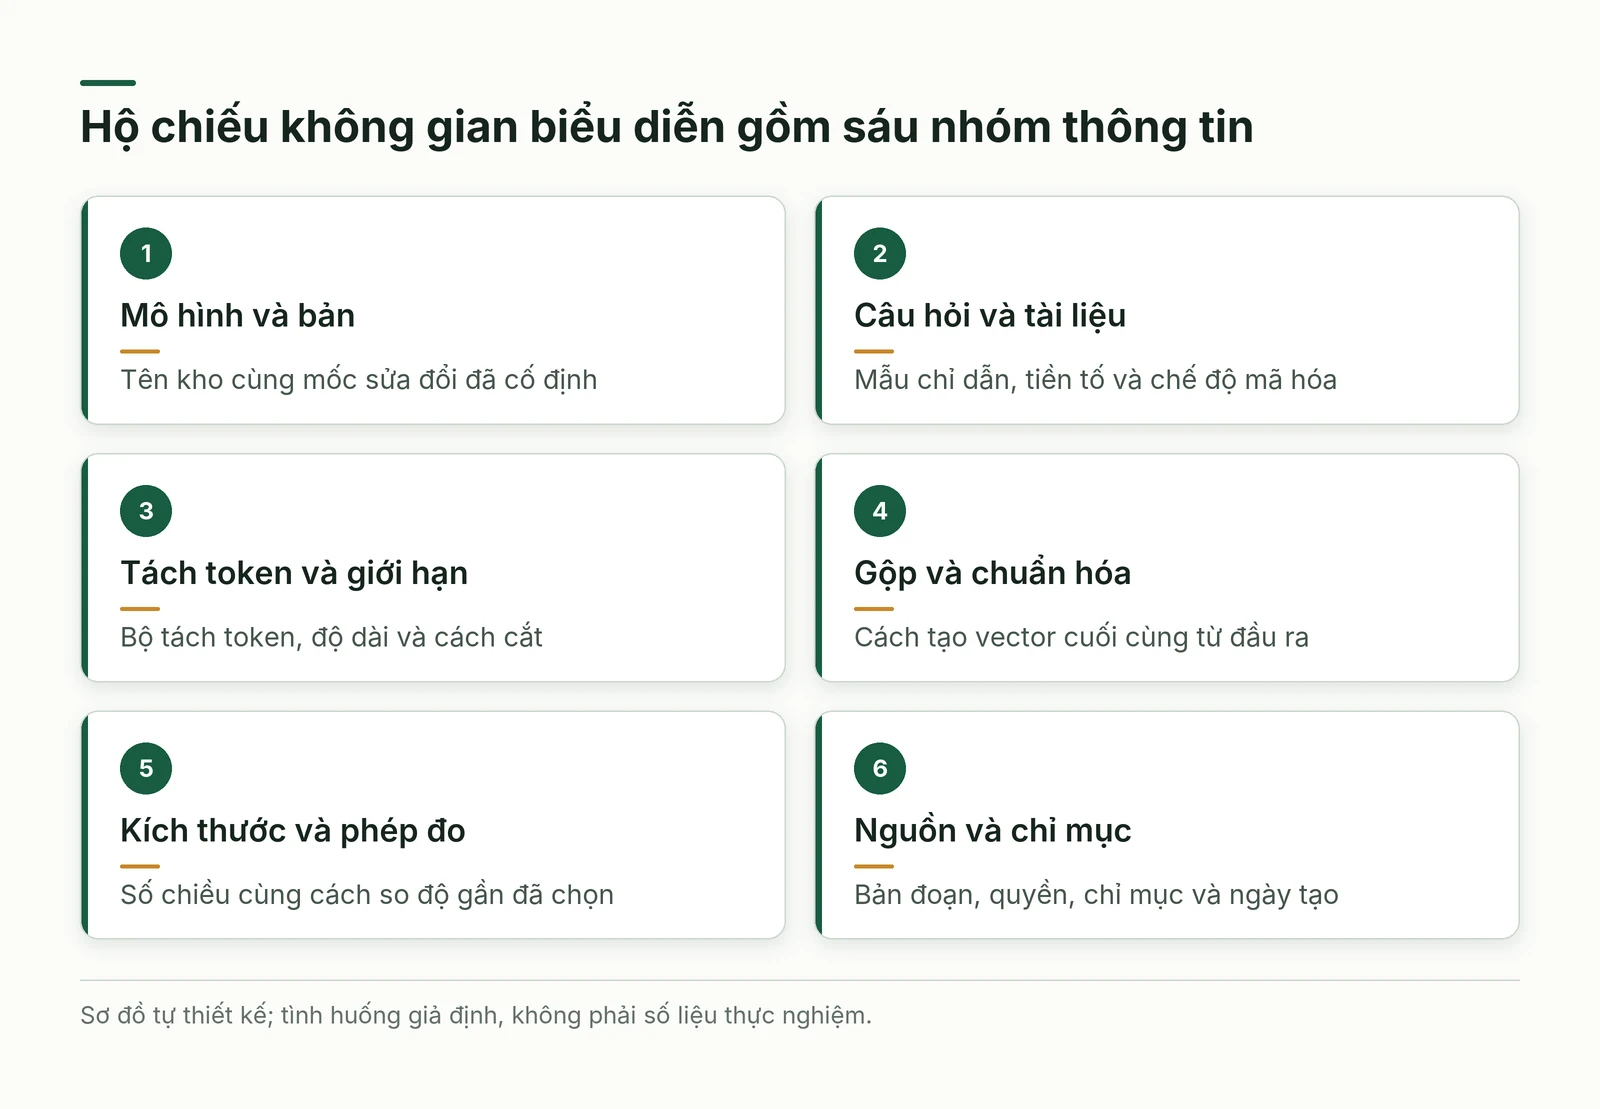
Hộ chiếu không gian biểu diễn nên có sáu nhóm: mô hình và bản sửa đổi; cấu hình câu hỏi và tài liệu; bộ tách token cùng giới hạn; cách gộp và chuẩn hóa; kích thước cùng phép đo; bản nguồn và chỉ mục. Nhóm cuối giữ liên hệ từ vector về đoạn gốc, quyền và thời điểm tạo. Đây là biểu mẫu đề xuất, không phải định dạng chuẩn bắt buộc. Mục đích là giúp người khác tái kiểm và nhận ra phần nào đã đổi giữa hai lần thử.
Cùng số chiều không bảo đảm hai vector cùng ý nghĩa. Một mô hình khác hoặc cách gộp khác có thể đặt nội dung vào một không gian khác dù dữ liệu vẫn vừa trường lưu trữ. Do đó, thay mô hình cho câu hỏi trong khi tài liệu còn vector của cấu hình cũ cần được coi là tình huống phải kiểm, không phải nâng cấp vô hại. Cấu hình query và document có thể khác nhau theo thiết kế mô hình, nhưng phải tương thích trong cùng hệ biểu diễn đã được thử.
Phiếu cặp chứng cứ phải có cả đoạn dễ nhầm
Mỗi phiếu bắt đầu bằng câu hỏi nguyên bản, chiều ngôn ngữ và việc người hỏi muốn làm. Tiếp theo là đoạn nguồn đúng có vị trí và lý do nó phù hợp, cùng điều kiện phải nhìn thấy. Phiếu giữ ít nhất một loại đoạn dễ nhầm do người nghiệp vụ chọn: cùng chủ đề nhưng khác gói, khác phủ định, khác mã hoặc khác bản. Mục tiêu không phải tạo bẫy ngôn ngữ tùy tiện; đó là tái hiện sự phân biệt mà công việc thật đang cần.
Nếu người dùng thường viết tiếng Việt xen thuật ngữ Anh, nên giữ cách viết ấy trong bộ thử thay vì dịch mọi câu thành văn trau chuốt. Thêm các biến thể có người kiểm nghĩa để xem hệ thống có ổn định trước cách nói phổ biến. Người tạo câu và người chấm nên tránh chỉ dựa vào câu chữ mô hình đã sinh. Có thể dùng AI hỗ trợ nháp biến thể, nhưng cần nhân viên xác nhận ý định và phần căn cứ trước khi đưa vào tập chấm chính thức.
Phiếu cũng phải có kết quả mong đợi khi kho thiếu câu trả lời. Một câu hỏi nằm ngoài phạm vi tài liệu được phép không nên bị buộc ghép với đoạn gần nhất. Trong hệ thống truy hồi, phép đo có thể vẫn trả về ứng viên; hành vi bàn giao cần nói rõ chưa đủ nguồn và giữ quyền. Bộ thử bỏ nhóm này sẽ khó cho thấy mô hình có kéo tài liệu xa chủ đề vào chỗ trống và khiến người soạn dự thảo hiểu nhầm hay không.
Kiểm phủ định, số và mã bằng cặp thay đổi có chủ đích
Trong kho dịch vụ giả định, hai đoạn “bao gồm hỗ trợ ngoài giờ” và “không bao gồm hỗ trợ ngoài giờ” là cặp quan trọng. Chúng giống nhiều từ nhưng khác điều kiện. Bộ thử nên ghi đoạn nào liên quan tới gói đang hỏi, rồi xem hai đoạn xuất hiện ở đâu. Không chỉ hỏi vector có nhận biết một từ phủ định; cần kiểm cả hệ thống giữ mã gói và phần nguồn khi chuyển ứng viên cho nhân viên đọc, để tránh gán sai điều kiện.
Với số và đơn vị, dùng ví dụ giả lập do chủ nghiệp vụ duyệt, không lấy ngẫu nhiên giá trị kỹ thuật để tạo chỉ dẫn sử dụng thiết bị. Mục đích là xem thay một số hoặc đơn vị có khiến hệ thống nhầm tài liệu của cấu hình khác. Khi dữ liệu nguồn có bảng, giữ cả tên cột và chú thích cần thiết. Nếu bản trích xuất đã làm mất quan hệ giữa số và đối tượng, đổi embedding có thể không sửa được lỗi; cần quay lại khâu chuẩn bị tài liệu.
Tên riêng và mã gói nên có phép đối chiếu dựa trên trường quản lý, không chỉ độ gần câu. Khi mô hình tìm được một bản mô tả chung hữu ích nhưng thiếu mã, kết quả ấy được ghi là nguồn bổ sung chưa đủ xác nhận. Cách chấm này làm rõ “có liên quan” và “đủ để dùng”. Nó giúp đội lựa chọn tránh loại bỏ nguồn hữu ích, đồng thời ngăn một đoạn chung được tính như câu trả lời hoàn chỉnh cho điều kiện riêng.
Ca giả định: tìm điều kiện hỗ trợ từ tài liệu song ngữ
Giả sử nhân viên hỏi bằng tiếng Việt về phạm vi hỗ trợ của một gói, trong khi bản mô tả cập nhật ở tiếng Anh và bản tóm tắt tiếng Việt chưa bổ sung ngoại lệ mới. Bộ thử cần xác nhận hệ thống tìm được bản tiếng Anh đúng gói, đồng thời không coi bản tóm tắt cũ là bằng chứng ngang nhau. Nhân viên quản lý tài liệu ghi rõ quan hệ giữa hai bản. Trợ lý dự thảo câu trả lời chỉ dựa vào phần đã kiểm và đánh dấu bản dịch đang chờ đối chiếu.
Sau đó chạy câu hỏi tiếng Anh tìm nguồn tiếng Việt đã được xác nhận tương đương ở một gói khác. Đây là phép thử chiều ngược riêng, không dùng kết quả trước để suy ra. Thêm câu hỏi xen hai ngôn ngữ và một câu thiếu mã gói; ghi hệ thống có cần hỏi lại không. Một cấu hình tốt trong chiều Việt–Anh có thể chưa đáp ứng các trường hợp này. Kết quả mỗi phiếu cần có ứng viên, vị trí nguồn và nhận xét nghiệp vụ để người khác xem lại.
Khi thử thật, công ty nên đo thời gian người kiểm tìm đến phần căn cứ và số lần phải mở thêm tài liệu, ngoài thứ hạng ứng viên. Đây là đề xuất thu thập, chưa có con số thực nghiệm. Nếu mô hình tìm đoạn đúng nhưng nhân viên không mở được bản gốc hoặc không thấy ngoại lệ xung quanh, công việc vẫn chưa được hỗ trợ trọn vẹn. Cần ghi lỗi giao diện hay thiếu ngữ cảnh riêng để không quy mọi bất tiện thành lỗi chất lượng embedding.
Đổi mô hình cần lập lại và kiểm chỉ mục có kiểm soát
Tài liệu Hugging Face Hub cho phép tải theo một bản sửa đổi cụ thể, như nhánh, thẻ hoặc mã commit đầy đủ; mặc định có thể lấy bản mới nhất trên nhánh chính. Điều này cung cấp cơ chế giữ mốc thành phần để tái lập. Tên kho đơn thuần không bảo đảm lần tải sau giống lần trước. Trong đề xuất vận hành, bản mô hình, tokenizer và cấu hình liên quan cần được lưu cùng kết quả thử; bài chưa tải trọng số hay chạy thư viện[8].
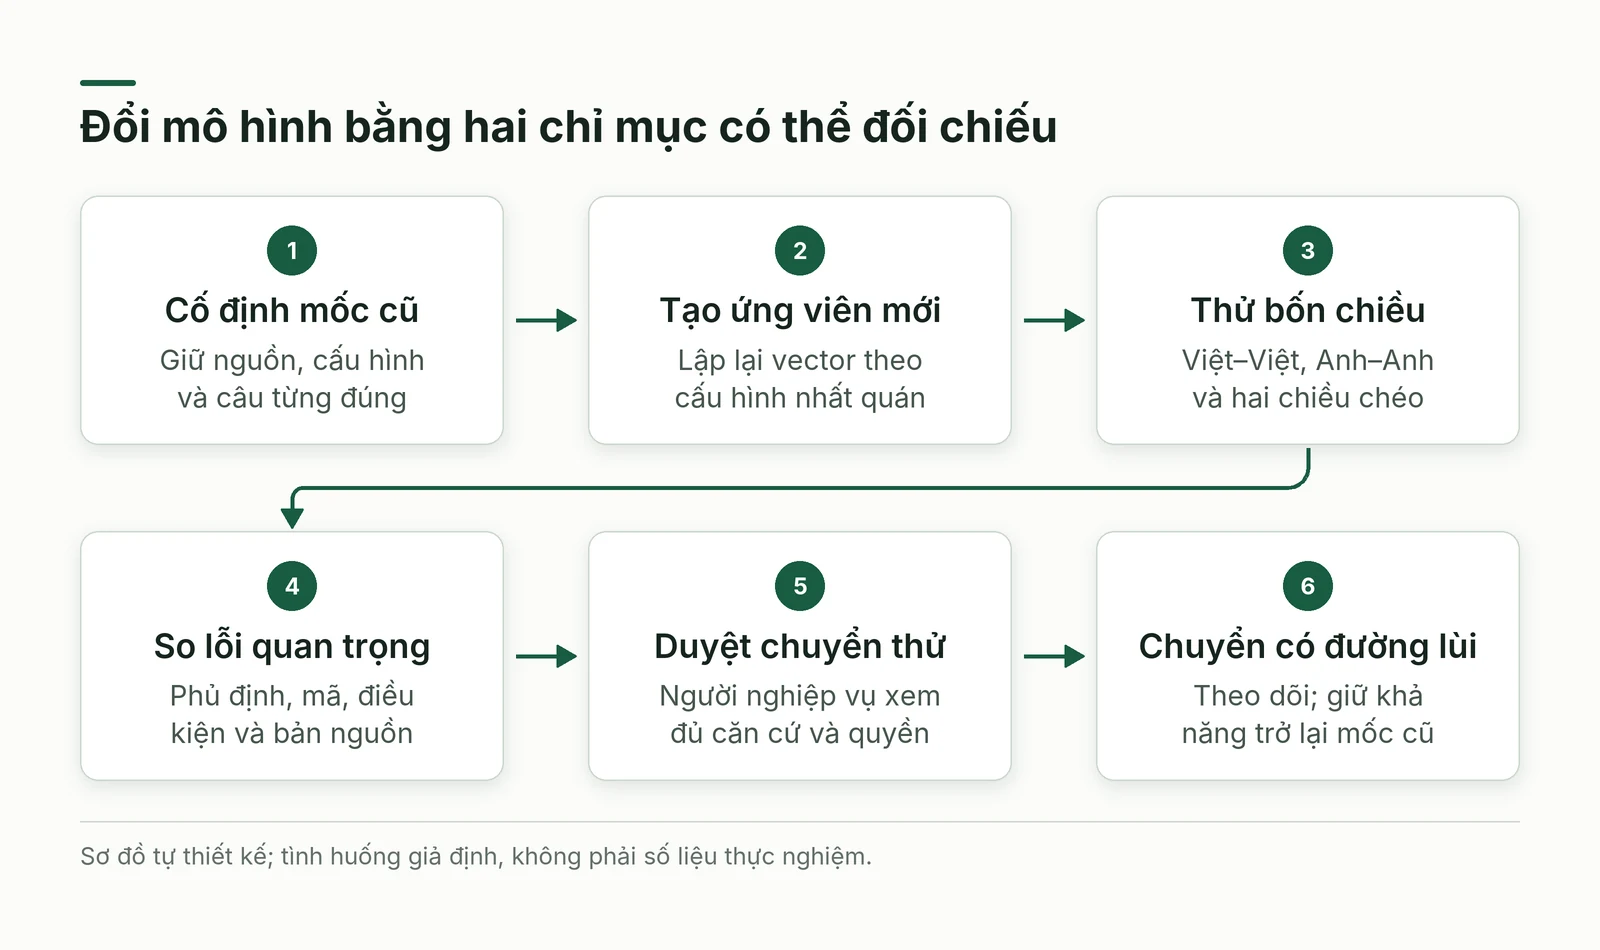
Khi đổi cấu hình biểu diễn, tạo chỉ mục ứng viên riêng từ bản nguồn đã xác định, rồi mã hóa câu hỏi theo đúng cấu hình tương ứng. Chạy lại bốn chiều ngôn ngữ và các cặp dễ nhầm trên cả mốc cũ lẫn ứng viên mới. Không trộn vector cũ và mới chỉ vì cùng số chiều. Cần kiểm độ đầy đủ của tập tài liệu, quyền và cập nhật phát sinh trong thời gian tạo chỉ mục; chất lượng trên một bản kho cũ chưa đủ để chuyển hệ thống đang dùng.
Biên bản chuyển cần nêu lỗi nào được cải thiện, câu từng đúng nào bị hỏng, chi phí tạo lại và đường quay về mốc trước. Chủ nghiệp vụ xác nhận căn cứ đủ dùng; kỹ thuật xác nhận cấu hình và trạng thái chỉ mục; người quản lý dữ liệu xác nhận quyền và phiên bản. Nếu chưa giải quyết được nhầm phủ định hoặc mất tài liệu trong một chiều quan trọng, giữ phạm vi thử hẹp. Không bắt người dùng chịu kết quả chưa kiểm chỉ vì ứng viên mới có điểm benchmark cao hơn.
Hỏi đáp về embedding và tài liệu Việt–Anh
Mô hình hỗ trợ tiếng Việt có tự tìm tốt tài liệu tiếng Anh không? Chưa thể kết luận như vậy. Hãy kiểm câu Việt tìm Anh và chiều ngược lại bằng nguồn đúng công việc, đồng thời tách chúng khỏi phép tìm cùng ngôn ngữ. Cần biết hai bản tài liệu có thực sự tương đương và còn áp dụng hay không. Một kết quả tốt ở bộ câu dịch hoặc benchmark đơn ngữ chỉ là thông tin tham khảo; nó không thay phép kiểm câu hỏi ngắn với điều kiện riêng trong kho doanh nghiệp.
Có thể giữ vector tài liệu khi đổi mô hình cùng số chiều không? Không nên mặc định làm vậy. Số chiều chỉ cho biết kích thước biểu diễn, không chứng minh hai không gian tương thích. Cần giữ cấu hình cũ, tạo chỉ mục ứng viên và mã hóa câu hỏi theo cách tương ứng rồi đối chiếu. Nếu bên phát triển có một cơ chế tương thích riêng, vẫn phải đọc đúng tài liệu và thử trong phạm vi cần dùng. Không xem việc hệ thống nhận dữ liệu mà không báo lỗi là bằng chứng tìm đúng.
Điểm độ gần cao có chứng minh hai câu cùng điều kiện không? Không, cần xem nội dung, đối tượng và bản nguồn. Hai câu chỉ khác phủ định hoặc mã gói có thể gần nhau về chủ đề nhưng đưa tới quyết định khác. Bộ thử nên giữ những cặp này và yêu cầu người nghiệp vụ xác nhận nhãn. Độ gần giúp lựa chọn ứng viên để đọc; việc điều kiện có áp dụng cần căn cứ đủ và quy trình kiểm riêng trước khi nhân viên cam kết với khách hàng.
Doanh nghiệp ít tài liệu có cần chọn mô hình lớn nhất không? Không có cơ sở chung để quyết định theo kích thước. Trước tiên thử một vài cấu hình có tài liệu hướng dẫn rõ trên các câu quan trọng, giữ kết quả theo chiều ngôn ngữ và lỗi dễ nhầm. Xem thêm thời gian chờ, công sức tạo lại chỉ mục và khả năng vận hành. Một lựa chọn dễ kiểm và đáp ứng phạm vi đã giao có thể phù hợp hơn lựa chọn phức tạp mà nhóm không giữ được phiên bản hoặc nguồn.
Nguồn, phương pháp và giới hạn suy luận
Bài được biên soạn có hỗ trợ AI, dựa trên tám nguồn gốc đọc ngày 27/10/2026 trong phạm vi ghi ở hồ sơ nguồn. Bốn nghiên cứu được đọc theo các phần phương pháp đã nêu, không tuyên bố đọc mọi phụ lục hoặc tái lập kết quả. E5 và M3 có nguồn gốc từ bên tạo mô hình; model card là thông tin do tác giả cung cấp. Hộ chiếu, phiếu cặp chứng cứ và công ty dịch vụ là đề xuất giả định, chưa chạy API, tải trọng số, đo tại doanh nghiệp hoặc được chuyên gia thẩm định; không cam kết hiệu quả hay quyền pháp lý với dữ liệu huấn luyện.