WeKnora: nền tảng tri thức RAG, agent và wiki của Tencent cho doanh nghiệp
Đăng ngày 12/10/2026
Mục lục bài nghiên cứu
WeKnora gói RAG, agent và wiki trên cùng một kho tài liệu
WeKnora là framework tri thức mã nguồn mở do Tencent phát hành, dùng LLM để hiểu tài liệu doanh nghiệp, tìm kiếm ngữ nghĩa và suy luận [1]. Ba chế độ dùng chung một kho: RAG để tra cứu có trích dẫn, agent để làm việc nhiều bước với công cụ, wiki để tổ chức tri thức thành các trang liên kết [1].
Đây không phải một thư viện mà là cả hệ thống: dịch vụ Go chính, giao diện web, dịch vụ phân tích tài liệu viết bằng Python, PostgreSQL và Redis [2], kèm không gian làm việc nhiều vai trò, API key theo năng lực và nhật ký kiểm toán [7]. Nó hợp với tổ chức cần một cổng tri thức dùng chung hơn là nhóm chỉ muốn nhúng chức năng tìm kiếm vào ứng dụng sẵn có.
Khuyến nghị: cân nhắc WeKnora khi có kho tài liệu lớn, nhiều phòng ban và đủ năng lực vận hành container. Nên tránh nếu chỉ hỏi đáp trên vài chục tệp hoặc bắt buộc giao diện tiếng Việt, vì giao diện hiện có tiếng Trung, Anh, Nhật, Hàn và Nga [1].
Tài liệu phân tán và câu trả lời không truy được nguồn
Tri thức vận hành thường nằm trong PDF bản scan, bảng Excel, wiki nội bộ và các nhóm chat. Tìm theo từ khóa bỏ sót cách diễn đạt khác; chatbot tổng quát trả lời trôi chảy nhưng khó chỉ ra đoạn nào chống lưng cho câu trả lời.
WeKnora xử lý bằng một chuỗi đầy đủ: phân tích tài liệu thành Markdown và ảnh, cắt đoạn, tạo vector cùng chỉ mục BM25; lúc hỏi thì viết lại câu hỏi, tìm song song, xếp hạng lại, hợp nhất và sinh câu trả lời kèm trích dẫn [2][4]. Dữ liệu còn có thể tự đồng bộ từ Feishu, Confluence, GitLab, Notion và nhiều nguồn khác [1].
Bài toán thứ hai là quyền truy cập: kỹ thuật, kinh doanh và chăm sóc khách hàng không nên thấy cùng một tập tài liệu. Tài liệu dự án coi không gian làm việc là ranh giới tài nguyên và quyền, còn tổ chức là cầu nối để chia sẻ kho giữa các không gian [7].
Ba tiến trình lõi, PostgreSQL, Redis và các thành phần cắm thêm
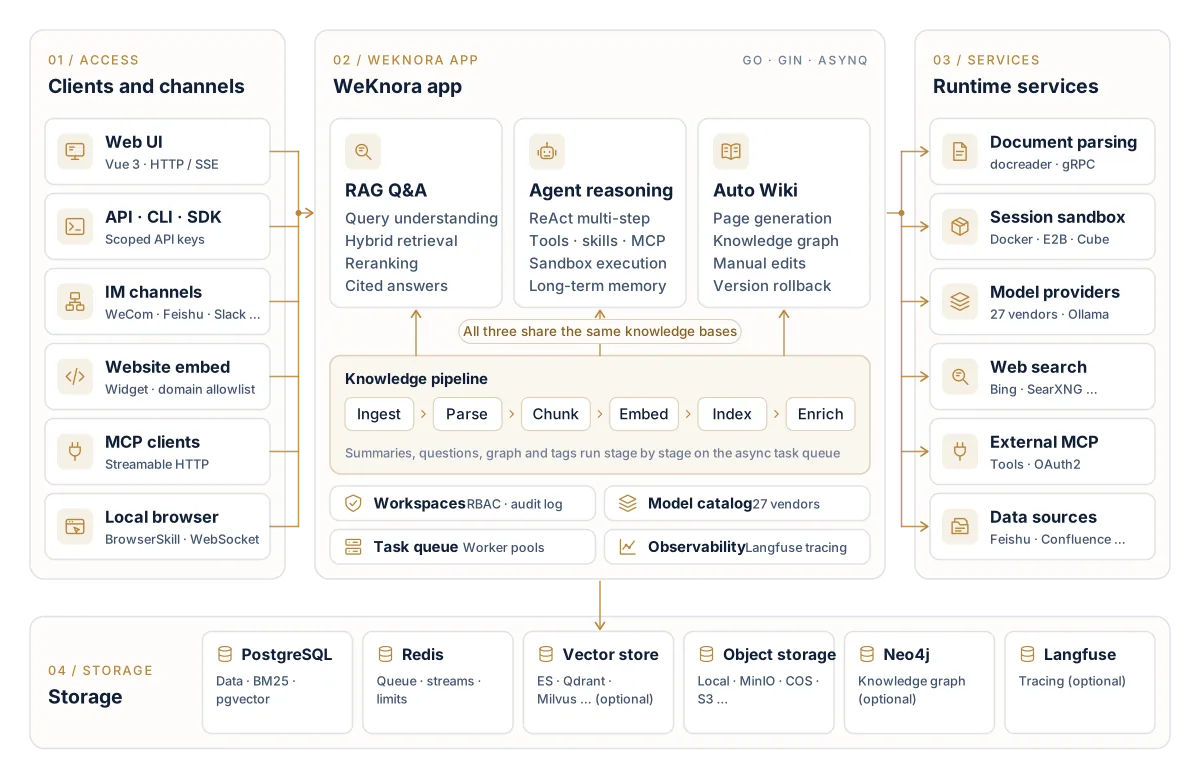
Lõi gồm ba tiến trình: app viết bằng Go lo REST API, truy xuất RAG, bộ máy agent và worker tác vụ nền; frontend là Nginx phục vụ giao diện Vue 3 và chuyển tiếp /api; docreader là dịch vụ gRPC bằng Python phân tích hơn 25 định dạng [2]. Hạ tầng bắt buộc là PostgreSQL bản ParadeDB, vốn có sẵn BM25 và pgvector nên mặc định không cần vector database riêng, cùng Redis cho hàng đợi Asynq, luồng sự kiện và giới hạn tốc độ [2].
Các thành phần khác bật theo profile Docker Compose: Neo4j cho GraphRAG, MinIO cho lưu trữ đối tượng, Qdrant, Milvus hay Weaviate làm vector store riêng, SearXNG cho tìm kiếm web, Langfuse cho quan sát; ngoài ra còn bản Lite, Helm chart và bản desktop [2].
Bên trong dịch vụ Go là các lớp Handler, Service, Repository và hạ tầng, nối qua interface và lắp bằng thư viện tiêm phụ thuộc uber/dig; worker Asynq chạy chung tiến trình với máy chủ HTTP và dùng lại cùng các service [3]. Có hay không có REDIS_ADDR quyết định hình thái chạy: có Redis thì dùng sáu nhóm worker Asynq, không có thì chuyển sang bộ thực thi đồng bộ trong tiến trình [3].
Từ tệp tải lên tới câu trả lời có trích dẫn qua hàng đợi và chuỗi plugin
Khi tải tệp, yêu cầu đi qua middleware xác thực JWT hoặc API key và RBAC; service ghi bản ghi tài liệu ở trạng thái pending, đẩy tác vụ document:process vào Redis rồi trả mã tài liệu ngay [2]. Worker gọi docreader qua gRPC để lấy Markdown và ảnh, cắt đoạn, tạo embedding theo lô, ghi chỉ mục vector và BM25, rồi xếp hàng các tác vụ làm giàu như tóm tắt, sinh câu hỏi, trích đồ thị; tài liệu chỉ sang completed khi số tác vụ con về 0 [2].
Chiều hỏi đáp là chuỗi plugin hướng sự kiện: nạp lịch sử, gọi lại trí nhớ dài hạn, viết lại câu hỏi và phân loại ý định, tìm song song đoạn văn và thực thể đồ thị, xếp hạng lại, hợp nhất, cắt top K, lắp ngữ cảnh rồi sinh câu trả lời dạng luồng; lấy trang web và phân tích DuckDB là bước tùy chọn [4]. Điểm cuối là tổ hợp 0,6 điểm mô hình rerank, 0,3 điểm truy xuất và 0,1 trọng số nguồn, sau đó chọn đa dạng bằng MMR [4].
Câu trả lời không ghi thẳng vào HTTP mà qua EventBus của từng yêu cầu tới StreamManager trong bộ nhớ hoặc Redis, nên client rớt mạng có thể nối lại và phát lại sự kiện [4]. Trích dẫn dùng bí danh theo yêu cầu thay cho mã nội bộ, và bí danh lạ trong đầu ra mô hình bị xóa theo nguyên tắc fail-closed [4].
Các khả năng đã đối chiếu trong README và tài liệu kiến trúc
README liệt kê kho FAQ, tài liệu và wiki; chỉnh sửa đoạn có lịch sử phiên bản; tìm kiếm lai từ khóa và vector, rerank, chia đoạn cha con, GraphRAG với Neo4j; đánh giá đầu cuối bằng recall, BLEU, ROUGE; agent ReAct dùng kho tri thức, tìm kiếm web, công cụ MCP, skill và trình duyệt cục bộ; trí nhớ dài hạn xuyên phiên; máy chủ MCP tích hợp theo từng không gian, CLI cho agent và widget nhúng website [1].
Phần vận hành có bảng điều khiển hàng đợi, bảng dead letter lưu lỗi sau lần thử cuối, tác vụ dọn dẹp mỗi 5 phút để đánh dấu tài liệu bị kẹt, và trace Langfuse cho từng tác vụ nền [5]. Mô hình có thể đến từ nhiều nhà cung cấp, trong đó có Ollama, DeepSeek, Qwen, OpenAI và LiteLLM [1].
Cần tách các mục khác trạng thái. Ứng dụng desktop chưa có bộ cài phát hành và phải tự build [6]; máy chủ MCP viết bằng Python trong mcp-server/ đã bị đánh dấu ngừng dùng; WeChat Dialog Open Platform là dịch vụ trực tuyến xây trên WeKnora, khác bản tự lưu trữ [1]. Số nhà cung cấp mô hình cũng chưa thống nhất: phần tổng quan README ghi 29, ghi chú v0.8.2 và tài liệu kiến trúc ghi 27 [1][2].
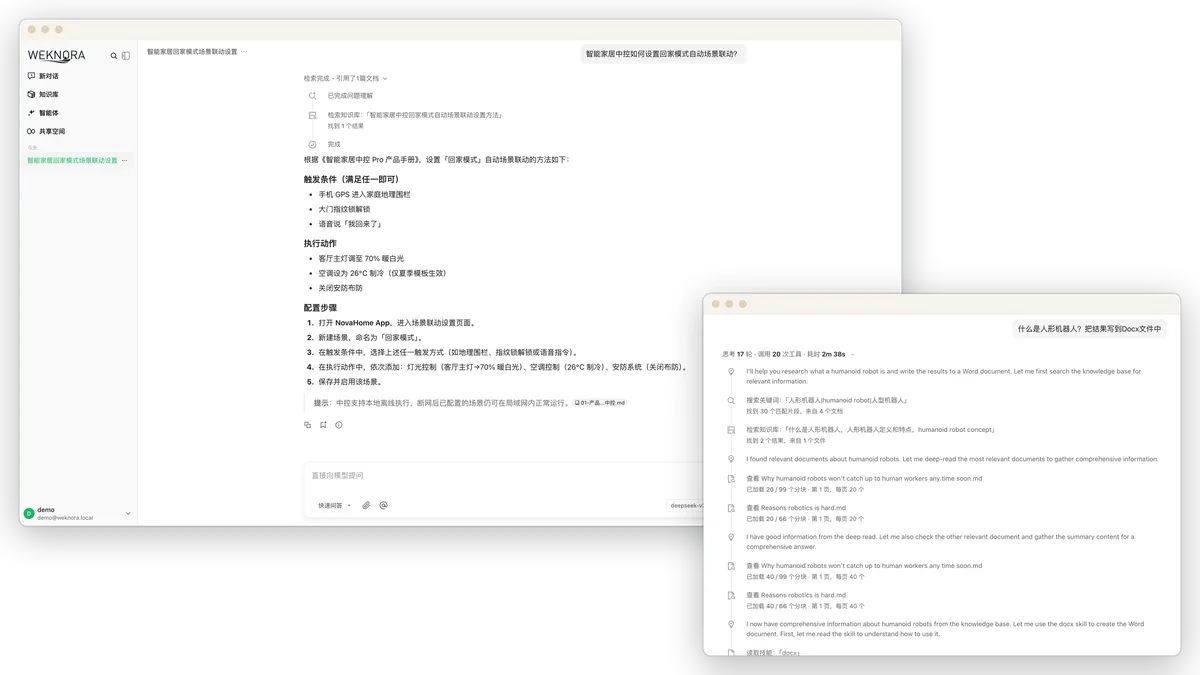
Doanh nghiệp có kho tài liệu lớn và nhu cầu phân quyền theo nhóm
WeKnora hợp với tổ chức có nhiều loại tài liệu và nhiều nhóm người dùng, cần vai trò Owner, Admin, Contributor, Viewer cùng quyền sở hữu theo tài nguyên [7], và muốn đưa hỏi đáp vào kênh làm việc như Slack, Telegram hay Mattermost [1].
Đội kỹ thuật quen Docker hoặc Kubernetes sẽ vận hành dễ hơn, vì sự cố thường nằm ở hàng đợi, docreader hay cơ sở dữ liệu [5][6]. Hệ sinh thái tích hợp hiện thiên về nền tảng Trung Quốc, từ nguồn dữ liệu Feishu, Yuque, DingTalk tới kênh WeCom, QQBot [1].
Không phù hợp với cá nhân chỉ cần trợ lý ghi chú, hoặc doanh nghiệp không có ai lo cập nhật bảo mật định kỳ như README khuyến cáo [1]. Doanh nghiệp nhỏ muốn thử một “bộ não số” nội bộ có thể bắt đầu bằng bản Lite một tệp nhị phân [6] trước khi dựng cụm đầy đủ.
Tiếng Việt trong một nền tảng mặc định zh-CN
Ngôn ngữ xử lý tài liệu được chọn theo thứ tự biến WEKNORA_LANGUAGE, tiêu đề Accept-Language của trình duyệt, rồi mặc định zh-CN [3]; các mẫu prompt có chỗ giữ {language} [4]. Bộ nguồn không cho biết đã có mẫu tiếng Việt hay chưa, nên cần kiểm tra trước khi tin câu trả lời luôn bằng tiếng Việt.
Tìm kiếm từ khóa được thiết kế với tiếng Trung làm trọng tâm: bảng so sánh engine có hẳn cột tách từ tiếng Trung, bản Lite tách bigram “thân thiện với tiếng Trung”, Milvus chọn analyzer english, chinese hoặc default theo ngôn ngữ [8], còn bước mở rộng truy vấn dùng jieba cho chuỗi chữ Hán [4]. Tiếng Việt tách âm tiết bằng dấu cách, nên từ ghép như “biến tần” có thể bị cắt đôi; đây là giả thuyết cần đo, chưa phải kết luận.
Với tài liệu scan, docreader không tự OCR: trang scan được kết xuất thành ảnh, rồi mô hình thị giác hoặc PaddleOCR-VL cấu hình ở phía Go đọc chữ [9]. Chất lượng nhận dấu tiếng Việt vì vậy phụ thuộc hoàn toàn vào mô hình được chọn.
Đề xuất cho công ty điện mặt trời áp mái: kỹ thuật, kinh doanh và bảo hành dùng chung tri thức
Tình huống giả định: một công ty lắp điện mặt trời áp mái ở miền Trung có đội khảo sát, thiết kế, thi công và bảo hành. Tài liệu gồm datasheet biến tần, tấm pin (nhiều bản tiếng Anh hoặc tiếng Trung), quy trình an toàn trên mái, điều kiện bảo hành, hồ sơ đấu nối và biên bản nghiệm thu dạng scan, cùng bảng Excel sản lượng từng công trình.
Đề xuất chia ba không gian Kỹ thuật, Kinh doanh, Bảo hành, nối bằng một tổ chức để chia sẻ kho datasheet ở quyền đọc; quyền hiệu lực là mức thấp hơn giữa quyền chia sẻ và vai trò trong tổ chức [7]. Kho FAQ giữ câu trả lời chuẩn về bảo hành với chế độ ưu tiên FAQ, còn wiki sinh trang cho từng dòng biến tần, có trích dẫn và rollback [1][4]. Bảng sản lượng được agent phân tích bằng DuckDB, tính năng tắt mặc định và bật theo từng agent [4].
Zalo không có trong danh sách kênh IM được hỗ trợ [1], nên khách hàng đi qua widget nhúng website; tích hợp Zalo, nếu cần, là phần phát triển riêng qua API với khóa chỉ có năng lực tìm kiếm và chat, giới hạn vào kho FAQ [7]. Câu trả lời về thông số an toàn điện phải kèm trích dẫn và được kỹ sư duyệt trước khi dùng ở hiện trường.
Docker Compose, Helm hay Lite và gánh vận hành đi kèm
Bản Docker Compose tiêu chuẩn cần Docker 20.10 trở lên, khởi điểm khuyến nghị 4 lõi CPU và 8 GB RAM vì docreader kèm LibreOffice và Playwright, chưa tính trọng số mô hình Ollama [6]. Trước lần chạy đầu phải điền mật khẩu cơ sở dữ liệu, mật khẩu Redis, JWT_SECRET và SYSTEM_AES_KEY dài đúng 32 byte; khi nâng cấp phải giữ nguyên SYSTEM_AES_KEY, nếu không thông tin xác thực đã mã hóa sẽ không giải mã được [6].
Nâng cấp bằng cách đặt WEKNORA_VERSION rồi kéo image; chỉ chạy docker compose up -d sẽ dùng lại image cũ trong bộ đệm [1]. Helm chart dùng phiên bản ParadeDB khác bản Compose và mặc định giới hạn tệp tải lên 50 MB [6]. Vector store phải chọn trước khi tạo kho, vì liên kết giữa kho và vector store không đổi được sau khi tạo, còn đổi engine đòi lập chỉ mục lại [8].
Về hàng đợi, tài liệu đưa công thức ước lượng số worker bằng tốc độ tác vụ đến lúc cao điểm nhân thời gian thực thi trung bình rồi chia 0,70, đồng thời nhấn mạnh 0,70 chỉ là mức sử dụng mục tiêu ví dụ [5]. Khi log liên tục báo tác vụ còn xếp hàng do backpressure, cần tăng nhóm worker tương ứng chứ không nghi bộ quét bị kẹt [5].
Đăng ký mở mặc định, khóa AES, sandbox chạy root và những cấu hình phải đổi
README khuyến cáo đặt hệ thống trong mạng nội bộ, không phơi trực tiếp ra Internet và cập nhật đều đặn [1]. Chế độ đăng ký mặc định là self_serve, tức ai mở được trang đều tự đăng ký; nên chuyển sang invite_register hoặc invite_only, và nhớ rằng giá trị lưu trong system_settings của cơ sở dữ liệu ghi đè biến DISABLE_REGISTRATION [7].
Các trường nhạy cảm như tham số mô hình, cấu hình vector store và API key được mã hóa AES-256-GCM bằng SYSTEM_AES_KEY [3]; khóa không đủ 32 byte thì mã hóa thực chất bị vô hiệu, hệ thống chỉ cảnh báo lúc khởi động [5]. RBAC bật mặc định nhưng có thể chuyển sang chỉ ghi log khi đặt tenant.enable_rbac=false; API key bị từ chối ở mọi route chưa khai báo chính sách và có thể giới hạn theo danh sách kho [7].
Sandbox Docker tắt mặc định; bật nó đòi gắn docker.sock, tương đương quyền root trên máy chủ [6], và từ v0.8.2 lệnh trong sandbox chạy dưới quyền root [1]. Agent có skill khi được chia sẻ sẽ chạy cùng biến môi trường do quản trị viên đặt, và thành viên có thể khiến agent đọc ra các giá trị như API key [7]. Các profile tùy chọn để mật khẩu mặc định như minioadmin của MinIO hay neo4j/password của Neo4j, phải đổi trước khi dùng [6].
Về dữ liệu, prompt đã ghép ngữ cảnh được lưu kèm tin nhắn để kiểm toán [4], và khi bật LLM_DEBUG_LOG, từng lời gọi LLM được ghi ra tệp, giữ 7 ngày [3]. Trình phân tích PDF có lọc chữ ẩn để chống chèn lệnh qua văn bản ẩn [9], nhưng đó chỉ là một lớp phòng thủ.
MIT cho mã WeKnora, MPL-2.0 và Apache-2.0 cho thành phần bên thứ ba
README ghi dự án theo giấy phép MIT [1], nhưng tệp LICENSE nói chính xác hơn: WeKnora theo MIT trừ các thành phần bên thứ ba được liệt kê, gồm opencc theo Apache-2.0, anydoc đã được Tencent sửa và wails theo MIT; dòng bản quyền ghi Tencent năm 2026 [10]. Đây là lý do không nên kết luận giấy phép từ một dòng tóm tắt.
THIRD_PARTY_NOTICES.md bổ sung hai module Go theo MPL-2.0 là go-sql-driver/mysql và go-m1cpu, mã nguồn tương ứng được kèm trong bản phát hành nhị phân; dữ liệu từ điển OpenCC theo Apache-2.0; mẫu bộ cài Windows dựa trên Wails theo MIT; cbindgen theo MPL-2.0 chỉ dùng khi build [11]. Tệp này yêu cầu giữ nó cùng LICENSE và thư mục licenses/ khi phân phối lại gói backend hoặc desktop [11].
MIT chỉ yêu cầu đưa kèm dòng bản quyền cùng nội dung giấy phép trong mọi bản sao [10], còn MPL-2.0 là copyleft ở mức tệp với các module nêu trên. Hiệu lực của các giấy phép trên chỉ phủ mã tại commit này, không bao trùm WeChat Dialog Open Platform, dịch vụ WeKnora Cloud, mẫu triển khai trên Tencent Cloud [1], mô hình hay dịch vụ OCR bên thứ ba, cũng như dữ liệu tải lên.
Nguồn lực cần dự trù cho máy chủ, mô hình và người vận hành
Về hạ tầng, mốc 4 lõi, 8 GB RAM cho bản Compose [6] sẽ tăng khi bật Milvus, OpenSearch hay Langfuse, và phải cộng phần cứng riêng nếu chạy mô hình qua Ollama. Helm mặc định cấp 10Gi cho Postgres, 1Gi cho Redis, 10Gi cho tệp dữ liệu [6]; mỗi không gian có hạn mức lưu trữ mặc định 10GB [7].
Chi phí mô hình phát sinh ở cả hai chiều. Lúc nạp có embedding cho mọi đoạn cộng các tác vụ làm giàu như tóm tắt, sinh câu hỏi, trích đồ thị, OCR và mô tả ảnh [5]; lúc hỏi có một lần gọi LLM để viết lại câu hỏi và phân loại ý định, một lượt rerank rồi bước sinh câu trả lời [4]. Tài liệu cho phép chỉ định mô hình nhỏ riêng cho bước hiểu truy vấn [4], một đòn bẩy giảm chi phí đáng thử.
Về người, cần một kỹ sư DevOps quen Postgres, Redis và container, một người phụ trách nội dung cho mỗi phòng ban để giữ kho sạch, và một người rà cấu hình bảo mật sau mỗi lần nâng cấp. Đơn giá không được nêu, vì giá thuê máy và giá mô hình biến động theo nhà cung cấp.
Đặt WeKnora cạnh các lựa chọn tự xây và nền tảng RAG khác
Tự xây bằng LangChain hoặc LlamaIndex với một vector database cho quyền kiểm soát tối đa, nhưng phải tự làm phần phân tích tài liệu, hàng đợi, phân quyền và giao diện mà WeKnora đã có sẵn [2][7]. Các nền tảng mã nguồn mở cùng nhóm như RAGFlow, Dify hay AnythingLLM là đối tượng so sánh tự nhiên; chất lượng của chúng nằm ngoài phạm vi bài này.
Những điểm riêng đọc được từ tài liệu WeKnora gồm backend Go chạy chung tiến trình với worker, nhiều engine truy xuất có thể gắn theo từng kho, chuỗi plugin RAG công khai công thức xếp hạng, và phân quyền chi tiết tới năng lực của API key [3][4][7][8]. Đổi lại, số thành phần phải vận hành nhiều hơn hẳn một ứng dụng đơn lẻ.
Khi chọn, nên hỏi: có cần phân quyền nhiều không gian không, tài liệu có nhiều bản scan không, cần tích hợp kênh nào, và khi chấm trên một bộ câu hỏi tiếng Việt chung, phương án nào cho đáp án đúng nhiều hơn.
Những trường hợp WeKnora quá nặng hoặc chưa phù hợp
Tài liệu sản phẩm đầy đủ chủ yếu bằng tiếng Trung, khoảng 360 endpoint API và 150 biến môi trường [1]; đội không đọc được tiếng Trung sẽ tốn thêm công. Thư mục docs/ cũ được ghi là ngừng bảo trì [2], nên dễ gặp hướng dẫn lỗi thời.
Trình phân tích PDF dựng sẵn không nhận dạng cấu trúc bảng, và chữ trên trang scan phụ thuộc hoàn toàn vào OCR phía Go [9]; kho bản vẽ hay bảng thông số phức tạp cần thử engine khác. Ở chế độ Lite, tác vụ không đặt thời hạn sẽ chạy không giới hạn và không có bộ kiểm tra hàng đợi như bản chuẩn [5].
Không nên dùng khi buộc phải phơi dịch vụ ra Internet mà thiếu lớp bảo vệ phía trước, khi cần sẵn kênh Zalo, hoặc khi không có người theo kịp các thay đổi không tương thích ngược, như việc lệnh sandbox chuyển sang chạy root ở v0.8.2 [1].
Lộ trình thử nghiệm tám tuần với bộ câu hỏi kỹ thuật tiếng Việt
Tuần 1 và 2: dựng bản Compose trong mạng nội bộ, đặt khóa bí mật, chuyển đăng ký sang invite_only, xác nhận RBAC đang bật, tạo ba không gian và API key giới hạn. Nạp khoảng 300 tài liệu đại diện, ghi tỷ lệ phân tích thất bại, số trang scan và thời gian xử lý trên bảng tác vụ. Mọi con số trong lộ trình chỉ là tham số khởi điểm, chưa phải kết quả.
Tuần 3 đến 5: kỹ sư soạn 150 câu hỏi tiếng Việt kèm đáp án và tài liệu nguồn, gồm câu có dấu, không dấu, viết tắt và câu hỏi về thông số trong bảng. So sánh cấu hình chỉ vector với cấu hình lai bằng chức năng đánh giá recall, BLEU, ROUGE có sẵn [1], đồng thời chấm tay tỷ lệ câu có trích dẫn đúng và tỷ lệ hệ thống vẫn trả lời khi tài liệu không chứa thông tin.
Tuần 6 đến 8: mở cho một nhóm kỹ thuật và một nhóm bảo hành dùng thật. Dừng nếu có truy cập chéo không gian, nếu trích dẫn sai ở câu hỏi về an toàn điện, hoặc nếu khối lượng vận hành vượt sức đội. Việc mở rộng chờ ba điều kiện: trưởng kỹ thuật ký xác nhận ngưỡng đạt, đã diễn tập sao lưu và khôi phục Postgres, và có quy trình cập nhật bảo mật.
Nhận định cuối về WeKnora
WeKnora là nền tảng tri thức hoàn chỉnh, đi kèm bộ tài liệu thiết kế hiếm khi chi tiết đến vậy, từ trạng thái tác vụ, công thức xếp hạng tới ma trận phân quyền [3][4][5].
Mặt trái là độ phức tạp vận hành và vài mặc định phải đổi trước khi dùng thật, nhất là đăng ký người dùng, khóa mã hóa và sandbox [6][7].
Với doanh nghiệp Việt Nam, ẩn số lớn nhất là chất lượng tiếng Việt ở tìm kiếm từ khóa và OCR. Một thử nghiệm có bộ câu hỏi tiếng Việt và tiêu chí dừng rõ ràng là bước bắt buộc trước khi chọn WeKnora làm cổng tri thức chung.
Phạm vi nguồn, commit và cách đọc tài liệu
Dấu vết chọn đề tài nằm ở bản lưu danh sách GitHub Trending mục Go ngày 12/01/2026: WeKnora ở vị trí thứ sáu, khi đó tự giới thiệu là framework hiểu sâu tài liệu, truy xuất ngữ nghĩa và trả lời theo ngữ cảnh theo mô hình RAG [12]. Kho lưu này chỉ phủ Python, Go, JavaScript, Swift và vắng hai ngày 03/09, 12/10; đề tài được chọn theo tiêu chí biên tập, không theo một Top 100 chính thức nào của GitHub.
Commit được ghim là 089711f92c50ecad782ab95dbce8b04278a9cb35, tạo ngày 12/10/2026, cũng là ngày kiểm tra. Nguồn chính là README, LICENSE và bốn chương kiến trúc về tổng quan, backend, RAG pipeline, tác vụ bất đồng bộ [1][2][3][4][5][10]; nguồn bổ sung là các trang cài đặt, phân quyền, engine truy xuất, phân tích tài liệu và tệp ghi chú bên thứ ba [6][7][8][9][11]. Phần lớn tài liệu gốc viết bằng tiếng Trung; đoạn chuyển ngữ trong bài là diễn giải của người viết.
Toàn bộ nhận định đến từ việc đọc tài liệu với AI trợ giúp, không qua phản biện khoa học, và không có lần cài đặt hay chạy thử WeKnora nào. Kịch bản điện mặt trời, ước lượng nguồn lực và lộ trình thử nghiệm là đề xuất, cần doanh nghiệp tự kiểm chứng.
Xem mã nguồn WeKnora trên GitHub