Whisper của OpenAI: nhận dạng giọng nói đa ngôn ngữ và bài toán phụ đề tiếng Việt
Đăng ngày 12/10/2026
Mục lục bài nghiên cứu
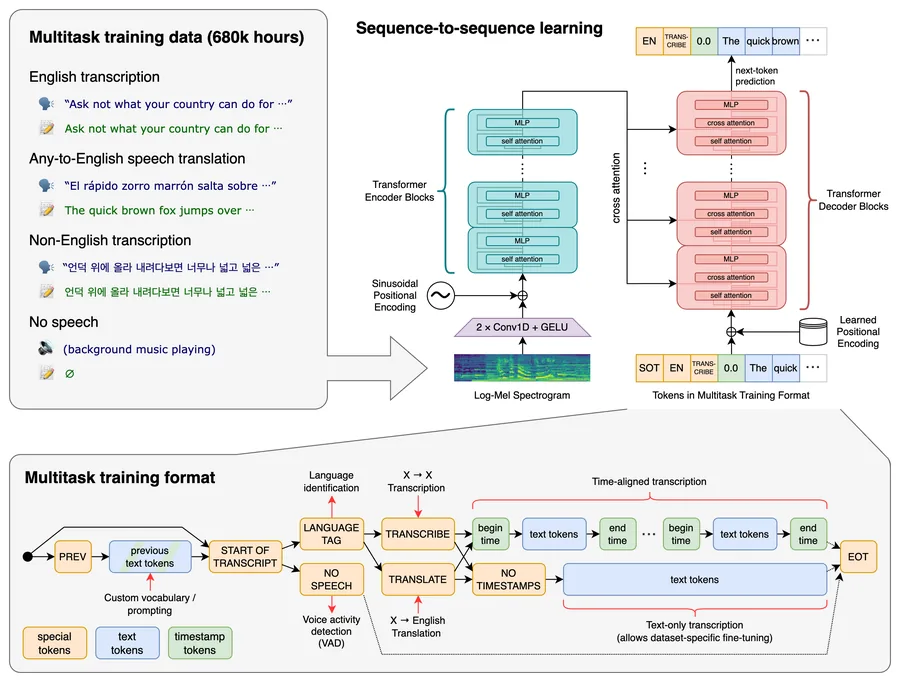
Whisper trong một trang: nhận dạng giọng nói đa ngôn ngữ chạy trên hạ tầng của mình
Whisper là mô hình nhận dạng giọng nói (ASR) đa dụng do OpenAI phát hành cùng mã để chạy mô hình. Một mô hình đa nhiệm đảm nhận cả nhận dạng nhiều ngôn ngữ, dịch lời nói sang tiếng Anh và nhận diện ngôn ngữ [1][3]. Kho cung cấp công cụ dòng lệnh, API Python và sáu cỡ mô hình, từ tiny tới large và turbo [1].
Đáng cân nhắc khi cần chuyển lượng lớn ghi âm, video, cuộc họp thành văn bản mà không gửi dữ liệu ra dịch vụ ngoài. Tiếng Việt có mã riêng trong danh sách ngôn ngữ của tokenizer [7], song model card nhấn mạnh chất lượng không đồng đều giữa các ngôn ngữ và đề nghị đánh giá kỹ trong bối cảnh cụ thể trước khi triển khai [3].
Đừng coi đầu ra của Whisper là sự thật không cần soát lại: mô hình có thể sinh chữ không hề được nói, không phiên âm thời gian thực nếu không có lớp kỹ thuật bổ sung, và không nên dùng cho quyết định rủi ro cao [3]. Cách dùng hợp lý là để Whisper viết bản nháp, còn con người duyệt trước khi công bố.
Từ chuỗi xử lý nhiều khâu đến một mô hình đa nhiệm: Whisper muốn thay điều gì?
Hệ thống nhận dạng giọng nói kiểu cũ thường ghép nhiều khâu riêng: phát hiện có tiếng người, đoán ngôn ngữ, nhận dạng, căn thời gian, rồi dịch. README mô tả Whisper gom các nhiệm vụ ấy thành một chuỗi token để bộ giải mã dự đoán, nhờ đó một mô hình thay được nhiều công đoạn của đường ống truyền thống [1].
Mục tiêu thứ hai là độ bền. Theo model card, nhóm phát triển xây mô hình để nghiên cứu độ bền của hệ thống xử lý tiếng nói khi huấn luyện bằng giám sát yếu ở quy mô lớn, và báo cáo khả năng chịu giọng địa phương, tiếng ồn nền, thuật ngữ chuyên môn tốt hơn nhiều hệ ASR hiện có [3]. Đó là kết luận của chính nhà phát triển dựa trên bài báo đi kèm, không phải phép đo độc lập.
Với doanh nghiệp Việt Nam, bài toán hẹp và thực dụng hơn: biến giờ ghi âm thành văn bản tra cứu được và phụ đề dùng được, với chi phí và rủi ro dữ liệu nằm trong tầm kiểm soát. Whisper lo phần mô hình; quy trình duyệt, quản lý đồng thuận và lưu trữ vẫn phải tự thiết kế.
Bên trong Whisper: Transformer chuỗi sang chuỗi và hệ token đặc biệt
Lõi của Whisper là một mô hình Transformer chuỗi sang chuỗi (sequence-to-sequence), trong đó bộ giải mã sinh lần lượt từng token đầu ra [1]. Mô hình được huấn luyện đồng thời cho nhận dạng đa ngôn ngữ, dịch sang tiếng Anh, nhận diện ngôn ngữ nói và phát hiện hoạt động giọng nói; các token đặc biệt đóng vai chỉ định nhiệm vụ hoặc làm mục tiêu phân loại [1].
Tệp tokenizer.py cho thấy hệ token đó cụ thể ra sao: token mở đầu bản ghi, một token cho mỗi ngôn ngữ, hai token nhiệm vụ transcribe và translate, các token nospeech, notimestamps, startofprev, cùng dãy token thời gian theo bước 0,02 giây [7]. Văn bản được mã hóa bằng thư viện tiktoken, với bảng mã đa ngôn ngữ tách khỏi bảng mã chỉ dùng cho tiếng Anh [7].
Họ mô hình gồm tiny 39 triệu, base 74 triệu, small 244 triệu, medium 769 triệu và large 1.550 triệu tham số; bốn cỡ nhỏ có thêm bản chỉ tiếng Anh, còn turbo là phiên bản tối ưu của large-v3 [1]. README ghi turbo có 809 triệu tham số, model card lại ghi 798 triệu [1][3]; chênh lệch nhỏ nhưng nhắc rằng thông số nên được kiểm tra trực tiếp khi lập kế hoạch tài nguyên.
Một tệp âm thanh đi qua Whisper: ffmpeg, phổ log-Mel, cửa sổ 30 giây
Âm thanh được giải mã nhờ công cụ dòng lệnh ffmpeg cài trên máy [1]; CHANGELOG cho biết dự án đã bỏ thư viện trung gian ffmpeg-python để gọi thẳng ffmpeg [5]. Hàm transcribe() đọc toàn bộ tệp rồi xử lý bằng cửa sổ trượt 30 giây, dự đoán tự hồi quy trên từng cửa sổ [1].
Ở mức thấp, README minh họa chuỗi bước: nạp âm thanh, cắt hoặc đệm về đúng 30 giây, tính phổ log-Mel với số kênh Mel theo cấu hình mô hình, chuyển lên thiết bị của mô hình, nhận diện ngôn ngữ, rồi giải mã theo DecodingOptions [1]. CHANGELOG ghi rằng số kênh Mel nay có thể là 128 [5].
Đầu ra là văn bản cùng các đoạn có mốc thời gian. CHANGELOG ghi nhận dấu thời gian mức từ, tùy chọn định dạng đầu ra, định dạng TSV tính bằng mili giây, và các tùy chọn phụ đề theo số từ, độ rộng dòng, số dòng [5]. Lần chạy đầu, trọng số được tải về và lưu đệm; có mục sửa lỗi để tôn trọng biến XDG_CACHE_HOME cho thư mục tải [5]. Với dữ liệu nhạy cảm, nên nạp sẵn trọng số vào máy nội bộ để luồng xử lý không phụ thuộc Internet.
Những gì README, CHANGELOG và mã nguồn xác nhận
Từ README: lệnh whisper nhận nhiều tệp cùng lúc, cho chọn mô hình, ngôn ngữ và nhiệm vụ transcribe hoặc translate; API Python có load_model, transcribe, detect_language và decode [1]. Mặc định dòng lệnh dùng turbo; turbo không được huấn luyện cho dịch và vẫn trả về ngôn ngữ gốc khi được yêu cầu dịch [1].
CHANGELOG cho thấy tính năng được bổ sung dần: dấu thời gian mức từ trong transcribe() ở bản v20230306, đầu ra TSV và tùy chọn output_format ở v20230124, giới hạn độ rộng và số dòng phụ đề ở v20230918, mô hình large-v3 ở v20231106, large-v3-turbo và việc dùng SDPA khi có ở v20240930, bỏ qua khoảng lặng quanh đoạn ảo giác ở v20240927, tùy chọn mang initial_prompt qua cửa sổ trượt ở v20250625 [5].
Về an toàn, v20250625 chuyển torch.load sang weights_only=True, còn v20231105 nạp ma trận Mel với allow_pickle=False [5]. Phụ thuộc khai báo gồm numba, numpy, torch, tqdm, more-itertools, tiktoken và triton trên Linux x86_64 [6]. Cần tách bạch: phân loại hay phân tách người nói (diarization) chỉ được model card nhắc như năng lực có thể có sau tinh chỉnh; ngay cả phát hiện hoạt động giọng nói, dù README xếp vào nhiệm vụ huấn luyện, cũng nằm trong nhóm model card nói chưa được đánh giá chặt [1][3].
Tiếng Việt: có mã ngôn ngữ "vi", còn chất lượng phải tự đo
Bảng LANGUAGES trong tokenizer.py có mục "vi" ứng với tiếng Việt, nên người dùng có thể chỉ định ngôn ngữ thay vì để mô hình tự đoán [7]. Model card cho biết 17% dữ liệu huấn luyện, khoảng 117.000 giờ, là âm thanh không phải tiếng Anh kèm bản ghi cùng ngôn ngữ, trải trên 98 ngôn ngữ, và chất lượng của mỗi ngôn ngữ tương quan trực tiếp với lượng dữ liệu dành cho nó [3].
Các nguồn văn bản đã đọc không nêu con số riêng cho tiếng Việt. README chỉ đưa một biểu đồ WER và CER theo ngôn ngữ của large-v3 và large-v2 trên Common Voice 15 và Fleurs, kèm dẫn chiếu tới phụ lục bài báo [1]. Bài này không trích số từ biểu đồ, nên mọi kỳ vọng về độ chính xác tiếng Việt phải được đo lại trên âm thanh thật, có đủ giọng ba miền và thuật ngữ của ngành.
Một chi tiết đáng chú ý: tokenizer tách "từ" theo khoảng trắng với đa số ngôn ngữ, chỉ tách theo ký tự Unicode với nhóm tiếng Trung, Nhật, Thái, Lào, Miến Điện và Quảng Đông [7]. Vì chữ Việt cách nhau theo âm tiết, có thể suy ra dấu thời gian "mức từ" trên thực tế gắn với từng âm tiết. Tokenizer cũng có danh sách token phi lời nói, như ký hiệu nốt nhạc hay nhãn người nói, để chặn việc sinh ra chữ không thực sự được nói [7].
Whisper hợp với ai: từ phòng nội dung đến hệ tri thức nội bộ
Hưởng lợi rõ nhất là nhóm sản xuất nội dung, đơn vị truyền thông, đào tạo trực tuyến và bộ phận cần lưu biên bản họp, nơi khối lượng âm thanh lớn và bản nháp tự động tiết kiệm nhiều công gõ. Model card đánh giá mô hình có ích cho nhà phát triển xây giải pháp ASR, nhất là với tiếng Anh, và có thể giúp cải thiện các công cụ hỗ trợ tiếp cận (accessibility) [3].
Với các hệ tri thức kiểu "bộ não thứ hai" mà chuỗi bài trên phamvanthu.com quan tâm, Whisper có thể là cửa ngõ đưa ghi âm vào kho văn bản để lập chỉ mục và tìm kiếm. Điều kiện là có người chạy được Python, ffmpeg và quản lý GPU, hoặc chấp nhận tốc độ chậm hơn trên CPU.
Whisper không hợp với tổng đài cần phản hồi tức thì nếu thiếu lớp kỹ thuật bổ sung, vì model card nói mô hình không dùng ngay được cho phiên âm thời gian thực [3]. Nó càng không hợp cho việc suy đoán cảm xúc, giới tính hay đặc điểm con người từ giọng nói, loại sử dụng mà model card gọi thẳng là không phù hợp [3].
Đề xuất cho một agency marketing số: phụ đề và bản ghi tiếng Việt có người duyệt
Tình huống giả định: một agency marketing số ở TP.HCM sản xuất video ngắn, livestream và podcast cho nhãn hàng. Mỗi tuần, đội biên tập phải gõ phụ đề tiếng Việt, trích lời KOL cho bài đăng và lưu bản ghi phỏng vấn để tái sử dụng. Nhiều nội dung thuộc chiến dịch chưa công bố, nằm dưới thỏa thuận bảo mật với khách hàng.
Agency đặt Whisper trên một máy trạm GPU nội bộ. Luồng đề xuất: nhận tệp video, dùng ffmpeg tách âm thanh, chạy Whisper với ngôn ngữ chỉ định là tiếng Việt [7], xuất phụ đề và bản ghi có mốc thời gian [5], rồi đẩy vào hàng chờ biên tập. Danh sách tên thương hiệu và sản phẩm có thể đưa vào initial_prompt [5]; tác dụng của việc này với tên riêng là giả thuyết cần kiểm chứng, chưa phải điều đã biết.
Biên tập viên nghe lại, sửa lỗi, đánh dấu đoạn nghi ảo giác như chữ xuất hiện giữa nhạc nền hay khoảng lặng, rồi mới xuất bản. Bản ghi đã duyệt được lưu vào kho tìm kiếm của agency kèm thông tin đồng thuận của người nói. Turbo phù hợp cho bản nháp nhanh, nhưng muốn dịch lời Việt sang tiếng Anh cho khách hàng quốc tế thì phải chọn mô hình đa ngôn ngữ khác, vì turbo không được huấn luyện cho dịch [1].
Cài đặt và vận hành: ffmpeg, bộ nhớ đệm mô hình và chọn kích thước
Cài qua pip với gói openai-whisper hoặc từ mã nguồn; máy cần có ffmpeg, và có thể cần Rust nếu tiktoken không có bản dựng sẵn cho nền tảng [1]. README ghi mã được kỳ vọng tương thích Python 3.8 đến 3.11, trong khi CHANGELOG bản v20250625 có mục thêm Python 3.13 vào kiểm thử [1][5]; hãy thử trên đúng phiên bản Python sẽ dùng.
Chọn cỡ mô hình theo bộ nhớ: README ước lượng VRAM khoảng 1 GB cho tiny và base, 2 GB cho small, 5 GB cho medium, 6 GB cho turbo và 10 GB cho large; tốc độ tương đối được đo khi chép tiếng Anh trên A100 và thực tế có thể khác nhiều [1]. Theo requirements.txt, Triton chỉ được cài trên Linux x86_64 [6].
Nhịp phát hành chậm: mục mới nhất trong CHANGELOG là v20250625, trong khi commit khảo sát đề ngày 31/08/2026 [5]. Nên ghim phiên bản gói, lưu trọng số đã kiểm tra vào kho nội bộ, và theo dõi thời gian xử lý mỗi giờ âm thanh, tỷ lệ tệp lỗi cùng độ dài hàng chờ biên tập.
Quyền riêng tư và an toàn: đồng thuận, giám sát và chữ "ảo giác"
Lợi thế của tự vận hành là âm thanh không phải rời hạ tầng doanh nghiệp. Dù vậy, model card khuyến cáo không dùng Whisper để chép lại ghi âm của cá nhân khi chưa có sự đồng ý của họ [3]. Với agency, hợp đồng với KOL, khách mời và nhãn hàng cần nêu rõ việc ghi âm, chép lời và lưu trữ; giọng nói và nội dung phỏng vấn có thể là dữ liệu cá nhân theo quy định Việt Nam, nên cần ý kiến pháp lý.
Model card cũng nêu mối lo lưỡng dụng: ASR rẻ và chính xác có thể giúp mở rộng giám sát, và mô hình có thể nhận ra một số cá nhân cụ thể [3]. Hệ thống nội bộ nên giới hạn ai được gửi tệp, ghi nhật ký truy cập, và cấm dùng để theo dõi nhân viên.
Về kỹ thuật, nên dùng bản đã chuyển torch.load sang weights_only=True [5], lấy trọng số từ nguồn đã kiểm tra, và coi tệp media đầu vào là dữ liệu không tin cậy vì ffmpeg phải phân tích chúng [1]; chạy khâu giải mã trong container cách ly là lựa chọn hợp lý. Toàn vẹn nội dung cũng là rủi ro: chữ ảo giác [3] gán sai lời cho người thật có thể gây hại danh tiếng, nên phụ đề chưa qua người duyệt không được xuất bản.
MIT cho mã và trọng số: phạm vi bao trùm và chỗ dừng
LICENSE tại commit khảo sát là giấy phép MIT, bản quyền 2022 thuộc OpenAI, cho phép dùng, sửa, phân phối, cấp phép lại và bán bản sao phần mềm với điều kiện giữ thông báo bản quyền và giấy phép; phần mềm được cung cấp nguyên trạng [2]. README nói rõ cả mã lẫn trọng số mô hình được phát hành theo MIT [1].
Giấy phép này không thay cho điều khoản của các phụ thuộc như PyTorch, tiktoken, numba, Triton [6] hay ffmpeg [1], mỗi thành phần có giấy phép riêng. Các bộ dữ liệu đánh giá liệt kê trong data/README, một số lấy từ danh mục LDC, có điều kiện sử dụng riêng [4]. Model card mô tả 680.000 giờ âm thanh huấn luyện thu thập từ Internet [3], nhưng kho không phân phối dữ liệu đó.
MIT cũng không giải quyết quyền đối với nội dung được chép: bản ghi phỏng vấn thuộc về các bên theo hợp đồng, không do giấy phép phần mềm quyết định. Nếu dùng một API thương mại thay vì tự vận hành, điều khoản của API đó mới là thứ áp dụng, không phải LICENSE của kho này.
Nguồn lực cần tính: GPU, giờ biên tập và bộ kiểm thử
Không có phí giấy phép, nhưng có ba nhóm nguồn lực: phần cứng, nhân sự biên tập và công sức kỹ thuật. Bài không ước tính giá; các giả định dưới đây giúp agency tự lượng hóa.
Phần cứng gồm một máy GPU có VRAM đủ cho cỡ mô hình đã chọn, theo ước lượng của README từ khoảng 1 GB tới 10 GB [1], cùng ổ lưu video gốc, âm thanh tách và bản ghi. Nhân sự gồm một người kỹ thuật bán thời gian dựng và giữ luồng xử lý, cùng biên tập viên duyệt bản nháp; thời gian biên tập cho mỗi phút video là biến chi phí chính và phải được đo.
Chi phí ẩn gồm việc dựng bộ kiểm thử tiếng Việt có đáp án, xử lý tệp hỏng, cập nhật khi PyTorch hoặc Triton đổi phiên bản [6], và rủi ro khi phụ đề sai bị đăng. So với dịch vụ tính tiền theo phút, tự vận hành chuyển chi phí từ biến đổi sang cố định; điểm hòa vốn tùy khối lượng thực tế.
Tự vận hành Whisper hay thuê dịch vụ nhận dạng giọng nói?
Phương án gần nhất là dịch vụ nhận dạng giọng nói đám mây, chẳng hạn Google Cloud Speech-to-Text hay Azure AI Speech, hoặc dịch vụ của nhà cung cấp trong nước: dễ bắt đầu, không phải quản GPU, nhưng âm thanh rời khỏi hạ tầng của agency và chi phí tăng theo khối lượng. Thuê người gõ phụ đề thủ công thì độ chính xác dễ kiểm soát, song chậm và khó mở rộng.
Trong nhánh mã nguồn mở có các dự án tái hiện hoặc tăng tốc Whisper như faster-whisper, whisper.cpp, WhisperX, và hướng tinh chỉnh Whisper trên dữ liệu tiếng Việt. Mỗi dự án có giấy phép, độ chín và hành vi riêng; bài này không đánh giá chúng.
Phép so sánh nên dùng cùng một bộ âm thanh tiếng Việt có đáp án và cùng tiêu chí: tỷ lệ lỗi từ, lỗi tên riêng, tần suất ảo giác, độ lệch mốc thời gian phụ đề, thời gian biên tập còn lại, cộng với yêu cầu về nơi lưu dữ liệu.
Khi nào Whisper không phải lựa chọn đúng
Ảo giác là giới hạn chính. Model card giải thích mô hình có thể trộn việc đoán từ kế tiếp với việc chép âm thanh nên sinh ra chữ không được nói; hiện tượng lặp văn bản chỉ giảm được một phần nhờ beam search và lịch nhiệt độ, và có thể nặng hơn ở ngôn ngữ ít dữ liệu [3].
Chất lượng chênh lệch theo giọng và phương ngữ, kể cả tỷ lệ lỗi cao hơn với một số nhóm giới tính, chủng tộc hay độ tuổi [3]; với tiếng Việt, khác biệt giữa giọng Bắc, Trung, Nam cần đo riêng. Kho không mô tả tính năng phân tách người nói hay chạy thời gian thực [3], cửa sổ 30 giây buộc tệp dài được xử lý tuần tự [1], và turbo không dùng được cho dịch [1].
Không nên dùng Whisper cho quyết định rủi ro cao như bằng chứng pháp lý, chấm điểm nhân sự hay suy luận đặc điểm con người [3], và không nên dùng khi chưa có người duyệt trước khi công bố. Nhịp phát hành chậm [5] cũng đáng cân nhắc nếu cần sửa lỗi nhanh từ thượng nguồn.
Thử nghiệm sáu tuần trên kho video của agency
Tuần 1 và 2: chọn khoảng mười giờ âm thanh đại diện từ kho đã có đồng thuận, gồm phỏng vấn, livestream và quảng cáo có nhạc nền, đủ giọng ba miền; biên tập viên tạo bản ghi chuẩn làm đáp án. Ghim phiên bản gói và trọng số, ghi lại cấu hình máy.
Tuần 3 và 4: chạy small, medium, large và turbo với ngôn ngữ chỉ định là tiếng Việt; đo tỷ lệ lỗi từ, lỗi tên thương hiệu, số đoạn ảo giác trên mỗi giờ âm thanh, độ lệch thời gian phụ đề và thời gian xử lý. Thử initial_prompt chứa danh sách tên riêng như một biến độc lập [5].
Tuần 5 và 6: chạy song song với quy trình hiện tại trên dự án thật; biên tập viên làm từ bản nháp Whisper và so thời gian biên tập mỗi phút video với cách gõ tay. Ngưỡng để tiếp tục do agency đặt trước, ví dụ thời gian biên tập giảm rõ rệt và không có lỗi tên riêng nào lọt ra bản công bố.
Dừng thử nghiệm nếu ảo giác ở đoạn nhạc nền xuất hiện thường xuyên mà biên tập viên khó phát hiện, nếu chất lượng với một giọng vùng miền thấp hơn yêu cầu của khách hàng, nếu không bảo đảm được đồng thuận và quyền lưu trữ, hoặc nếu chi phí vận hành GPU vượt chi phí thuê ngoài ở khối lượng thực tế.
Kết luận: giá trị nằm ở quy trình có người duyệt
Whisper đưa nhận dạng giọng nói đa ngôn ngữ về chạy trên hạ tầng của chính doanh nghiệp, với mã và trọng số theo giấy phép MIT [1][2]. Tiếng Việt có trong danh sách ngôn ngữ, nhưng chất lượng thực tế phải tự đo [3][7].
Giá trị thật không nằm ở tự động hóa hoàn toàn mà ở việc biến người gõ thành người duyệt. Với agency marketing số, đó là phụ đề nhanh hơn, kho lời thoại tra cứu được, và dữ liệu khách hàng không rời máy nội bộ.
Ba điều kiện quyết định thành công: đồng thuận rõ ràng của người được ghi âm, bước duyệt bắt buộc trước khi công bố, và một bộ kiểm thử tiếng Việt được cập nhật định kỳ.
Phương pháp, phạm vi nguồn và tuyên bố miễn trừ
Whisper vào chuỗi bài nhờ kho lưu độc lập các danh sách GitHub Trending theo ngôn ngữ. Theo tổng hợp, openai/whisper được ghi nhận 6 lần từ 14/05/2026 đến 07/09/2026; trang bằng chứng là danh sách Python ngày 14/05/2026, vị trí 18 [8]. Kho lưu chỉ theo dõi Python, Go, JavaScript và Swift, thiếu ngày 03/09 và 12/10, nên không thể xem là bảng xếp hạng Top 100 chính thức.
Commit khảo sát là 86098128c0b4f24f0e2aa2994de830614b474227, ngày commit 31/08/2026, kiểm tra ngày 12/10/2026. Nguồn đã đọc gồm README [1], LICENSE [2], model card [3], data/README [4], CHANGELOG [5], requirements.txt [6] và whisper/tokenizer.py [7], tệp mà README chỉ tới làm danh sách ngôn ngữ.
Bài là kết quả đọc tài liệu và mã, không phải công bố khoa học có bình duyệt; Whisper không được cài, chạy hay đo trong quá trình viết. Tình huống agency, khung chi phí và kế hoạch thử nghiệm là đề xuất của tác giả.
Xem mã nguồn Whisper trên GitHub