
Dùng AI để xác thực ý tưởng: tổng hợp phản hồi, người dùng giả lập và những giới hạn
Đăng ngày 23/10/2026
Mục lục bài nghiên cứu
Tóm tắt và điều cần nhớ
Bài là phần bảy của giai đoạn xác thực, nối tiếp phỏng vấn khách hàng, thí nghiệm rẻ, đo mức chi trả và thiên kiến. Câu hỏi thực dụng: việc nào trong kiểm tra ý tưởng giao được cho AI, việc nào vẫn do người thật gánh. Luận điểm: AI đáng dùng để xử lý lời của người thật; khi nó đóng vai người thật thì đầu ra chỉ là giả thuyết.
- Hai vai khác nhau: AI xử lý lời của người thật (tóm tắt, mã hoá chủ đề, dựng kịch bản) và AI đóng vai người thật (người dùng giả lập). Vai đầu có bằng chứng thuận lợi hơn.
- Mô phỏng có thể khớp ở mức trung bình nhóm, nhưng nghiên cứu độc lập thấy độ phân tán bị thu hẹp, kết quả đổi theo câu chữ và ngày chạy, các nhóm danh tính bị mô tả phẳng [1][2].
- Độ chính xác không chuyển tự động giữa bài toán: gắn nhãn phản hồi, trả lời khảo sát và dự đoán mua hàng cần các phép kiểm riêng.
- Mô phỏng có cơ sở cần dữ liệu từ người thật; khớp khảo sát chưa xác nhận được sức mua trên thị trường [3].
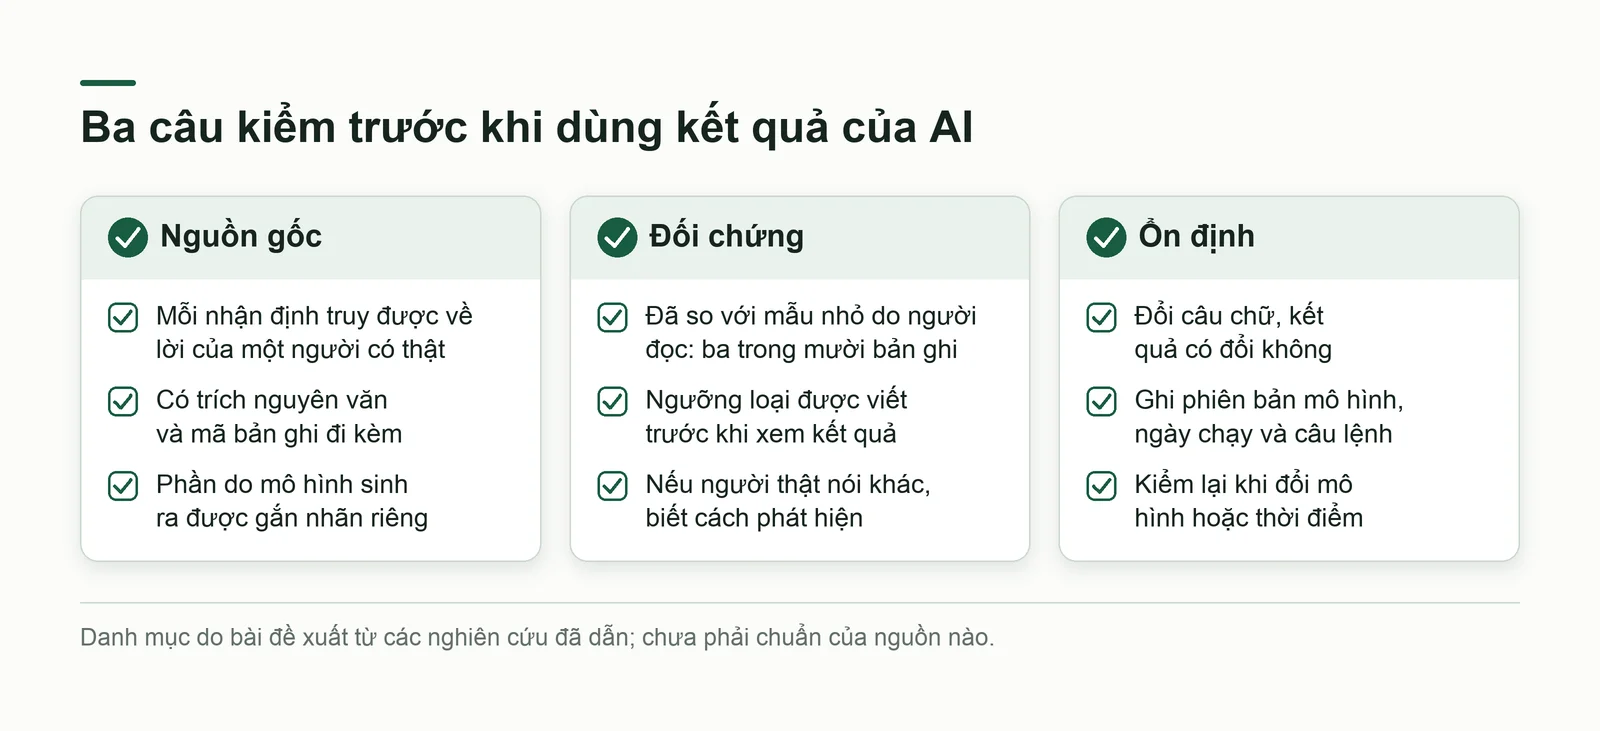
- Trước khi tin một kết quả AI, hỏi ba câu: nó xuất phát từ lời ai, nếu người thật nói khác thì phát hiện bằng cách nào, và nó có đổi khi đổi câu chữ, ngày chạy, phiên bản mô hình không.
Bối cảnh và câu hỏi của bài
Lời khuyên quen thuộc của giới khởi nghiệp là đi nói chuyện với khách hàng, và cái giá là thời gian. Trong buổi trò chuyện YC đăng ngày 27/08/2026, Aaron Cannon, giám đốc điều hành Outset (thuộc lứa YC mùa đông 2023), nói AI của hãng đã dẫn hàng triệu cuộc phỏng vấn, một trăm cuộc ở khách hàng đầu tiên xong trong vài giờ thay vì vài tháng, và hãng đang mở rộng sang mô phỏng và bản sao số khách hàng [4]. Đó là lời người bán hàng, do một người của YC dẫn, không kèm số đo độ chính xác.
Lời nhắc ngược chiều cũng đến từ YC. Trong buổi thảo luận của bốn đối tác đăng ngày 15/01/2025, các đối tác YC nhận xét rằng đổi sang ý tưởng gọi API của một mô hình không đổi được số phận startup nếu bỏ qua điều cơ bản [5]. Gustaf Alströmer, cũng là đối tác YC, từ 2022 đã nói người dùng thường có vấn đề đáng nghe nhưng giải pháp họ nghĩ ra thường dở [6].
Khái niệm và khung phân tích
Người dùng giả lập (synthetic respondent) là câu trả lời do mô hình ngôn ngữ sinh ra khi được yêu cầu đóng vai một người có hồ sơ cho trước; nhiều câu như vậy hợp thành mẫu silicon (silicon sample) theo cách gọi của Argyle và cộng sự [7]. Outset gọi tác tử dựng từ phỏng vấn dài với người thật là bản sao số (digital twin) [4]. Persona, theo Startups.com, là đầu ra của phỏng vấn chứ không phải đầu vào [8].
Argyle và cộng sự đề ra bốn tiêu chí gọi là độ trung thực thuật toán (algorithmic fidelity): câu trả lời không phân biệt được với của người, khớp hồ sơ được cho, hợp ngữ cảnh, và tái hiện đúng quan hệ giữa ý kiến, nhân khẩu học và hành vi [7]. Họ không đặt ngưỡng số, và thiếu một trong bốn mặt thì độ tin cậy giảm [9].
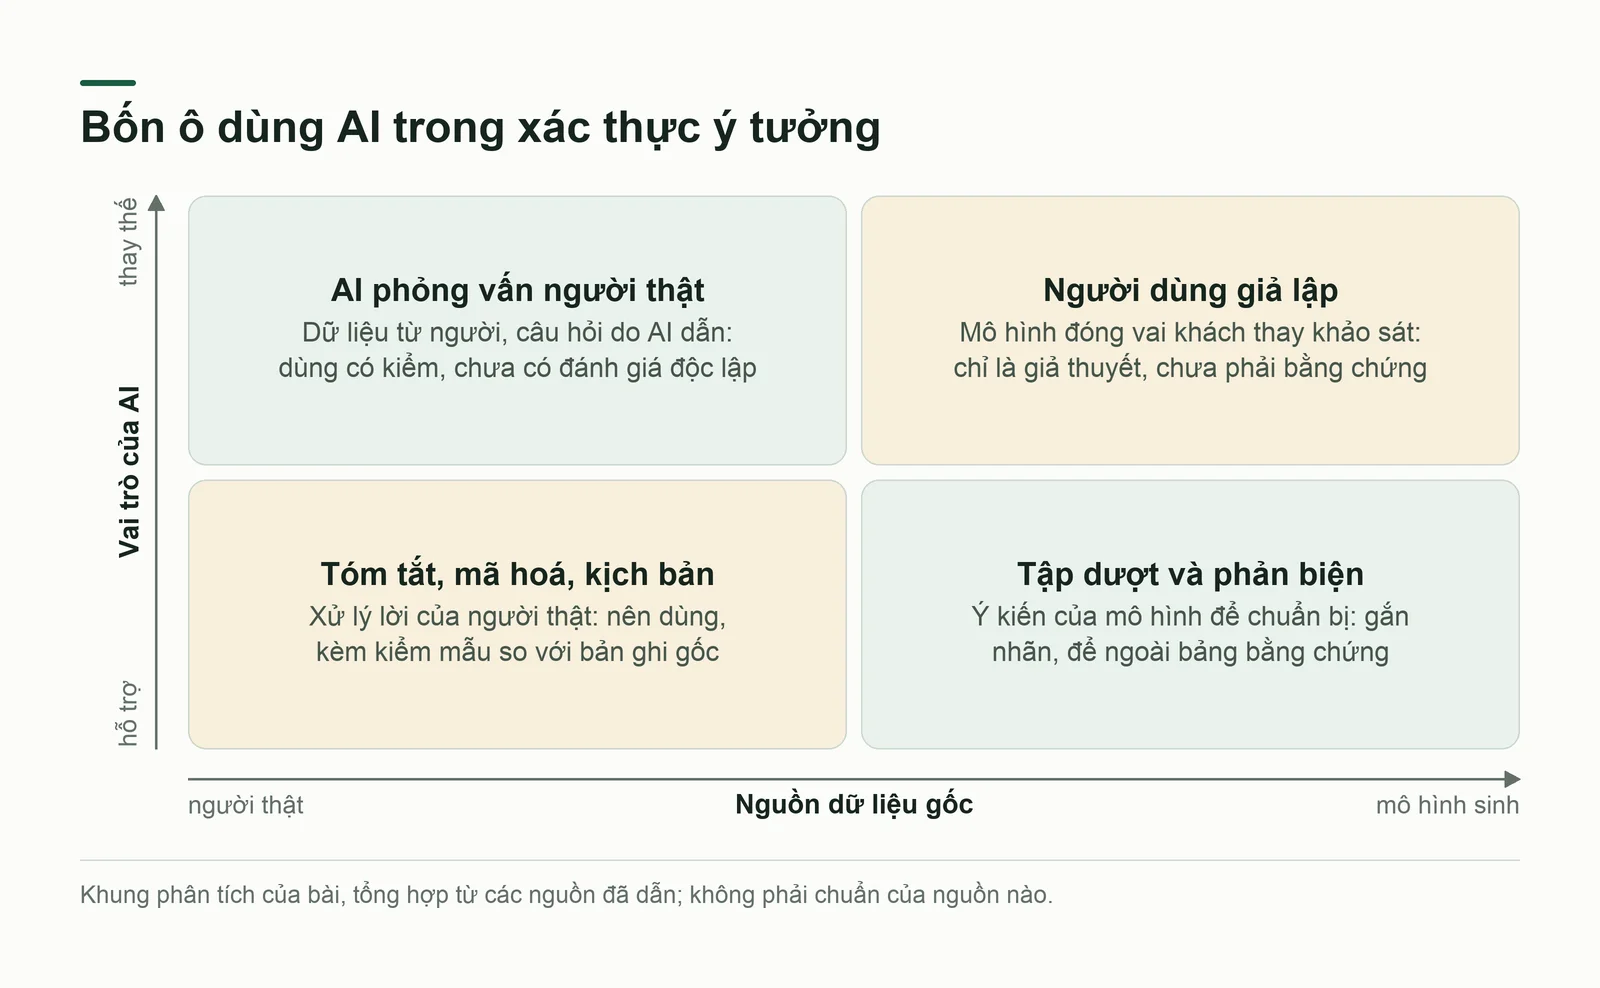
Khung của bài dùng hai trục: dữ liệu gốc từ người thật hay do mô hình sinh; AI hỗ trợ một người làm việc hay thay một quan sát của người. Bốn ô cho bốn mức tin cậy khác nhau, và các mục sau đi qua từng ô.
Xử lý chất liệu từ lời của người thật
Bằng chứng độc lập mạnh nhất cho thế mạnh của mô hình nằm ở gắn nhãn văn bản. Gilardi, Alizadeh và Kubli dùng 2.382 tweet và thấy ChatGPT, không cần ví dụ mẫu, chính xác hơn nhân sự thuê qua mạng ở bốn trên năm tác vụ, với chi phí dưới 0,003 USD mỗi nhãn, rẻ hơn khoảng hai mươi lần so với thuê qua MTurk [10]. Giới hạn: tweet tiếng Anh, bài toán phân loại có nhãn sẵn (bản thảo đầu 27/03/2023, sau đăng ở PNAS); mã hoá bản ghi phỏng vấn mở khó hơn.
Mục từ điển công khai của Startups.com nêu hướng tương tự: AI phân tích bản ghi cuộc gọi cho phép dựng persona với khối lượng khó đạt bằng tay, nhưng persona vẫn phải mang trích dẫn nguyên văn của khách thật [8]. Mục này không dẫn nghiên cứu cho nhận định về AI, nên chỉ đọc như quan điểm người làm nghề.
Có bốn việc đáng giao: tóm tắt bản ghi; mã hoá chủ đề theo sổ mã bạn tự viết; dựng kịch bản phỏng vấn rồi kiểm với nguyên tắc của YC (hỏi cách người ta đang làm, chưa giới thiệu ý tưởng, không hỏi họ có dùng sản phẩm không) [6]; phân tích hàng loạt phản hồi chữ. Minh hoạ giả định cho rủi ro gộp hai lý do thành một chủ đề: nhóm làm phần mềm nhắc lịch cho phòng khám nha khoa mã hoá mười bản ghi, AI trả về chủ đề bệnh nhân quên lịch, nhưng ba người thực ra bỏ lịch vì ngại chi phí, điều nhắc lịch không giải quyết.
Khi mô phỏng khớp: điều ba nhóm nghiên cứu cho thấy
Argyle và cộng sự (Đại học Brigham Young, arXiv 09/2022) điều kiện hoá GPT-3 bằng tiểu sử của người trả lời thật trong các khảo sát chính trị của Mỹ. Với bầu cử 2012, mô hình cho xác suất bỏ phiếu cho Romney là 0,391, khảo sát bầu cử quốc gia ANES ghi 0,404 [7]. Họ nhấn mạnh kết quả ở cấp nhóm, không kỳ vọng từng câu trả lời cá nhân khớp [9].
Horton, Filippas và Manning (NBER, 04/2023, sửa 02/2026) cho mô hình lặp lại các thí nghiệm kinh tế kinh điển và thấy kết quả giống bản gốc về định tính; chỗ khác biệt được xem là gợi ý nghiên cứu tiếp [11]. Bài chỉ dùng tóm tắt công trình, không coi sự giống nhau về định tính là chứng minh người dùng giả lập có thể thay khách hàng trong quyết định đầu tư.
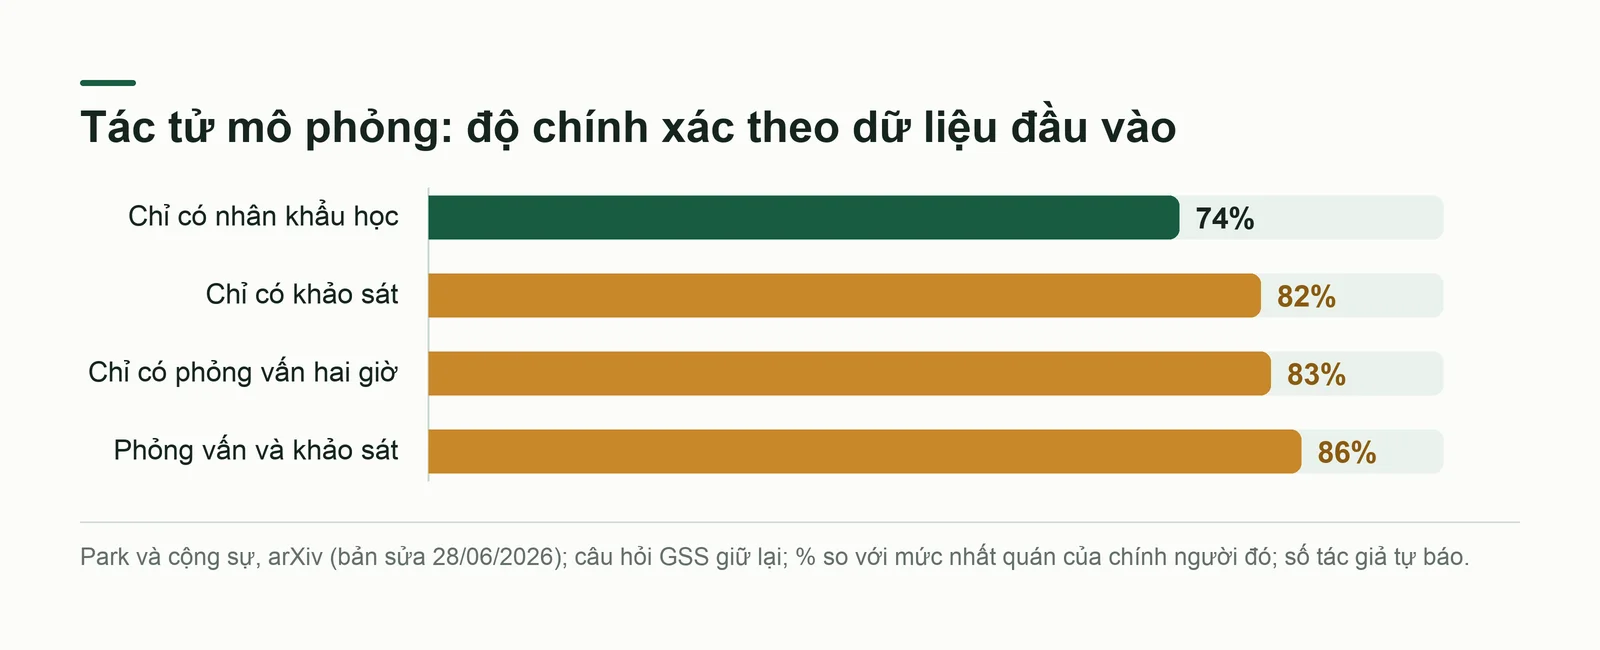
Park và cộng sự (arXiv, bản sửa 28/06/2026) xây tác tử từ dữ liệu tự khai của 1.052 người Mỹ. Trên các câu hỏi GSS giữ lại, phỏng vấn đạt 83%, khảo sát 82%, kết hợp 86%, so với 74% khi chỉ dùng nhân khẩu học; các tỷ lệ được chuẩn hóa theo mức nhất quán của chính người trả lời [3].
Stanford HAI giới thiệu bản đầu vào tháng 5/2025 với con số 85%, đồng thời lưu ý rủi ro riêng tư [12]. Hai phiên bản không nên trộn thành một bảng so sánh. Các số ở Hình 2 đều theo bản sửa; chúng đo câu hỏi khảo sát, không đo quyết định trả tiền, sử dụng lại hay một giao dịch có rủi ro của khách hàng.
Khi mô phỏng sai: phương sai, câu chữ, thời gian và giá
Bisbee và các đồng tác giả (Vanderbilt; Political Analysis, trực tuyến 17/05/2024) cho ChatGPT 3.5 Turbo đóng vai người trả lời. Điểm cảm nhận trung bình của mười một nhóm gần số liệu ANES 2016–2020, nhưng câu trả lời ít phân tán hơn khảo sát thật, kết quả đổi theo thay đổi nhỏ của câu lệnh, và cùng câu lệnh chạy lại vào 07/2023 cho phân bố khác so với 04/2023 [1]. Người xác thực cần thấy nhất chênh lệch giữa các phân khúc, đúng chỗ phân tán bị thu hẹp.
Wang, Morgenstern và Dickerson (Stanford, Đại học Washington, Đại học Maryland) đối chiếu bốn mô hình với nghiên cứu trên 3.200 người ở 16 nhóm nhân khẩu (arXiv, 03/02/2025, nhận đăng ở Nature Machine Intelligence). Được nhắc một danh tính, mô hình dễ phản ánh điều người ngoài nhóm nghĩ về nhóm đó hơn điều người trong nhóm nghĩ về mình, và trả lời phẳng hơn người thật; biện pháp giảm nhẹ chỉ làm giảm, không xoá được tác hại [2]. Persona do mô hình viết cho một nhóm khách hàng vì vậy có thể là cái nhìn từ ngoài vào.
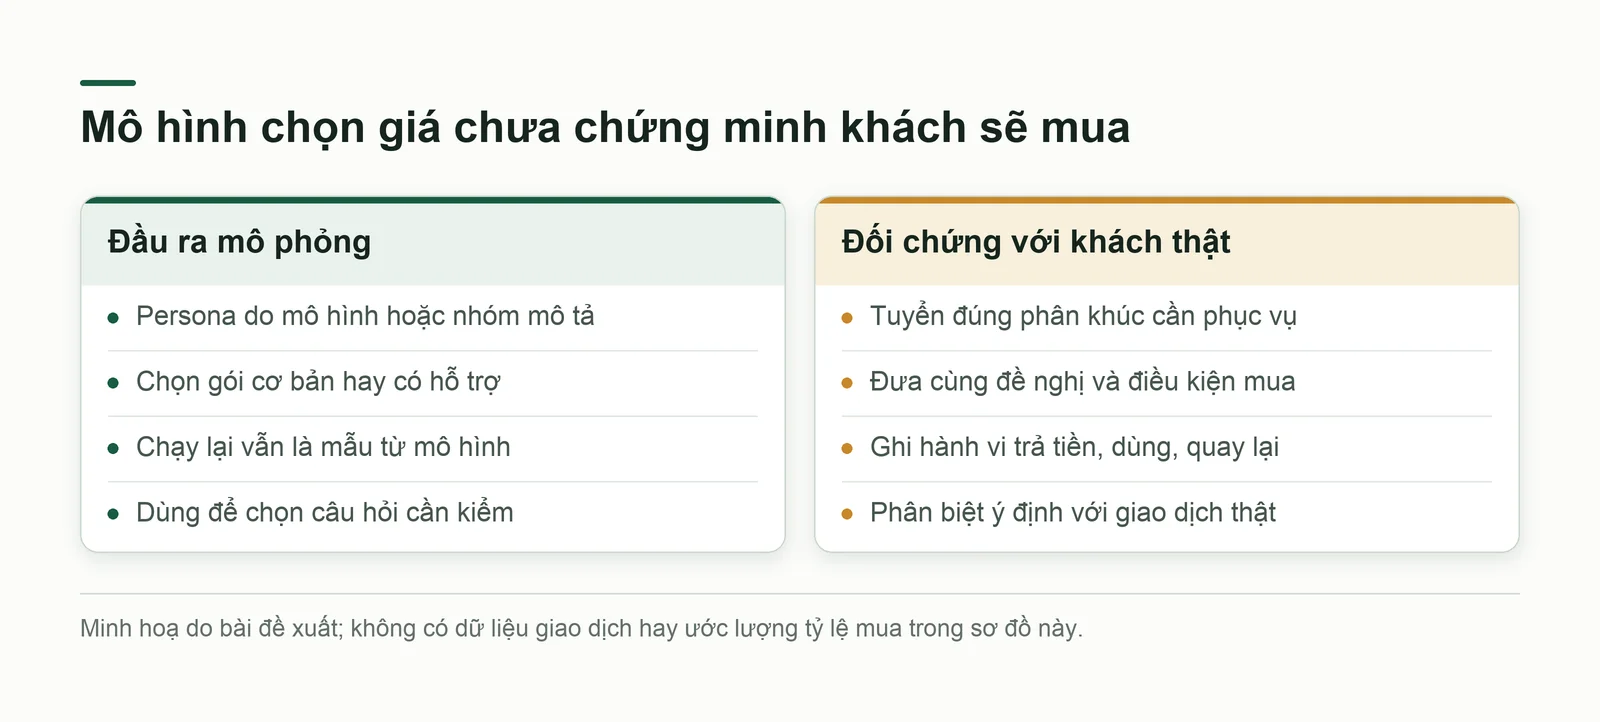
Với giá, đề xuất của bài là đối chứng bằng một lựa chọn thật. Xét tình huống minh hoạ: phần mềm nhắc lịch có bản cơ bản và bản kèm hỗ trợ. Nếu mô hình chọn bản đắt hơn, nhóm chưa biết đó là sở thích của khách, thói quen trong dữ liệu huấn luyện hay tác động của câu mô tả. Một cuộc hẹn dùng thử có lựa chọn trả phí giúp phân biệt tốt hơn, miễn là lời đề nghị và điều kiện hoàn tiền được nói rõ.
Đừng dùng tần suất mô hình chọn phương án thay cho mức chắc chắn của ước lượng thị trường. Chạy lại nhiều lần trên cùng một persona không tự tạo thêm khách hàng độc lập. Muốn biết giá có hợp, cần quan sát cùng phân khúc, cùng gói giá trị và cùng bối cảnh mua; kết quả mô phỏng chỉ giúp chọn câu hỏi hoặc lời đề nghị đáng thử trước.
Ranh giới giữa làm thay và hỗ trợ
Ô còn lại là AI phỏng vấn người thật. Dữ liệu vẫn từ người, nên lỗi khác với mô phỏng: ai được mời, câu hỏi tiếp có dẫn dắt không, người trả lời có biết mình nói với máy và đồng ý cho dùng vào việc gì. Nguồn đã đọc chỉ có lời Outset tự kể về tốc độ và việc người dùng chia sẻ nhiều hơn với máy [4]; chưa thấy đánh giá độc lập, nên đây là giả thuyết cần thử.
AI cũng hay làm người phản biện: hỏi mô hình xem ý tưởng có lỗ hổng nào. Việc này hữu ích để lập danh sách giả định, nhưng đầu ra là ý kiến của mô hình, không phải quan sát về khách hàng. Startups.com khuyên neo câu hỏi vào việc đã làm thay vì lời hứa tương lai [13]; YC cũng cảnh báo hỏi bạn có dùng không dễ thu được lời đồng ý yếu [6]. Ký ức về quá khứ vẫn có thể sai, nên cần đối chiếu hành vi hoặc tài liệu khi có thể. Suy luận của bài, chưa có phép đo: hỏi người dùng giả lập kiểu đó cũng có thể cho ra tiếng có.
AI làm thay khi đầu ra của nó đứng vào chỗ một quan sát về người thật trong bảng bằng chứng; AI hỗ trợ khi nó chỉ đổi chi phí thu thập, xử lý hay chuẩn bị. Ba câu kiểm dưới đây giúp xử lý các trường hợp mơ hồ.
Cách áp dụng từng bước
Quy trình này đặt AI sau người thật ở mọi bước và dùng ba câu kiểm làm điểm dừng trước khi đi tiếp. Mỗi bước đủ nhỏ để làm trong một buổi, nên áp dụng được ngay cho vòng phỏng vấn đầu tiên với khoảng mười người.
- Bước 1: Trước khi chạy bất kỳ công cụ nào, ghi ra điều bạn sợ sai nhất về ý tưởng, dưới dạng một câu mà người thật có thể bác bỏ.
- Bước 2: Chia việc thành hai cột: xử lý chất liệu đã có từ người thật (giao cho AI) và quan sát mới về người thật (không giao).
- Bước 3: Xin phép khi ghi âm, nói rõ bản ghi sẽ được xử lý bằng công cụ AI; gỡ tên và số điện thoại trước khi đưa văn bản vào dịch vụ ở nước ngoài.
- Bước 4: Viết sổ mã chủ đề của riêng bạn, cho AI mã hoá, yêu cầu mỗi chủ đề kèm trích nguyên văn và mã bản ghi.
- Bước 5: Kiểm mẫu: tự đọc và mã hoá ba trong mười bản ghi, so với kết quả AI, ghi chỗ lệch và sửa sổ mã.
- Bước 6: Dùng AI làm người tập dượt và người phản biện, nhưng gắn nhãn ý kiến mô hình và để ngoài bảng bằng chứng.
- Bước 7: Chọn tiếp tục, chuyển hướng hoặc dừng căn cứ vào hành vi của người thật (cam kết, tiền, thời gian); lưu kèm phiên bản mô hình, ngày chạy và câu lệnh.
Góc nhìn AI: đổi gì, không đổi gì và đọc số liệu về AI thế nào
AI đổi chi phí xử lý ngôn ngữ: nghiên cứu Gilardi năm 2023 nêu mức giá mỗi nhãn thấp hơn thuê cộng tác viên trong tác vụ được khảo sát [10]. Outset tự kể một trăm phỏng vấn xong trong vài giờ [4]. Hai kết quả không cùng loại: chi phí gắn nhãn có đáp án chuẩn khác với chất lượng cuộc phỏng vấn mở. Không lấy số của loại này làm lời hứa cho loại kia.
Điều không đổi là loại bằng chứng được tính. Theo Alströmer, khách hàng là bên duy nhất trả tiền cho bạn nên là nguồn trung thực nhất [6]; buổi thảo luận của YC năm 2025 cũng nêu việc cốt lõi để tạo giá trị cho khách hàng không đổi khi có AI [5]. Một cam kết do mô hình sinh ra không phải cam kết của ai; thứ phải đo là hành vi của người thật, nhất là tiền, thời gian và lời hứa họ bỏ ra.
Số liệu về AI cần đọc kèm ngày, loại việc và lợi ích người công bố. Outset bán sản phẩm nghiên cứu khách hàng; tốc độ trong câu chuyện của hãng chưa cho biết độ trung thực của câu hỏi tiếp hay cách chọn người tham gia [4]. Với một công cụ khác, nhóm nên tự lấy mẫu bản ghi, nhờ người chấm theo sổ mã cố định và xem riêng những câu mô hình bỏ sót.
Theo quy trình bài đề xuất, hãy phân loại lỗi trước khi chạy: bịa trích dẫn, gộp hai nguyên nhân, bỏ ý kiến thiểu số hoặc gán sai người nói. Một bản tóm tắt trôi chảy nhưng mắc lỗi trọng yếu không được đưa vào bảng quyết định. Khi đổi phiên bản công cụ, chạy lại mẫu đã chấm để biết chất lượng đổi ra sao; việc này là kiểm quy trình xử lý, chưa phải xác thực nhu cầu sản phẩm.
Số liệu về một mô hình còn có hạn dùng: Bisbee và cộng sự thấy cùng một câu lệnh, chạy lại sau ba tháng, cho phân bố khác [1]. Vì vậy con số do người dùng giả lập sinh ra phải kèm phiên bản mô hình, ngày chạy và câu lệnh, nếu không thì không ai kiểm lại được.
Bằng chứng và ví dụ tại Việt Nam
Tại Việt Nam, FPT.AI công bố sản phẩm Enhance có chức năng bóc băng, trích xuất thông tin, chấm điểm và cảnh báo để người kiểm soát nghe lại cuộc gọi [14]. Đây là mô tả của bên cung cấp, đọc ngày 24/10/2026, chưa được bài dùng thử hay đánh giá độc lập. Nó minh hoạ hướng xử lý cuộc hội thoại đã có, khác với tự sinh một nhóm khách giả định.
Quyền dùng bản ghi phải được giải quyết trước khi đưa vào công cụ. Từ đoạn Điều 9 của Luật 91/2025/QH15 trên bản chính thức được công cụ tìm kiếm trích ra, sự đồng ý cần tự nguyện, biết loại dữ liệu, mục đích, bên xử lý và quyền của chủ thể [15]. Bài chưa đọc được đầy đủ bản quét hoặc nghị định hướng dẫn; không kết luận nghĩa vụ xuyên biên giới hay thời hạn hồ sơ của từng doanh nghiệp.
Cách tổ chức do bài đề xuất là ghi rõ mục đích nghiên cứu, ai được nghe, phần nào gửi cho dịch vụ ngoài và lúc nào xóa. Gỡ tên chưa chắc đã khử nhận dạng nếu lời kể còn đủ chi tiết nhận ra người nói. Không nên tải hồ sơ khách hàng hay dữ liệu nhạy cảm lên một dịch vụ chỉ để thử nhanh khi quyền xử lý và điều kiện bảo vệ chưa rõ.
Minh hoạ giả định: nhóm sinh viên ở Đà Nẵng định làm phần mềm đặt lịch cho tiệm sửa xe máy, nhờ AI đóng vai năm mươi chủ tiệm và nhận kết luận rằng đa số sẵn sàng trả phí tháng. Các nghiên cứu khảo sát ở trên chủ yếu dùng mẫu người Mỹ [3][1], và chưa thấy nghiên cứu nào kiểm tra mô phỏng với người dùng tại Việt Nam, nên kết luận ấy chỉ là giả thuyết. Bước tiếp theo: hỏi tám chủ tiệm thật về lần gần nhất họ mất khách vì lịch rối.
Sai lầm thường gặp và giới hạn của bằng chứng
Bốn lỗi dưới đây là suy ra từ các bằng chứng ở trên, chưa phải thống kê về startup. Cả bốn đều bắt được bằng ba câu kiểm, miễn là hỏi trước khi chốt kết luận chứ không sau khi đã gửi slide cho nhà đầu tư.
- Đếm người dùng giả lập như quan sát, hay trộn họ với người thật trong cùng một bảng hoặc slide gọi vốn: năm mươi câu trả lời do mô hình sinh ra không phải năm mươi khách hàng.
- Hỏi AI ý tưởng này có tốt không rồi coi câu trả lời là ý kiến độc lập, trong khi nó phụ thuộc vào cách đặt câu hỏi.
- Dùng kết quả mã hoá của AI mà không kiểm mẫu, không đối chiếu trích dẫn với bản ghi.
- Chạy một lần rồi chốt, không ghi phiên bản mô hình, ngày chạy và câu lệnh.
Bằng chứng cũng có giới hạn. Các nghiên cứu chạy trên nhiều đời mô hình và bối cảnh khác nhau, nên khó so sánh trực tiếp. Bài bỏ các số liệu từ bản thảo Harvard và báo cáo Verasight vì lượt sửa không mở lại được phần dùng để đối chiếu. Kết quả ủng hộ và cảnh báo không mâu thuẫn vì đo những thứ khác nhau: trung bình nhóm so với độ phân tán, tác tử dựng từ phỏng vấn so với persona ngắn. Không nguồn nào đã đọc đo xem dùng AI trong xác thực có giúp startup chọn đúng hơn.
Kế hoạch thử nghiệm: mười ngày, ba phép thử, mỗi phép một ngưỡng loại
Mười ngày này không xác thực ý tưởng mà xác thực chính công cụ AI trên chủ đề của bạn: nó đáng được giao vai nào. Mỗi phép thử có một ngưỡng loại; chạm ngưỡng thì vai đó rút khỏi bảng bằng chứng. Các con số chỉ là giả định, hãy đổi theo bối cảnh của bạn.
- Phép thử A, ngày 1 đến 5: soạn sáu câu hỏi đóng; cho mô hình trả lời nhiều lần theo hai cách diễn đạt, rồi hỏi tám người thật. Ghi khác biệt để điều tra. Tám người chưa đủ xác nhận mô hình đại diện cho phân khúc, kể cả khi kết quả trông khớp.
- Phép thử B, ngày 6 và 7, mã hoá song song: chọn sáu bản ghi, tự mã hoá không nhìn kết quả AI, rồi so danh sách chủ đề. Loại vai người mã hoá nếu có chủ đề của AI không truy được về trích nguyên văn có thật, hoặc hai bên trùng ít hơn bốn trên năm chủ đề chính.
- Phép thử C, ngày 8 và 9, đảo khung: cho AI đánh giá cùng ý tưởng hai lần, một lần theo giọng nhà đầu tư hoài nghi, một lần theo giọng người ủng hộ, rồi lấy các giả định cả hai lượt cùng nêu. Chấm chất lượng lập luận và bằng chứng có thể kiểm; số ý trùng nhau không chứng minh một phê bình là đúng.
- Ngày 10: lập bảng ba dòng, mỗi vai ở một trong ba trạng thái (dùng tiếp, dùng có kiểm mẫu, ngừng), kèm phiên bản mô hình, ngày chạy và câu lệnh. Quyết định về ý tưởng vẫn dựa trên hành vi của người thật.
Kết luận
Quy tắc rút ra khá gọn: AI đứng sau người thật. Nó giúp bạn đọc nhanh hơn, hỏi sạch hơn và thấy giả định sớm hơn, miễn là mọi nhận định đều truy được về lời của một người có thật và đã qua một lần kiểm mẫu. Khi nó đóng vai khách hàng, hãy coi đầu ra là bản nháp giả thuyết và đem đi hỏi người thật trước khi tiêu tiền.
Nguồn và phương pháp
Bài được tổng hợp và biên tập có hỗ trợ AI, viết bằng lời riêng, không phải bản dịch. Bản nháp ngày 23/10/2026 được đối chiếu ngày 24/10/2026 với các bài YC, mục từ công khai Startups.com, công trình trên arXiv/Cambridge, tóm tắt NBER, Stanford HAI và mô tả FPT.AI. Nguồn luật chính thức chỉ đọc được đoạn được chỉ mục của Điều 9; không tuyên bố đã đọc toàn văn bản quét.
Điều chưa kiểm chứng gồm chất lượng phỏng vấn tự động Outset, khả năng khái quát các nghiên cứu sang khách Việt và quy định chi tiết áp dụng cho bản ghi gửi dịch vụ bên ngoài. Bản thảo HBS và báo cáo Verasight không truy cập lại được đã bỏ khỏi nội dung định lượng. Hai bản Park có thời điểm và kết quả khác nhau, hình chỉ dùng bản sửa năm 2026. Kế hoạch cuối là đề xuất thăm dò, không phải phép kiểm đại diện thị trường. Nên đọc nguồn gốc trước khi áp dụng.