LiteLLM: AI gateway gom khóa API, định tuyến và chi phí cho nhiều mô hình
Đăng ngày 12/10/2026
Mục lục bài nghiên cứu
Tóm tắt: khi nào nên đặt LiteLLM giữa ứng dụng và nhà cung cấp mô hình
LiteLLM là dự án mã nguồn mở của Berri AI, tự giới thiệu là một AI gateway, tức cổng trung gian đứng giữa ứng dụng và các dịch vụ mô hình ngôn ngữ lớn (LLM). Dự án cho phép gọi hơn 100 nhà cung cấp như OpenAI, Anthropic, Gemini, Bedrock hay Azure bằng một định dạng chung kiểu OpenAI, dưới dạng thư viện Python (SDK) hoặc máy chủ proxy dùng chung cho cả tổ chức. [1]
LiteLLM không làm câu trả lời hay hơn; nó bổ sung một điểm kiểm soát: khóa ảo (virtual key) cho từng nhóm thay cho khóa thật, hạn mức chi tiêu, định tuyến và dự phòng, nhật ký chi phí từng yêu cầu. Proxy lo xác thực, ngân sách, định tuyến; SDK lo gọi nhà cung cấp, chuyển đổi định dạng và streaming (trả kết quả theo từng phần). [1][3]
Nên thử khi tổ chức dùng từ hai nhà cung cấp trở lên và nhiều bộ phận cùng gọi API; chưa nên khi chỉ một ứng dụng gọi một nhà cung cấp, vì proxy kèm PostgreSQL và Redis chỉ thêm việc vận hành. README xếp một số nhu cầu như đăng nhập một lần (SSO) vào gói Enterprise, tách khỏi phần mã MIT. [1][2][3]
Bài toán: mỗi nhà cung cấp LLM một kiểu khóa, một định dạng, một hóa đơn
README nêu vấn đề theo góc nhìn lập trình viên: gọi LLM qua nhiều nhà cung cấp nhanh chóng rối vì mỗi bên có SDK, cách xác thực, định dạng yêu cầu và kiểu lỗi riêng. [1] Ở góc độ doanh nghiệp, khóa API còn rải rác trong cấu hình nhiều dự án, hóa đơn đến theo nhà cung cấp chứ không theo bộ phận.
Đổi nhà cung cấp cũng tốn kém: mã gắn chặt với SDK một hãng thì muốn thử mô hình khác phải sửa và kiểm thử lại. LiteLLM xử lý bằng một lớp dịch: mỗi nhà cung cấp có lớp cấu hình với transform_request và transform_response, đổi yêu cầu từ định dạng OpenAI sang định dạng riêng rồi đổi kết quả ngược về. [3]
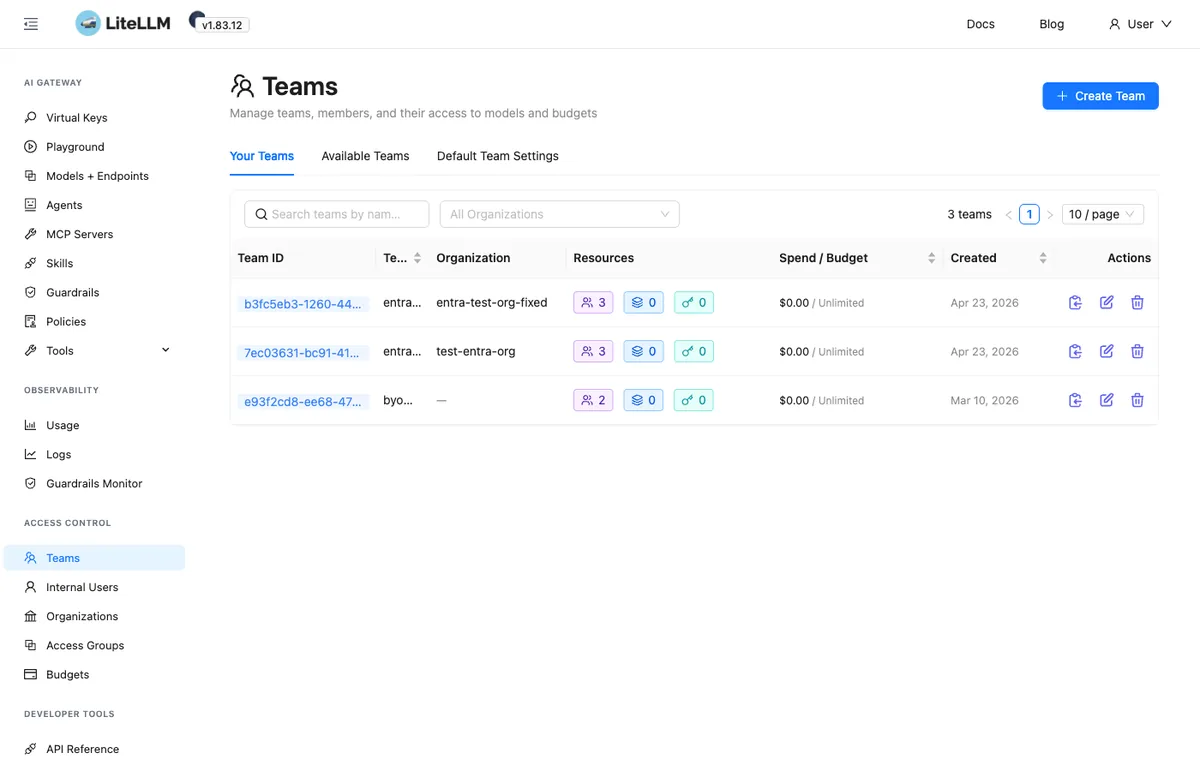
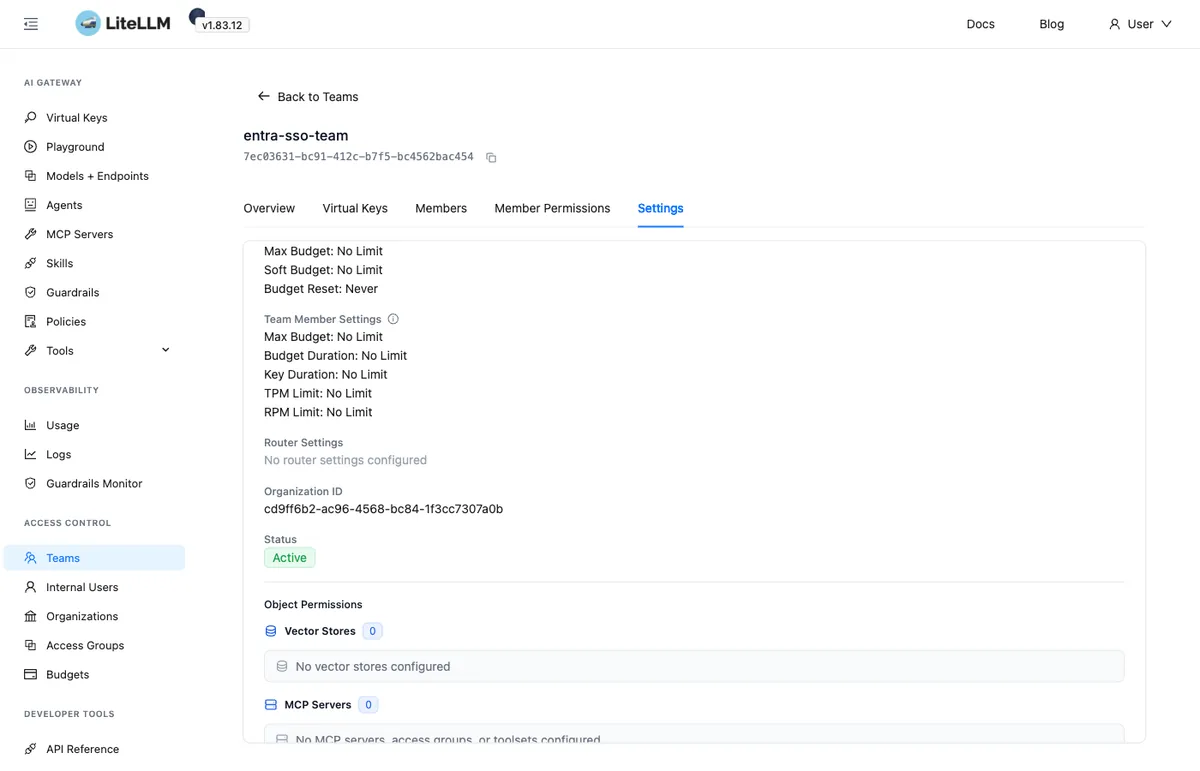
Khó nhất là quản trị: nhóm nào dùng mô hình nào, tháng này tiêu bao nhiêu, khóa nào phải thu hồi khi có người nghỉ việc. Proxy được thiết kế quanh các câu hỏi đó với khóa ảo, chi tiêu theo dự án hoặc người dùng và bảng điều khiển quản trị. [1] Còn ai được dùng mô hình nào cho dữ liệu nào vẫn là chính sách của tổ chức.
Kiến trúc hai tầng: SDK dịch định dạng, proxy giữ khóa, hạn mức và định tuyến
ARCHITECTURE.md vẽ một chuỗi ngắn: client dùng OpenAI SDK, Anthropic SDK hay HTTP client bất kỳ gửi yêu cầu tới AI Gateway (thư mục proxy/), gateway gọi SDK (thư mục litellm/), SDK gọi API nhà cung cấp. [3] Proxy không có đường gọi mô hình riêng, nên hai cách dùng chia sẻ cùng phần mã gọi mô hình.
Tầng proxy có auth/ xử lý khóa API, JWT và OAuth2; hook (mã chen vào trước hoặc sau yêu cầu) như parallel_request_limiter giới hạn tần suất; router.py cân bằng tải và dự phòng. Redis giữ bộ đếm, bộ đệm khóa, số token mỗi phút và trạng thái tạm ngưng của triển khai lỗi; PostgreSQL lưu khóa, nhóm, người dùng và nhật ký chi tiêu. [3]
Tầng SDK có completion() làm điểm vào, get_llm_provider() suy ra nhà cung cấp từ tên mô hình, BaseLLMHTTPHandler điều phối HTTP, mỗi nhà cung cấp một tệp transformation.py có thể kiểm thử đơn vị mà không gọi API thật; callback ghi log như Langfuse chạy bất đồng bộ. [3]
Ngoài ra, nhánh pass-through giữ nguyên thân yêu cầu, chỉ dựng URL theo vùng và thay khóa LiteLLM bằng khóa thật của nhà cung cấp [6]; nhánh Anthropic Messages cho client viết theo định dạng Anthropic gọi cả nhà cung cấp khác qua một adapter dịch định dạng. [5]
Gateway Rust và bản litellm-core: phần đã chạy được, phần còn bỏ ngỏ
Kho mã không chỉ có Python. Thư mục litellm-rust chứa một gateway viết bằng Rust, đọc cấu hình YAML từ biến LITELLM_CONFIG, gắn các máy chủ MCP (Model Context Protocol, giao thức nối mô hình với công cụ) cạnh các route suy luận, dùng chung một lớp xác thực cho mọi yêu cầu MCP và REST. [10]
README của gateway này nói rõ: đọc được một mục cấu hình kiểu Python không có nghĩa dịch vụ đã có. MCP OAuth, quản lý máy chủ bằng cơ sở dữ liệu, guardrail (lớp kiểm tra nội dung vào và ra), kế toán chi tiêu chưa được hiện thực; cấu hình guardrail làm gateway dừng ngay khi khởi động. [10] Ngân sách và guardrail phân tích trong bài vì thế thuộc đường Python của ARCHITECTURE.md. [3]
README gốc còn nhắc bản litellm-core, giữ API import litellm nhưng không kèm CLI hay bảng điều khiển; tại commit này nó phải tự build vì việc đưa vào quy trình phát hành còn đang chờ, cần bộ công cụ Rust. [1] Doanh nghiệp nhỏ nên dùng gói litellm hoặc ảnh Docker đã phát hành, coi hướng Rust và core là lộ trình.
Hành trình của một yêu cầu: từ khóa ảo tới dòng chi tiêu trong PostgreSQL
Sơ đồ tuần tự trong ARCHITECTURE.md lần theo một yêu cầu chat completions: user_api_key_auth() tra khóa trong bộ đệm Redis để lấy hạn mức; hook tăng bộ đếm tần suất; Router chọn triển khai và gọi acompletion(); handler dịch yêu cầu, gửi HTTP, nhận kết quả và dịch ngược về ModelResponse. [3]
Chi phí được tính ngay khi có phản hồi: completion_cost nhân số token với đơn giá, proxy trả kết quả qua header x-litellm-response-cost. Việc ghi sổ thì bất đồng bộ: mức chi tăng thêm vào hàng đợi trên Redis, tác vụ nền update_spend ghi dồn xuống PostgreSQL mỗi 60 giây. [3] Báo cáo cuối ngày nên chờ hàng đợi ghi xong.
Ngân sách được tác vụ reset_budget đặt lại khoảng mỗi 10 đến 12 phút, nhật ký cũ được cleanup_old_spend_logs xóa theo lịch. [3] Với pass-through, proxy gom các mảnh streaming bất đồng bộ để tính chi phí và ghi log sau khi luồng kết thúc. [6]
Policy engine nạp chính sách từ config.yaml lúc khởi động; với mỗi yêu cầu, PolicyMatcher so team, alias của khóa và mô hình với phạm vi chính sách, PolicyResolver duyệt chuỗi kế thừa để ra danh sách guardrail cuối cùng. [4] Cách đặt tên team và khóa từ đầu vì thế rất quan trọng.
Tính năng đã đối chiếu: dự phòng, khóa ảo, chính sách, pass-through, MCP và A2A
Về phạm vi API, README liệt kê các nhóm endpoint hội thoại, responses, embeddings, ảnh, âm thanh, batch, rerank, A2A, messages cùng bảng hỗ trợ của từng nhà cung cấp. Bảng không đồng đều: nhiều bên chỉ có hội thoại, vài bên chỉ có embeddings. [1] "Hơn 100 LLM" là phạm vi kết nối, không phải mọi tính năng có ở mọi nơi.
SDK có Router thử lại và dự phòng (fallback) giữa nhiều triển khai, cân bằng tải, theo dõi chi phí và callback quan sát. Proxy có xác thực tập trung, chi tiêu theo dự án hoặc người dùng, guardrail và bộ đệm theo dự án, khóa ảo, giao diện quản trị. [1]
Về agent, proxy có MCP Gateway để gọi công cụ qua /chat/completions, còn cầu nối MCP phía SDK nằm trong mô-đun experimental_mcp_client, nên coi là thử nghiệm. Proxy cũng làm cổng cho agent theo giao thức A2A (Agent-to-Agent), và hàm agent() chạy các harness (bộ khung chạy agent) như Claude Code, Codex, OpenCode trong sandbox (môi trường cách ly), gọi mô hình qua gateway. [1]
Guardrail được gắn bằng policy engine theo team, khóa, mô hình với mẫu ký tự đại diện và có kế thừa [4]; ở pass-through, guardrail chỉ chạy khi bật tường minh. [6]
Ai nên đưa LiteLLM vào kiến trúc, ai chưa cần
Sự phân vai trong README khá rõ: proxy cho nhóm Gen AI Enablement hoặc ML Platform, tức nhóm cấp quyền truy cập LLM cho cả tổ chức; SDK cho lập trình viên xây dự án LLM bằng Python. [1] Với doanh nghiệp vừa và nhỏ, một đội phát triển thì bắt đầu bằng SDK, nhiều bộ phận cùng dùng mới cần proxy.
Hợp nhất là tổ chức dùng song song nhiều nhà cung cấp hoặc kết hợp API thương mại với mô hình tự chạy, vì bảng nhà cung cấp có cả Ollama, vLLM, LM Studio, Triton. [1] Agency số, công ty phần mềm nhiều khách hàng, chuỗi giáo dục hay bán lẻ là ví dụ. Với hệ thống tri thức kiểu "bộ não thứ hai" mà loạt bài trên phamvanthu.com quan tâm, gateway giúp tách ứng dụng khỏi nhà cung cấp; đây là gợi ý, không mô tả hệ thống nào đang dùng LiteLLM.
Cá nhân chỉ thử một mô hình, hoặc tổ chức không có người vận hành PostgreSQL, Redis và việc nâng cấp, chưa nên dùng proxy: gateway nằm trên đường đi của mọi yêu cầu, không ai trông coi thì nó thành điểm hỏng chung.
Đề xuất cho một trung tâm ngoại ngữ: khóa riêng cho từng bộ phận, ngân sách theo tháng
Tình huống giả định: một trung tâm ngoại ngữ ba cơ sở dạy tiếng Anh luyện thi và tiếng Nhật. Giáo viên cần bản nháp nhận xét bài viết theo tiêu chí chấm, tư vấn viên cần gợi ý trả lời phụ huynh, nhóm học liệu cần bài tập từ vựng. Mỗi nhóm tự mở tài khoản ở một nhà cung cấp, trả bằng thẻ cá nhân, không ai biết tổng chi.
Đề xuất là dựng một proxy LiteLLM trên máy chủ của trung tâm. Mỗi nhóm nhận khóa ảo kèm ngân sách tháng, khóa thật chỉ nằm ở gateway, chi tiêu theo bộ phận hiện ra trong nhật ký. Mô hình nhận xét bài viết có thêm triển khai dự phòng ở nhà cung cấp khác để Router chuyển sang khi lỗi [3]; việc sinh từ vựng có thể trỏ tới mô hình mở chạy qua Ollama trên máy nội bộ. [1]
Bài viết của học viên, nhất là học viên chưa thành niên, gắn với dữ liệu cá nhân: nên tách họ tên, mã học viên khỏi nội dung, và chỉ cho khóa của giáo viên gọi các mô hình mà trung tâm đã xem điều khoản xử lý dữ liệu. Policy engine cho gắn guardrail theo team và mô hình [4], còn chọn và kiểm tra guardrail với tiếng Việt là việc của trung tâm. Nhận xét do mô hình sinh ra chỉ là bản nháp; giáo viên chỉnh và chịu trách nhiệm.
Vận hành gateway: ảnh Docker bản stable, PostgreSQL, Redis và các tác vụ nền
Với môi trường ổn định, README khuyến nghị ảnh Docker có thẻ -stable, được mô tả là đã qua kiểm thử tải 12 giờ trước khi phát hành; mọi ảnh trên GHCR được ký bằng cosign, và nên xác minh chữ ký bằng khóa công khai ghim theo mã commit trước khi kéo ảnh lên máy chủ. [1]
Module Terraform cho AWS và GCP tách gateway, backend và giao diện thành dịch vụ riêng, dùng PostgreSQL, Redis, sinh LITELLM_MASTER_KEY trong trình quản lý bí mật và chạy migrate cơ sở dữ liệu trước khi proxy khởi động; HTTP không mã hóa chỉ dành cho thử nghiệm. [1]
Doanh nghiệp nhỏ có thể bắt đầu gọn hơn, theo đề xuất của bài: một máy chủ ảo chạy container gateway, PostgreSQL có sao lưu, Redis, đặt sau reverse proxy có HTTPS. Tải nền gồm update_spend mỗi 60 giây, add_deployment mỗi 10 giây, kiểm tra sức khỏe triển khai liên tục, xoay khóa mỗi giờ [3], nên cơ sở dữ liệu của gateway phải được giám sát như hệ thống thật.
Nâng cấp là rủi ro lớn nhất vì có bước migrate lược đồ [1]: sao lưu trước, thử trên staging (môi trường thử), giữ đường quay về ảnh cũ. Tài liệu người dùng đã chuyển sang kho litellm-docs riêng [1], nên khi đọc hướng dẫn phải khớp đúng phiên bản đang chạy.
Gateway nắm mọi khóa API: bề mặt tấn công, nhật ký và dữ liệu người học
Đặt gateway vào giữa là gom khóa API về một chỗ: proxy nhận khóa LiteLLM từ client rồi thay bằng thông tin xác thực thật của nhà cung cấp. [6] Ứng dụng không cầm khóa thật, nhưng gateway và cơ sở dữ liệu của nó thành mục tiêu giá trị cao; module Terraform đặt khóa nhà cung cấp trong trình quản lý bí mật của AWS hoặc GCP [1], cách làm nên học theo.
Chính sách bảo mật chia lỗ hổng thành tấn công chuỗi cung ứng vào gói PyPI hay ảnh Docker, truy cập proxy không cần xác thực, và hành động vượt quyền. Tấn công dựa trên cấu hình sai, như không đặt master_key, được ghi là ngoài phạm vi. [8] Cấu hình an toàn là trách nhiệm của bên triển khai.
Tệp security.md khẳng định khi tự lưu trữ thì không có dữ liệu hay telemetry (số liệu đo gửi về) nào lưu trên máy chủ của LiteLLM; LiteLLM Cloud là lựa chọn riêng với vùng dữ liệu ở Mỹ và châu Âu. [8] Dù vậy, callback có thể gửi log tới Langfuse, Datadog [3], và prompt vẫn đi tới nhà cung cấp. Cần quyết định có ghi nội dung prompt không và đặt thời hạn lưu nhật ký.
Ví dụ MCP trong README đặt require_approval là never [1]; công cụ có quyền ghi nên bắt đầu ở chế độ cần phê duyệt. Gateway Rust coi danh sách công cụ được phép để trống là cho phép tất cả [10], nên hãy khai báo tường minh.
Giấy phép: MIT cho phần lớn mã, giấy phép thương mại cho thư mục enterprise/
Tệp LICENSE ở gốc không phải MIT thuần: nội dung trong enterprise/ chịu giấy phép riêng của thư mục đó, phần bên ngoài theo MIT với bản quyền 2023 của Berri AI. [2] LICENSE của litellm-proxy-extras lặp lại đúng cách chia này. [11]
LICENSE gốc gọi tên enterprise/LICENSE, nhưng tệp thực tế tại commit là enterprise/LICENSE.md, được README của thư mục trỏ tới. [2][9] Đây là giấy phép thương mại: dùng trong production cần thỏa thuận thuê bao với BerriAI và giấy phép cho đúng số người dùng; được sao chép, sửa đổi để phát triển và kiểm thử; ngoài ra cấm phân phối hay bán lại. [7]
Hệ quả cụ thể: ARCHITECTURE.md liệt kê hai tác vụ tính chi phí cho batch và Responses API nằm trong enterprise/litellm_enterprise [3], còn README xếp SSO, SLA tùy chỉnh và hỗ trợ chuyên nghiệp vào gói Enterprise. [1] Trước khi cam kết, hãy đối chiếu từng tính năng sẽ dùng thuộc phần MIT hay enterprise.
Giấy phép chỉ áp dụng cho mã của kho tại commit này, không gồm điều khoản nhà cung cấp, trọng số mô hình mở chạy sau gateway, LiteLLM Cloud hay thư viện phụ thuộc; thành phần bên thứ ba giữ giấy phép gốc. [7] Các tệp đã đọc không nêu CLA hay quy định nhãn hiệu.
Chi phí nằm ở token nhiều hơn ở máy chủ: lập giả định nguồn lực
Gateway không tự chạy mô hình, nên phần cứng thuộc loại máy chủ ứng dụng: CPU, bộ nhớ, ổ đĩa cho PostgreSQL và Redis, không cần GPU trừ khi tự chạy mô hình phía sau. README nêu độ trễ P95 8 ms ở 1.000 yêu cầu mỗi giây; đó là số nhà phát triển công bố, bài chưa kiểm chứng. [1]
Khoản lớn nhất thường là lượt gọi API. LiteLLM tính chi phí bằng số token nhân đơn giá [3], nên con số trong nhật ký là ước tính theo bảng giá gateway biết lúc gọi; khi có chiết khấu hay đổi giá, phải đối chiếu hóa đơn thật và ghi lại độ lệch mỗi tháng.
Về con người: một người kỹ thuật bán thời gian lo cài đặt, cập nhật, sao lưu, giám sát; một người nghiệp vụ đặt ngân sách và duyệt cấp khóa. Nếu cần tính năng Enterprise, cộng phí thuê bao theo thỏa thuận với BerriAI [7]; bài không nêu giá. Số người dùng, số yêu cầu mỗi ngày, độ dài prompt nên lấy từ nhật ký tuần thử đầu tiên.
Gọi SDK trực tiếp, dùng nền tảng của một hãng, hay đặt gateway độc lập?
Để mỗi ứng dụng gọi SDK của nhà cung cấp là cách ít thành phần nhất, nhưng khóa sẽ phân tán và đổi mô hình phải sửa mã. Nền tảng tổng hợp của hãng đám mây như Amazon Bedrock, Azure AI hay Vertex AI gắn quản trị với hệ sinh thái của hãng. Các cách không loại trừ nhau: những nền tảng này, cùng dịch vụ định tuyến như OpenRouter hay Vercel AI Gateway, đều có trong bảng nhà cung cấp của LiteLLM. [1]
Gateway của bên thứ ba như AI gateway của Cloudflare, Kong hay Portkey là hướng khác; bài không so sánh tính năng cụ thể. Ở cấp phương án, LiteLLM tự lưu trữ được, phần ngoài enterprise/ theo MIT, nhật ký chi tiêu nằm trong PostgreSQL của chính tổ chức [2][3][8]; đổi lại, tổ chức tự gánh vận hành.
Tự viết proxy mỏng đủ dùng với một hai nhà cung cấp, nhưng khi cần dịch định dạng, theo dõi chi tiêu, giới hạn tần suất và dự phòng, mã tự viết sẽ dần tái tạo những gì ARCHITECTURE.md mô tả. [3] Tiêu chí chọn nên là số nhà cung cấp, số nhóm dùng và năng lực vận hành.
Khi không nên thêm một tầng gateway
Không ai chịu trách nhiệm vận hành thì chưa nên dùng: proxy cần PostgreSQL, Redis, tác vụ nền và quy trình nâng cấp có migrate. [1][3]
Lớp dịch định dạng cũng sinh khác biệt: ARCHITECTURE.md lấy ví dụ gỡ lỗi prompt caching khi Bedrock Converse và Bedrock Invoke xử lý cache_control khác nhau. [3] Tính năng càng đặc thù của một nhà cung cấp càng phải kiểm thử qua gateway, đừng mặc định "tương thích OpenAI" là đủ.
Đơn vị cần SSO, SLA hay tính năng trong enterprise/ mà không có ngân sách giấy phép nên biết sớm, vì phần MIT không bao gồm chúng. [1][7] Dự án lại thay đổi nhanh và README hướng người dùng tới bản stable [1], nên cần nhịp nâng cấp cố định.
Thử nghiệm sáu tuần với hai bộ phận và ba nhóm chỉ số
Tuần 1 và 2 dựng staging: ảnh bản stable đã xác minh chữ ký, PostgreSQL, Redis, master key, hai nhà cung cấp API và một mô hình nội bộ. Phép thử: gọi cả ba nguồn qua cùng client OpenAI; khóa ảo bị chặn khi vượt ngân sách thử; cố ý dùng khóa sai để xác nhận dự phòng. Đây là kế hoạch đề xuất, chưa có kết quả đo.
Tuần 3 đến 5 mở cho giáo viên và tư vấn tuyển sinh. Ba nhóm chỉ số: kiểm soát (tỷ lệ yêu cầu có bản ghi chi tiêu, số khóa cá nhân còn dùng ngoài gateway); độ tin cậy (tỷ lệ lỗi, số lần dự phòng kích hoạt, độ trễ tăng thêm đo bằng công cụ giám sát riêng); tài chính (độ lệch giữa nhật ký và hóa đơn).
Tuần 6 đánh giá theo tiêu chí viết sẵn. Dừng nếu độ lệch chi tiêu vượt ngưỡng kế toán chấp nhận, nếu sự cố gateway làm cả hai bộ phận ngừng việc quá thời gian quy định, hoặc tính năng bắt buộc chỉ có trong gói Enterprise mà ngân sách không cho phép. Nếu đạt, mở rộng từng bộ phận và đưa xác minh chữ ký, sao lưu, nâng cấp vào sổ tay vận hành.
Kết luận: LiteLLM mua sự kiểm soát, không mua mô hình tốt hơn
LiteLLM giải quyết một bài toán có thật của giai đoạn dùng nhiều mô hình: nhiều nhà cung cấp, nhiều định dạng, nhiều nhóm sử dụng và hóa đơn khó phân bổ. Kiến trúc SDK cộng proxy cho phép đổi mô hình mà không đổi mã ứng dụng và quản lý chi tiêu tại một điểm. [1][3]
Cái giá là thêm một hệ thống phải vận hành, ranh giới giấy phép giữa phần MIT và enterprise/, và vài hướng như gateway Rust còn dang dở. [2][7][10] Nên thử nhỏ, đo bằng nhật ký và hóa đơn thật, rồi mới mở rộng.
Câu hỏi giúp ra quyết định: nếu ngày mai đổi nhà cung cấp chính, tổ chức phải sửa bao nhiêu chỗ? Câu trả lời càng dài, lý do thử LiteLLM càng rõ.
Phương pháp: nguồn tại commit 102619d, tiêu chí chọn và giới hạn của bài
LiteLLM được chọn từ một kho lưu độc lập các danh sách GitHub Trending theo ngôn ngữ; bằng chứng là danh sách Python ngày 26/02/2026, kho đứng vị trí 13, và bảng ứng viên của loạt bài ghi 11 lần xuất hiện từ 26/02 đến 10/10/2026. Kho lưu chỉ gồm danh sách Python, Go, JavaScript và Swift, thiếu ngày 03/09 và 12/10/2026; đây không phải bảng xếp hạng Top 100 chính thức của GitHub. [12]
Đối chiếu dựa trên commit 102619d47a78d80f0383c9e8f52446046f0ecc6b của BerriAI/litellm (commit ngày 11/10/2026 giờ UTC), kiểm tra ngày 12/10/2026. Đã đọc README, LICENSE, ARCHITECTURE.md, ba tài liệu kiến trúc con về policy engine và pass-through, cùng năm tệp bổ sung về giấy phép enterprise, bảo mật, gateway Rust và litellm-proxy-extras. [1][2][3][4][5][6][7][8][9][10][11] Trường giấy phép "Other" của GitHub chỉ dùng để đối chiếu; LICENSE trong terraform/provider và vscode-extension chưa được đọc nên bài không kết luận về chúng.
Bài viết là nghiên cứu tài liệu có AI hỗ trợ, không phải bài báo khoa học đã qua phản biện. Bài không cài đặt, chạy, đo hiệu năng hay triển khai LiteLLM; mọi con số đều trích từ tài liệu dự án. Tình huống trung tâm ngoại ngữ, chỉ số và kế hoạch thử nghiệm là phân tích của bài.
Xem mã nguồn LiteLLM trên GitHub