Milvus: kiến trúc cơ sở dữ liệu vector phân tán và đề xuất cho kho bãi cảng
Đăng ngày 12/10/2026
Mục lục bài nghiên cứu
Milvus nên được chọn khi nào, và khi nào là quá sức cần thiết
Milvus là cơ sở dữ liệu vector viết bằng Go và C++, lưu và tìm kiếm vector embedding, tức biểu diễn số của văn bản, hình ảnh hay dữ liệu đa phương thức. Dự án thuộc LF AI & Data Foundation, phát hành theo Apache 2.0, với Zilliz là bên đóng góp chính; Milvus cũng có dạng dịch vụ quản lý trên Zilliz Cloud. [1][2]
Nên cân nhắc Milvus khi số vector lớn hoặc tăng nhanh, khi truy vấn cần kết hợp độ tương đồng với lọc metadata và BM25, hoặc khi dữ liệu của nhiều nhóm phải tách trong cùng một cụm. README mô tả ba cách chạy: Milvus Lite cho thử nghiệm bằng Python, Standalone trên một máy và chế độ phân tán trên Kubernetes. [1]
Milvus thành quá sức khi kho chỉ vài chục nghìn đoạn văn và đội kỹ thuật chỉ một hai người: ngay Standalone chạy từ tệp nhị phân cũng cần etcd và MinIO [4], còn cụm nhiều nút cần WAL backend như Kafka, Pulsar hoặc Woodpecker vì RocksMQ chỉ chạy trên một nút. [8]
Khuyến nghị: kiểm chứng giá trị bằng Lite hoặc Standalone trên dữ liệu thật với bộ câu hỏi có đáp án, rồi mới bàn tới cụm.
Bài toán gốc: tìm cái giống nhau trong dữ liệu không có cột
Phần lớn dữ liệu nghiệp vụ không nằm trong bảng: ảnh chụp, biên bản, email, tệp quy trình. Cơ sở dữ liệu quan hệ giỏi khớp chính xác, nhưng không trả lời được "ảnh nào giống ảnh này". Mô hình embedding biến dữ liệu thành vector, và bài toán trở thành tìm láng giềng gần nhất trong không gian nhiều chiều.
So sánh lần lượt với mọi vector thì chính xác nhưng đắt khi dữ liệu lớn, nên các hệ thống dùng chỉ mục tìm kiếm gần đúng (ANN), đổi một phần độ chính xác lấy tốc độ. Milvus gom các chỉ mục như HNSW, IVF, DiskANN cùng lượng tử hóa (quantization) và mmap vào một hệ quản trị dữ liệu. [1]
Truy vấn thực tế còn kèm điều kiện, kiểu "giống nhất nhưng chỉ trong dữ liệu của khách hàng A". Milvus lưu vector cùng trường vô hướng như số nguyên, chuỗi, JSON, hỗ trợ lọc metadata và tìm kiếm lai giữa vector đặc với vector thưa. [1]
Dữ liệu cũng thay đổi liên tục: README nhấn mạnh cập nhật theo luồng [1], và nền móng của khả năng này là một nhật ký ghi trước (WAL, write-ahead log). [7]
Kiến trúc tách lớp: StreamingNode, nút truy vấn và kho lưu trữ bền
README mô tả Milvus là hệ phân tán tách tính toán khỏi lưu trữ. Nút truy vấn (query node) phục vụ đọc và nút dữ liệu (data node) phục vụ ghi có thể tăng độc lập theo dạng tải; các vi dịch vụ phi trạng thái chạy trên Kubernetes để phục hồi nhanh, còn bản sao (replica) nạp cùng segment lên nhiều nút truy vấn để tăng khả năng chịu lỗi. [1]
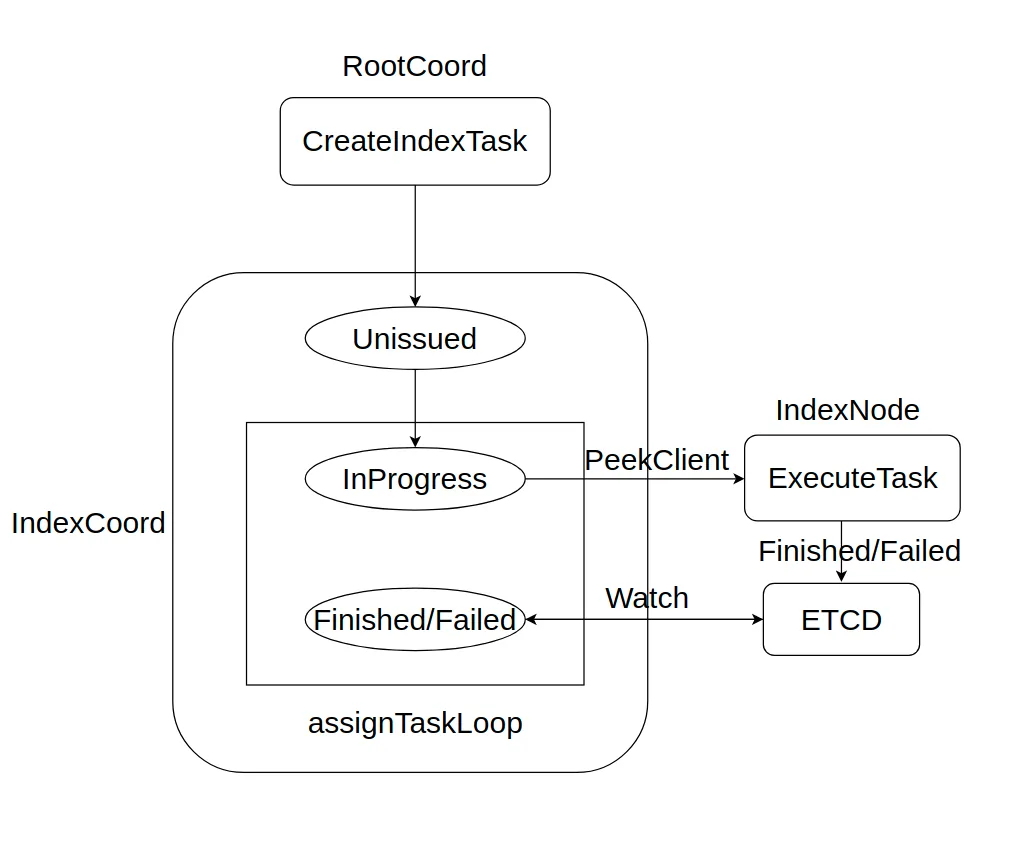
Tài liệu hệ thống streaming mô tả lớp lõi: một WAL dạng log là nguồn sự thật duy nhất cho mọi thay đổi dữ liệu và metadata, chia thành các PChannel (kênh vật lý) trên các StreamingNode; StreamingCoord chạy trong tiến trình RootCoord, gán kênh và theo dõi sức khỏe nút. PChannel được ánh xạ tới các VChannel, là kênh logic theo shard của collection, còn một CChannel duy nhất giữ thứ tự cho thao tác toàn cụm. [7]
Tầng lưu bền của WAL có thể thay: Kafka, Pulsar, Woodpecker (kho log riêng của hệ sinh thái Milvus) hoặc RocksMQ chạy trong tiến trình cho bản Standalone. Mỗi PChannel tương ứng đúng một topic hoặc partition. [8]
Trạng thái khôi phục nằm ở kho đối tượng (object storage) cùng metadata trong etcd [3], và bản Standalone chạy từ tệp nhị phân cần khởi động etcd, MinIO trước Milvus [4]. Bảo vệ Milvus vì thế là bảo vệ cả ba thành phần.
Hành trình của một bản ghi: từ lệnh insert tới kết quả search
Với insert hay delete, tài liệu streaming vẽ đường đi: client gửi tới Proxy, Proxy gọi StreamingClient.Append, StreamingNode ghi vào WAL backend. Thao tác như tạo collection hay đổi RBAC đi qua bộ Broadcaster của StreamingCoord để ghi nguyên tử lên mọi PChannel liên quan; các thông điệp như TimeTick hay Flush do chính hệ WAL sinh ra. [7]
Từ WAL, RecoveryStorage tiêu thụ thông điệp để lưu checkpoint, metadata và dữ liệu segment [7]. Theo tài liệu thiết kế khôi phục, mỗi PChannel có một checkpoint toàn cục vừa là điểm bắt đầu phát lại vừa là giới hạn cắt WAL; phần thay đổi của từng thành phần được ghi trước, checkpoint ghi sau cùng như dấu xác nhận, và WAL không bao giờ bị cắt quá checkpoint đã công bố. [3]
Phía đọc, ứng dụng gửi vector truy vấn, số kết quả (topK) và các trường cần trả về; với tìm kiếm lai, nhiều yêu cầu trên vector đặc và vector thưa được hợp nhất bằng hàm xếp hạng lại. [1]
Mô hình embedding, phiên bản và quy tắc chia đoạn thuộc về ứng dụng. Nên lưu tên và phiên bản mô hình thành trường metadata, vì vector của hai mô hình không so sánh được với nhau và đổi mô hình nghĩa là tính lại cả collection.
Đọc tài liệu thiết kế WAL: phần nào đang chạy, phần nào còn trên nhánh
Tài liệu kiến trúc khôi phục WAL trong thư mục design-docs, duyệt thiết kế ngày 29/07/2026, giao cho RecoveryStorage ba việc: phát lại WAL thành trạng thái khôi phục được, công bố một checkpoint mà mọi phần WAL trước nó đã bền vững, và giới hạn số byte giữa checkpoint với đuôi WAL. [3]
Khi khởi động, nút ghi một RecoveryBarrier để chặn nút ghi cũ, nạp checkpoint và snapshot của từng thành phần, rồi mở đúng một scanner từ checkpoint. Mỗi snapshot thành phần mang một checkpoint_time_tick, nhờ đó việc phát lại vẫn lũy đẳng nếu sự cố xảy ra trước khi checkpoint kịp ghi. [3]
Văn bản tự ghi rằng các thay đổi RecoveryStorage trên nhánh tính năng chưa được phát hành, khôi phục cho nút chỉ đọc là thiết kế tương lai, và muốn chặn cứng đuôi khôi phục thì cần backpressure khi ghi [3]. Bài dùng nó để hiểu hướng kiến trúc, không coi là hành vi của bản phát hành.
Giá trị thực tế là các câu hỏi cho đội vận hành: khởi động lại mất bao lâu, đuôi WAL phình tới đâu khi kho đối tượng chậm. Chỉ thử nghiệm trên phiên bản cụ thể mới trả lời được.
Danh mục tính năng đối chiếu được trong nguồn
Về tìm kiếm, README liệt kê chỉ mục HNSW, IVF, FLAT (vét cạn), SCANN, DiskANN, biến thể lượng tử hóa và mmap; lọc metadata, range search và chỉ mục GPU như CAGRA của NVIDIA. Về văn bản, Milvus hỗ trợ tìm kiếm toàn văn BM25 và vector thưa học được như SPLADE, BGE-M3, lưu chung collection với vector đặc. [1]
Về tổ chức dữ liệu, có đa thuê bao (multi-tenancy) ở mức database, collection, partition hoặc partition key, và lưu trữ nóng/lạnh. Về an ninh, README nêu xác thực, mã hóa TLS và kiểm soát truy cập theo vai trò (RBAC). [1]
Về triển khai: Milvus Lite cài bằng pip và lưu vào một tệp cục bộ [1]; Standalone chạy được bằng tệp nhị phân cùng etcd và MinIO [4]; có quy trình cài ngoại tuyến bằng cách lưu image Docker từ docker-compose hoặc manifest Helm [5]; có script nâng cấp cuốn chiếu (rolling update) cho bản cài bằng Helm. [6]
Hệ sinh thái gồm tích hợp LangChain, LlamaIndex, HuggingFace, giao diện quản trị Attu, Prometheus/Grafana để giám sát, Milvus CDC để đồng bộ và connector Spark, Kafka, Airbyte [1]; bài không kiểm tra giấy phép của từng công cụ.
Bảo mật mức dòng (RLS) mới ở dạng thiết kế: ô người duyệt độc lập và ngày duyệt vẫn ghi TBD. [9]
Ai hưởng lợi, và ai nên đợi
README nêu các ứng dụng điển hình là tìm kiếm văn bản và hình ảnh, RAG và hệ gợi ý. [1] Từ đó, nhóm hưởng lợi rõ nhất là đội kỹ thuật có nhiều dữ liệu phi cấu trúc và cần một dịch vụ tìm kiếm dùng chung, như trong thương mại điện tử, truyền thông, logistics hay bảo hiểm.
Doanh nghiệp vừa và nhỏ vẫn dùng được nếu bắt đầu từ Lite hoặc Standalone, có người quen Docker, Linux và một bài toán tìm kiếm đo đếm được. Khi kho chỉ vài nghìn tài liệu, chi phí học và vận hành dễ vượt lợi ích.
Giới nghiên cứu có thể đọc hai bài báo được README dẫn, trong kỷ yếu International Conference on Management of Data 2021 và Proceedings of the VLDB Endowment 2022 [1]. Các bài báo phản ánh hệ thống lúc công bố, trong khi kiến trúc hiện tại đã có tầng streaming với WAL làm trung tâm. [7]
Nên đợi nếu chưa có người trực hệ thống; khi đó dịch vụ quản lý hay giải pháp đơn giản hơn đáng xét trước.
Đề xuất cho một depot container ở Cái Mép: đối chiếu ảnh hư hỏng và tra quy định hãng tàu
Tình huống giả định: một doanh nghiệp khai thác depot container rỗng kiêm kho CFS gần cụm cảng Cái Mép. Nhân viên chụp ảnh container lúc vào, ra bãi; giám định viên phân loại hư hỏng như móp, thủng, rỉ sét theo yêu cầu riêng của từng hãng tàu; bộ phận khách hàng trả lời về điều kiện trả rỗng, sửa chữa. Đây là đề xuất, không phải dự án đã triển khai.
Thiết kế dùng hai collection. Collection ảnh lưu vector ảnh kèm số container, hãng tàu, thời điểm và mã hư hỏng đã được xác nhận, để ảnh mới được đối chiếu với ca cũ. Collection quy định dùng tìm kiếm lai: vector đặc cho câu hỏi tự do, BM25 cho số container, mã hư hỏng, số booking vốn cần khớp từng ký tự. [1]
Dữ liệu được tách theo hãng tàu bằng partition key [1]; RLS chỉ nên xét khi được phát hành chính thức [9]. Mạng khu cảng thường hạn chế Internet, nên quy trình cài ngoại tuyến bằng cách lưu image rồi nạp trên máy đích là phù hợp. [5]
Hệ thống chỉ gợi ý, giám định viên quyết định, mỗi quyết định được ghi cùng các ca tham chiếu đã hiển thị, và không tự lập phiếu sửa chữa hay tính phí. Ảnh có thể lộ biển số xe hoặc khuôn mặt tài xế, nên cần quy tắc che hoặc giới hạn góc chụp.
Vận hành: từ một máy Standalone tới cụm Kubernetes
Cho giai đoạn thử nghiệm, Standalone là điểm cân bằng: một máy chủ chạy Milvus cùng etcd và MinIO. Hướng dẫn tệp nhị phân lấy tệp chạy từ image milvusdb/milvus:v3.0.2 và cài thêm thư viện hệ thống như libopenblas, libgomp1, libtbb2. [4]
Khi lên cụm, tài liệu cài ngoại tuyến dùng Helm với tham số riêng cho standalone và cluster [5]. README trong deployments/upgrade lại viết cho 2.2.x, chỉ áp dụng bản cài bằng Helm, không áp dụng Milvus Operator và không hỗ trợ rolling update cho Standalone dùng RocksMQ [6]. Khi kho đã tham chiếu image v3.0.2, đội vận hành phải lấy hướng dẫn nâng cấp đúng phiên bản thay vì dùng lại script cũ.
Trạng thái bền nằm ở kho đối tượng và etcd [3], nên sao lưu phải gồm cả hai và phải diễn tập khôi phục. Giám sát dựa vào Prometheus/Grafana [1]; sao chép WAL giữa các cụm theo cấu trúc hình sao [7] có thể làm nền cho phương án dự phòng.
Nên theo dõi từ ngày đầu độ trễ từ lúc ghi tới lúc tìm thấy dữ liệu và thời gian khởi động lại sau sự cố; tài liệu thiết kế chỉ điều tiết đuôi khôi phục theo mục tiêu mềm [3], nên con số thật phải đo tại chỗ.
Bảo mật: cổng dữ liệu, cổng quản trị và quyền theo dòng
Cổng dữ liệu được bảo vệ bằng xác thực, TLS và RBAC [1]. Nên bật xác thực ngay ở môi trường thử, cấp tài khoản quyền tối thiểu cho từng ứng dụng, và đổi mật khẩu root bằng API cập nhật thông tin xác thực, vì sửa defaultRootPassword trong cấu hình không đổi được mật khẩu đã tồn tại. [10]
Một đề xuất cải tiến (MEP) đang Under Review cho biết cổng metrics, thường là 9091, còn phơi thao tác vòng đời tiến trình, quản lý coordinator, profiling, nhật ký sự kiện và giao diện web; lớp xác thực root được đề xuất sẽ tắt theo mặc định, cổng vẫn là HTTP không mã hóa và bản compose chính thức có mở 9091. [10] Cần chặn cổng này bằng tường lửa, chỉ cho mạng quản trị truy cập.
Thiết kế RLS có nguyên tắc đáng học: khi bật thì từ chối mặc định, principal do ứng dụng tin cậy truyền vào; yêu cầu bỏ qua RLS chỉ được chấp nhận khi tắt phân quyền hoặc tài khoản có quyền SkipRLS, nên phân quyền phải luôn bật [9]. Trước khi RLS được phát hành, tách dữ liệu khách hàng nên dựa vào database, collection hoặc partition key [1] cộng kiểm tra quyền ở tầng ứng dụng.
Bucket MinIO và etcd, nơi giữ trạng thái bền [3], cần kiểm soát truy cập riêng. Embedding nên được coi là nhạy cảm ngang dữ liệu gốc, và việc gọi API embedding bên ngoài phải qua đánh giá pháp lý về dữ liệu cá nhân.
Giấy phép Apache 2.0 và những gì nằm ngoài phạm vi của nó
Tệp LICENSE tại commit khảo sát là toàn văn Apache License 2.0, khớp với README ghi dự án phân phối theo giấy phép này [1][2]. Giấy phép cho phép dùng, sửa, phân phối lại, có điều khoản cấp quyền sáng chế từ người đóng góp; khi phân phối lại phải kèm bản giấy phép, giữ thông báo bản quyền, đánh dấu tệp đã sửa và chuyển kèm tệp NOTICE nếu có. Điều 6 không cấp quyền dùng tên thương mại hay nhãn hiệu. [2]
Phạm vi của LICENSE là mã trong kho tại commit này. Nó không bao trùm SDK pymilvus cài từ gói riêng hay dịch vụ Zilliz Cloud [1], các thành phần chạy kèm như etcd, MinIO [4], Kafka, Pulsar [8], mô hình embedding và dữ liệu của doanh nghiệp. Danh sách tệp tại commit còn cho thấy vài thư viện bên thứ ba trong internal/core/thirdparty có tệp LICENSE riêng, cần kiểm kê khi đóng gói lại.
Ranh giới mã mở và thương mại khá rõ: mã trong kho theo Apache 2.0, còn Zilliz Cloud với các gói Serverless, Dedicated, BYOC là dịch vụ quản lý riêng [1]. Bài không xét điều khoản của dịch vụ đó và chưa đọc hướng dẫn đóng góp nên không kết luận về CLA.
Chi phí: đếm vector, đếm người, đếm giờ trực
Nguồn không có bảng giá và bài không ước đoán giá thị trường. Kế hoạch nên tính theo loại nguồn lực: máy chủ (CPU, RAM, SSD), kho đối tượng cho dữ liệu và bản sao lưu, tài nguyên tính embedding (GPU cục bộ hoặc API trả theo lượt), và giờ công tích hợp, gán nhãn, vận hành.
Bộ nhớ là biến số lớn nhất; phép tính minh họa: một triệu vector 768 chiều dạng float32 chiếm khoảng 3 GB chỉ riêng dữ liệu vector, chưa tính chỉ mục, bản sao và metadata. Lượng tử hóa, DiskANN, mmap và lưu trữ nóng/lạnh là các đòn bẩy giảm bộ nhớ được README nêu [1]; cái giá về độ chính xác hay độ trễ phải đo trên dữ liệu thật.
Chi phí con người hay bị đánh giá thấp: cụm phân tán cần người hiểu Kubernetes, etcd, kho đối tượng và WAL backend, còn depot giả định cần thêm giờ giám định viên để dựng bộ ca mẫu có nhãn.
Nên quy chi phí về đơn vị nghiệp vụ, như chi phí mỗi ảnh được đối chiếu, thay vì chỉ nhìn hóa đơn máy chủ.
Bốn hướng thay thế ở mức cách tiếp cận
Hướng thứ nhất là thêm vector vào cơ sở dữ liệu đang có, ví dụ phần mở rộng pgvector của PostgreSQL: giữ một hệ thống và quy trình sao lưu quen thuộc, nhưng cần kiểm chứng khi dữ liệu và tải tăng. Hướng thứ hai là thư viện chỉ mục nhúng trong ứng dụng như FAISS: thử nhanh, nhưng ứng dụng tự lo lưu bền, cập nhật và phân quyền.
Hướng thứ ba là máy tìm kiếm có hỗ trợ vector như Elasticsearch hay OpenSearch, hợp với tổ chức đã vận hành chúng. Hướng thứ tư là cơ sở dữ liệu vector chuyên dụng khác như Weaviate hay Qdrant, mỗi dự án có mô hình giấy phép và cách chia tenant riêng cần đọc từ tài liệu gốc.
Bên trong Milvus cũng có lựa chọn: Lite cho nguyên mẫu, Standalone cho một máy, phân tán cho quy mô lớn, Zilliz Cloud nếu không muốn tự vận hành [1]. Tiêu chí nên gồm quy mô dữ liệu dự kiến trong 12 đến 24 tháng, yêu cầu tách dữ liệu theo khách hàng, năng lực vận hành sẵn có và ràng buộc dữ liệu không rời hạ tầng nội bộ.
Khi nào Milvus là lựa chọn sai
Milvus không phải nơi lưu bản gốc của nghiệp vụ. Dữ liệu chuẩn như container, booking, hóa đơn nên nằm ở hệ thống quản lý bãi hay ERP; Milvus là chỉ mục dựng lại được từ nguồn. Dùng nó thay cơ sở dữ liệu giao dịch là rủi ro lớn về nhất quán và kiểm toán.
Độ phức tạp tăng theo chế độ triển khai. RocksMQ chỉ chạy trên một nút [8]; Standalone dùng RocksMQ không hỗ trợ rolling update [6]; cụm nhiều nút cần WAL backend như Kafka, Pulsar hoặc Woodpecker [8]. Tổ chức không có người trực hệ thống không nên bắt đầu bằng cụm.
Nhịp thay đổi nhanh cũng là hạn chế: tài liệu WAL có nhiều phần ghi là tương lai hoặc chưa phát hành [3], đề xuất xác thực cổng quản trị đang được xem xét [10], RLS chưa có ngày duyệt thiết kế [9]. Doanh nghiệp cần cố định phiên bản, đọc ghi chú phát hành và thử nâng cấp trên staging.
Chất lượng tìm kiếm tiếng Việt phụ thuộc mô hình embedding và cách tách từ cho BM25, điều bài chưa xác minh; đó phải là hạng mục kiểm thử bắt buộc.
Thử nghiệm tám tuần: chỉ số, giai đoạn và điều kiện dừng
Tuần 1 và 2 dành cho dữ liệu: tập ảnh hư hỏng đã có kết luận giám định và bộ câu hỏi thật, mỗi câu có đoạn quy định đúng do người phụ trách xác nhận; tập đánh giá giữ riêng. Đây là kế hoạch đề xuất, chưa có số liệu đo.
Tuần 3 tới 5 dựng Standalone theo quy trình ngoại tuyến [5], so sánh vector đặc với tìm kiếm lai có BM25 [1] và với mốc tìm từ khóa trên hệ thống hiện có. Chỉ số: tỷ lệ ca đúng trong năm kết quả đầu (recall@5), tỷ lệ câu hỏi có đoạn đúng trong ba kết quả đầu, độ trễ p95 đo tại chỗ và số phút giám định viên tiết kiệm.
Tuần 6 tới 8 diễn tập vận hành: dừng đột ngột tiến trình, khôi phục etcd và MinIO từ bản sao lưu [3], nâng cấp thử một bản vá trên staging, xác nhận cổng 9091 không truy cập được từ mạng người dùng [10]. Ghi lại thời gian phục hồi và mọi bước thủ công.
Điều kiện dừng: recall không vượt rõ mốc so sánh, đội không khôi phục được dữ liệu trong diễn tập, hoặc giờ công vận hành vượt ngân sách. Chỉ mở rộng khi người phụ trách nghiệp vụ ký xác nhận tiêu chí đạt.
Kết luận: mạnh ở quy mô, đòi hỏi kỷ luật vận hành
Milvus có phạm vi tính năng rộng: nhiều loại chỉ mục, tìm kiếm lai với BM25, đa thuê bao, lưu trữ nóng/lạnh và các đường triển khai từ một tệp Python tới cụm Kubernetes [1]. Việc lấy WAL làm nguồn sự thật cho thấy dự án đầu tư nghiêm túc vào độ bền. [7]
Đổi lại, giá trị chỉ xuất hiện khi tổ chức có bài toán tìm kiếm đo được, dữ liệu sạch và người vận hành hiểu etcd, kho đối tượng và cổng quản trị.
Với depot container ở Cái Mép trong tình huống giả định, con đường hợp lý là Standalone, một bộ đánh giá có nhãn và tám tuần thử nghiệm có điều kiện dừng, trước mọi quyết định mở rộng.
Phương pháp, nguồn tư liệu và giới hạn của bài
Milvus được đưa vào loạt bài từ một kho lưu độc lập các trang GitHub Trending theo ngôn ngữ; bằng chứng trích dẫn là danh sách Go ngày 10/01/2026, nơi milvus-io/milvus đứng vị trí 12 [11]. Theo dữ liệu tuyển chọn của loạt bài, dự án xuất hiện 16 lần từ 10/01/2026 tới 13/09/2026. Kho lưu chỉ theo dõi Python, Go, JavaScript, Swift và thiếu hai ngày 03/09 và 12/10/2026, nên danh sách này không thể coi là Top 100 chính thức của GitHub.
Phân tích kỹ thuật dựa trên commit 06161a3334435443a8e36ec135539047f2c114bc (thời điểm commit 12/10/2026), kiểm tra ngày 12/10/2026. Đã đọc README, LICENSE, tài liệu khôi phục WAL, ba README triển khai, tổng quan streaming, tài liệu WAL backend, thiết kế RLS và đề xuất xác thực cổng quản trị [1][2][3][4][5][6][7][8][9][10]; README của gói privilege cũng được tải nhưng chỉ có một dòng nên không được trích.
Bài là nghiên cứu tài liệu: không cài đặt, không chạy, không đo hiệu năng Milvus. Tình huống Cái Mép, khung chi phí và lộ trình tám tuần là đề xuất của người viết; bài không phải công trình khoa học đã qua bình duyệt, và con số duy nhất không lấy từ nguồn là phép tính bộ nhớ minh họa.
Xem mã nguồn Milvus trên GitHub