
Mô hình kinh doanh AI: cấp phép, dữ liệu, mã nguồn mở và điều kiện để sinh lời (Phần 2/3)
Đăng ngày 23/10/2026
Mục lục bài nghiên cứu
Tóm tắt và điều cần nhớ
Đây là phần 2 trong chuỗi 3 phần về mô hình kinh doanh trí tuệ nhân tạo (AI). Bài bàn về các cách thu tiền còn lại (giải pháp theo dự án, cấp phép, dữ liệu, mã nguồn mở, mô hình lai) cùng điều kiện và rủi ro quyết định chúng sinh lời hay thua lỗ.
- Chọn mô hình theo tài sản khó sao chép bạn đang có: năng lực triển khai, công nghệ, dữ liệu hoặc cộng đồng.
- Giải pháp theo dự án tuỳ biến cao nhưng khó nhân rộng; cấp phép thì ngược lại; mô hình lai ghép cả hai.
- Dữ liệu chỉ thành tiền khi sạch, đại diện và được phép dùng; Việt Nam cấm mua, bán dữ liệu cá nhân, trừ trường hợp luật khác quy định[1].
- Thành bại nằm ở dữ liệu, hạ tầng, nhân lực, tuân thủ, thị trường hơn là ở thuật toán.
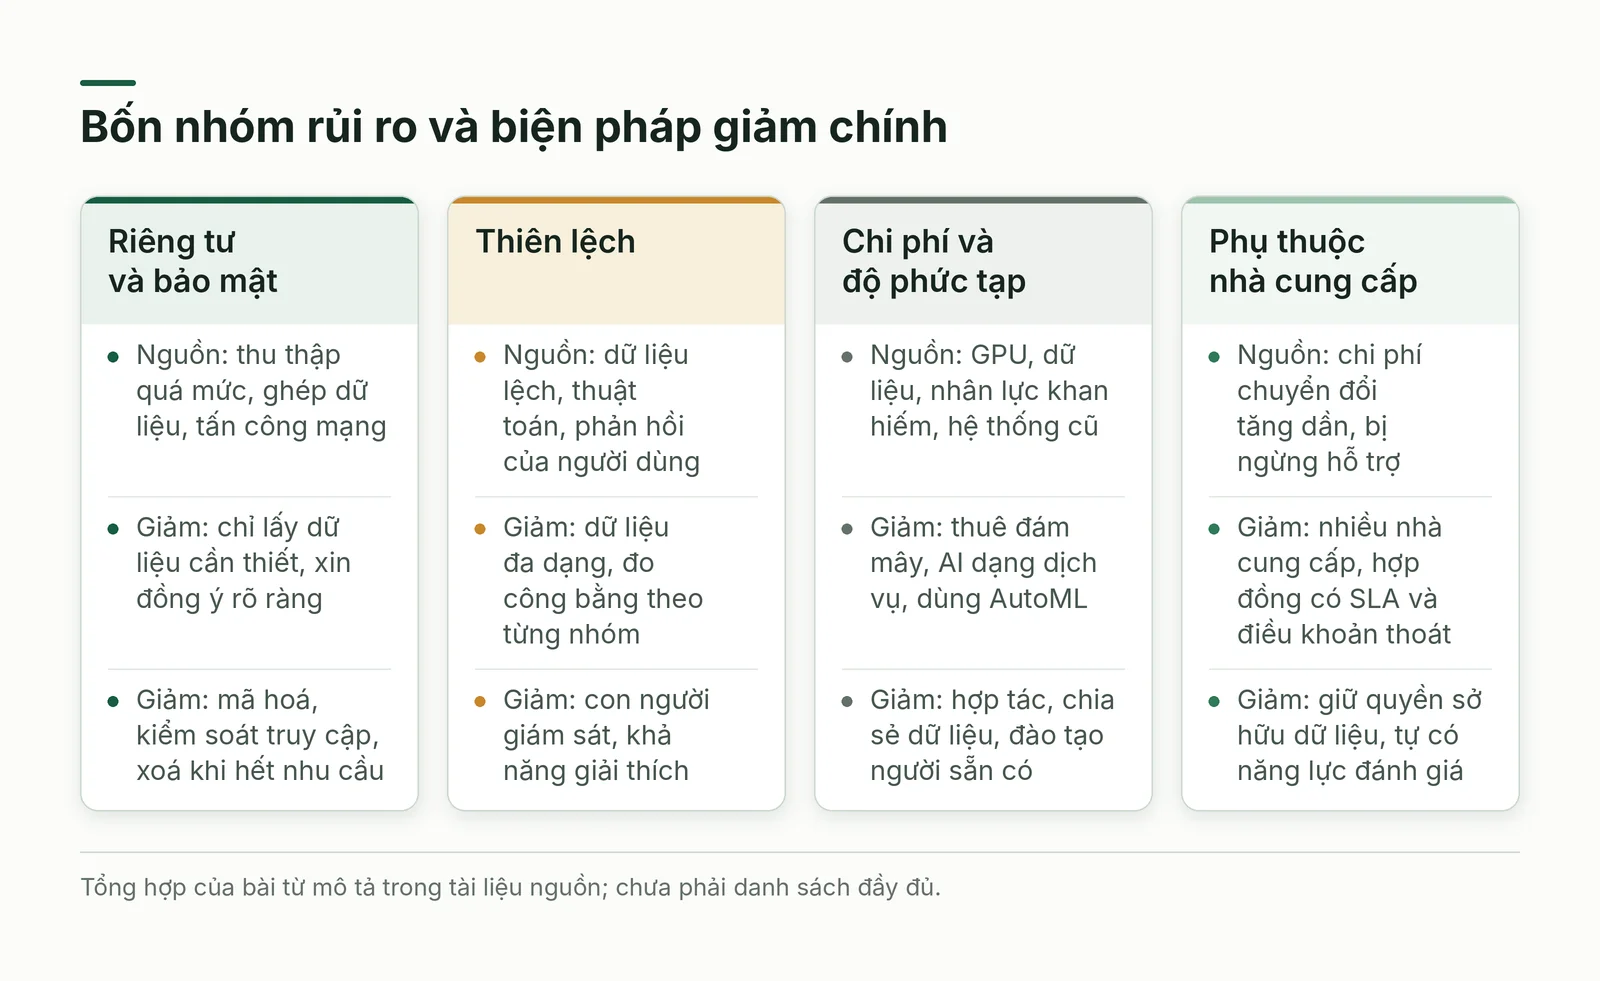
- Bốn rủi ro cần kế hoạch trước: quyền riêng tư, thiên lệch, chi phí, phụ thuộc nhà cung cấp.
Bối cảnh: vì sao chọn cách thu tiền khó hơn chọn công nghệ
Câu hỏi khó nhất của một dự án AI hiếm khi là dùng thuật toán nào, mà là ai trả tiền, cho cái gì, theo kỳ nào. Cùng một năng lực kỹ thuật có thể bán thành dự án đo ni đóng giày, quyền sử dụng có thu phí, dữ liệu, hoặc cho đi miễn phí để thu tiền ở lớp dịch vụ phía trên; mỗi cách kéo theo chi phí và rủi ro khác nhau. Với chủ doanh nghiệp Việt Nam, câu hỏi có hai mặt: bán năng lực AI ra sao, và khi mua thì nên thuê, cấp phép hay tự xây.
Khái niệm cốt lõi và thuật ngữ
Năm mô hình dưới đây khác nhau ở chỗ doanh nghiệp bán cái gì và giữ lại cái gì: công sức theo dự án, quyền dùng một tài sản, dữ liệu, lõi mở kèm dịch vụ, hoặc sự kết hợp của chúng.
- Giải pháp AI theo dự án (AI solutions): xây hệ thống riêng cho từng khách, thu phí triển khai và vận hành.
- Cấp phép AI (AI licensing): cho bên khác quyền dùng công nghệ, dữ liệu hoặc nền tảng và thu phí.
- Kiếm tiền từ dữ liệu (data monetization): biến dữ liệu thành doanh thu trực tiếp hoặc gián tiếp.
- Mã nguồn mở (open source): công bố công cụ, mô hình cho mọi người dùng và đóng góp; thu tiền ở lớp dịch vụ bao quanh.
- Mô hình lai (hybrid): kết hợp công nghệ tự sở hữu, thành phần mở, đối tác, nhiều dòng doanh thu.
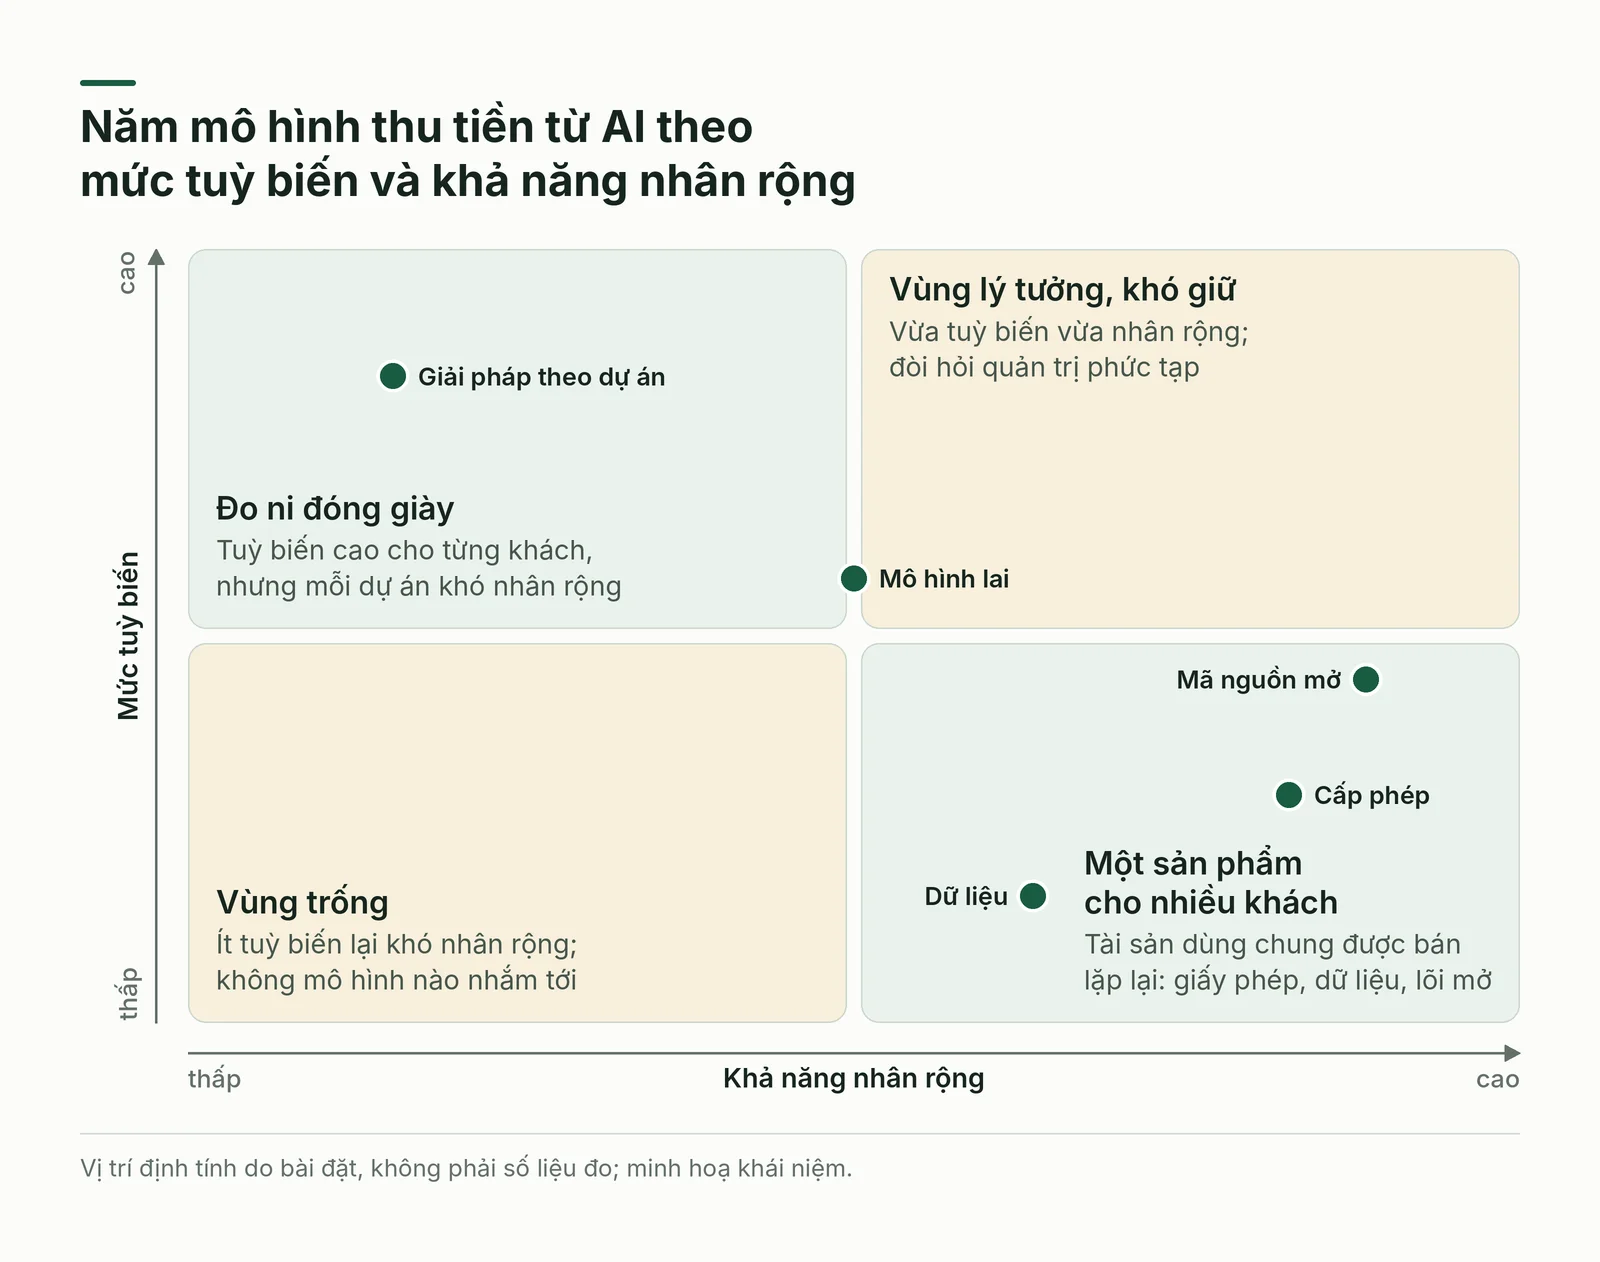
Hình 1 xếp năm mô hình theo mức tuỳ biến cho từng khách và khả năng nhân rộng: giải pháp theo dự án tuỳ biến cao nhưng khó nhân rộng, cấp phép ngược lại, mô hình lai cố chiếm vùng giữa và trả giá bằng độ phức tạp quản trị. Vị trí trên hình mang tính định tính.
Giải pháp theo dự án và cấp phép: hai cách bán năng lực AI
Giải pháp theo dự án bán kết quả chứ không bán công cụ: chẩn đoán vấn đề cùng khách, chuẩn bị dữ liệu, huấn luyện mô hình, tích hợp vào quy trình sẵn có, rồi vận hành và cải tiến. Lợi ích thường nêu là tuỳ biến, năng suất, trải nghiệm khách hàng, quyết định dựa trên dữ liệu, lợi thế cạnh tranh; mỗi lợi ích chỉ đến khi vượt qua một khó khăn quen thuộc: dữ liệu đủ tốt, nhân lực hiếm, hệ thống cũ khó tích hợp, thiên lệch, bài toán hoàn vốn. Nên kiểm tra các điều kiện này trước khi báo giá.
Cấp phép bán quyền dùng một tài sản đã có thay vì bán công sức mới cho từng khách. Mô hình cần danh mục sở hữu trí tuệ đủ khác biệt, hợp đồng nêu rõ được làm gì và không được làm gì, cùng đề xuất giá trị rõ cho bên nhận phép. Đối tượng cấp phép gồm công nghệ, dữ liệu (để bên nhận huấn luyện mô hình riêng) và nền tảng (cả bộ công cụ xây và vận hành ứng dụng).
Bên cấp phép thu lại chi phí nghiên cứu và mở thêm thị trường; bên nhận phép có công nghệ nhanh mà không tự chịu chi phí nghiên cứu, hạ tầng, thuê chuyên gia. Cần cân nhắc: bảo hộ bằng sáng chế, bản quyền hoặc bí mật kinh doanh; điều khoản rõ về quyền và nghĩa vụ; duy trì chất lượng, vì công cụ chạy kém làm tổn hại uy tín bên cấp phép; hiểu đối thủ trước khi định giá. Công ty làm dự án có thể tách phần lặp lại thành mô-đun cấp phép để doanh thu bớt phụ thuộc số giờ công.
Dữ liệu, mã nguồn mở và mô hình lai: ba cách kiếm tiền gián tiếp
Dữ liệu có ba đường ra thành tiền: bán bộ dữ liệu độc đáo qua sàn hoặc nhà môi giới; bán dịch vụ dựa trên dữ liệu như tư vấn, mô hình dự báo, trực quan hoá; hoặc đưa dữ liệu vào sản phẩm của mình để cá nhân hoá và giữ chân khách. Đường thứ ba thường ít vướng pháp lý nhất vì dữ liệu không rời doanh nghiệp. Cả ba cùng chịu ba ràng buộc: quyền riêng tư và an ninh (cần sự đồng ý của chủ thể dữ liệu), chất lượng và quản trị, đạo đức.
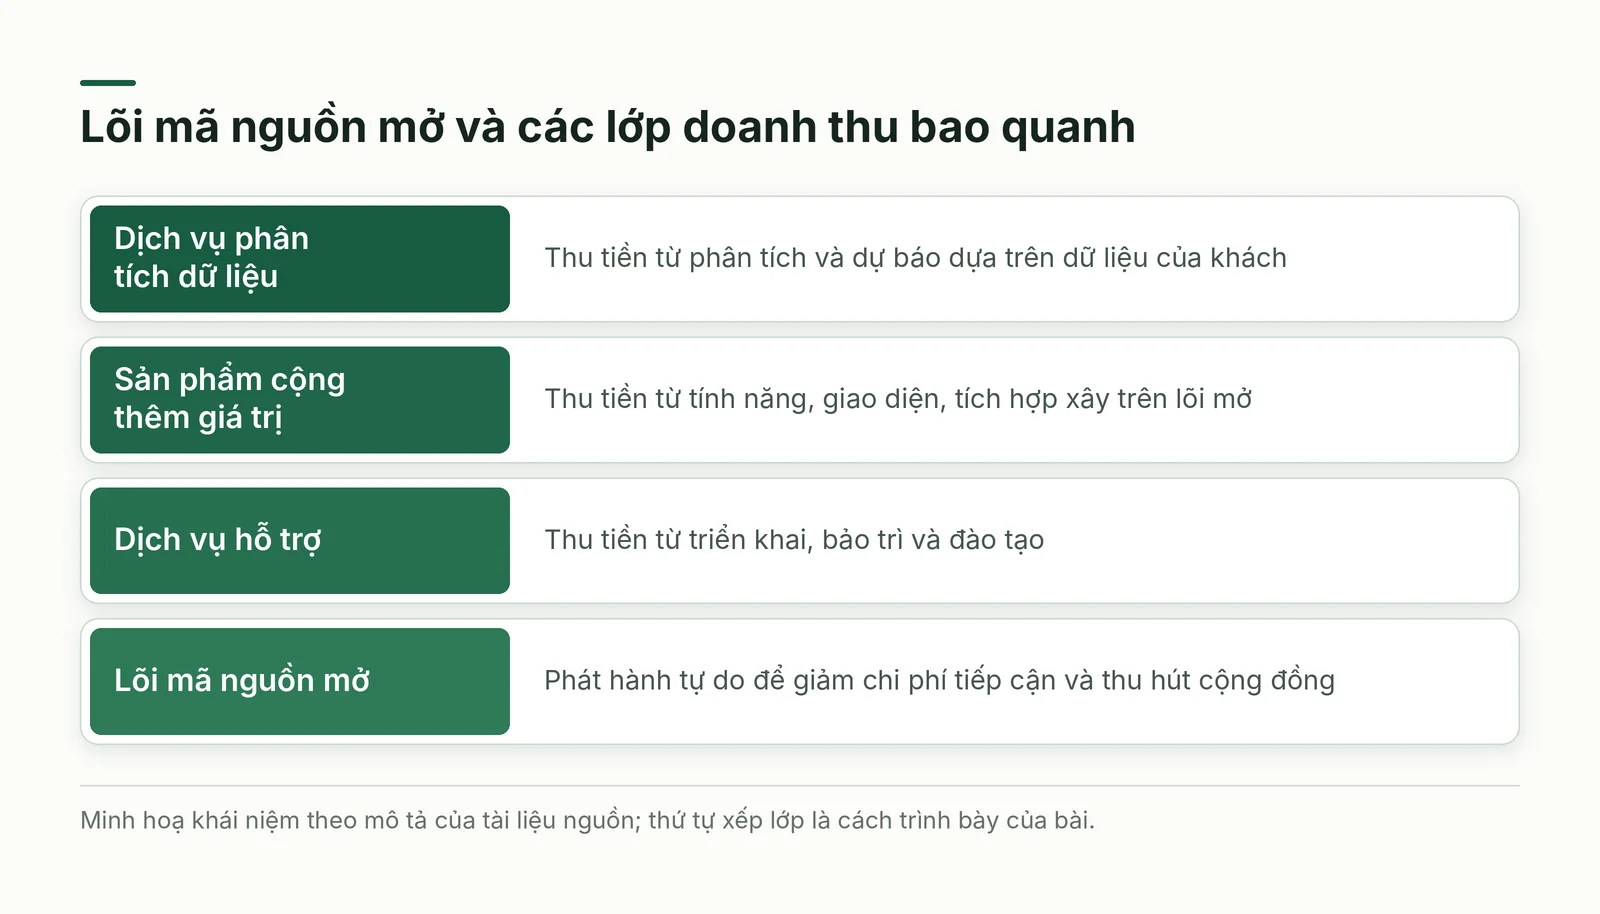
Mã nguồn mở đảo ngược logic bán hàng: phần lõi phát hành tự do để giảm chi phí tiếp cận và thu hút cộng đồng. Nhà phát triển có sẵn thư viện như TensorFlow, PyTorch, scikit-learn; cộng đồng cùng sửa lỗi, đánh giá chéo; doanh nghiệp tuỳ biến theo dữ liệu riêng và dựng bản thử nghiệm nhanh. Tiền đến từ ba lớp bao quanh: dịch vụ hỗ trợ (triển khai, bảo trì, đào tạo), sản phẩm cộng thêm giá trị xây trên lõi mở, và dịch vụ phân tích dữ liệu.
Mở phần lõi để lan nhanh, thu tiền ở lớp mà khách hàng không muốn hoặc không thể tự làm.
Mô hình lai ghép các mảnh trên: công nghệ độc quyền cùng thành phần mở, hợp tác với trường, viện, doanh nghiệp khác, và nhiều dòng doanh thu như bán thông tin rút ra từ phân tích, vận hành sàn dữ liệu có AI kiểm tra chất lượng, hoặc AI dạng dịch vụ. Điển hình là liên minh nhiều bên cùng góp dữ liệu nhưng giữ dữ liệu riêng tư; chưa rõ quyền sở hữu, chia lợi ích và an toàn dữ liệu thì khó vượt giai đoạn thử nghiệm.
Con đường của các hãng lớn và startup
Sáu nhóm dưới đây thường được nêu làm ví dụ thành công; mỗi nơi dựa vào một tài sản khan hiếm khác nhau. Mô tả theo tài liệu nguồn (bản quyền 2022) nên một số chi tiết có thể đã đổi.
- Google, Amazon: nhúng AI vào cỗ máy doanh thu sẵn có (tìm kiếm, quảng cáo, thương mại điện tử), hưởng vòng lặp dữ liệu, mở nền tảng cho bên thứ ba.
- IBM: bán chuyên môn ngành qua nền tảng Watson, giải pháp theo ngành, tư vấn, hợp tác và mua lại; bài học ở mục ví dụ quốc tế.
- OpenAI: lai thương mại và mở; vừa bán sản phẩm, hợp tác doanh nghiệp, vừa công bố nghiên cứu, vài công cụ mở, tham gia thảo luận chính sách.
- Nvidia: lấy hạ tầng làm gốc; GPU cùng bộ công cụ lập trình và chương trình ươm tạo startup giữ nhà phát triển ở lại hệ sinh thái.
- Baidu: lợi thế dữ liệu bản địa; dữ liệu tìm kiếm nuôi đồ thị tri thức rồi sinh sản phẩm như lái xe tự động, trợ lý giọng nói, ứng dụng y tế.
- Startup: hẹp và nhanh; chọn một nỗi đau của ngành, xây trên khung mở, bán qua thuê bao để khách nhỏ dùng mà không đầu tư lớn.
Cả sáu đều nắm một tài sản khó sao chép (dữ liệu người dùng, chip, kênh phân phối), dựng hệ sinh thái nhà phát triển hoặc đối tác, và gắn AI vào động cơ doanh thu rõ ràng. Doanh nghiệp nhỏ không cần quy mô của họ, nhưng vẫn phải trả lời ba câu hỏi ấy.
Năm nhóm điều kiện quyết định AI có sinh lời
Dữ liệu là điều kiện đầu tiên và khó mua nhất. Chất lượng gồm hợp lệ, đầy đủ, nhất quán; tính đại diện gồm các nhóm người, nhiều nguồn (có cấu trúc, văn bản, hình ảnh, cảm biến) và độ cập nhật; về lượng cần đủ mẫu, hệ thống mở rộng được, và khi thiếu thì tăng cường dữ liệu (data augmentation) bằng biến đổi hoặc dữ liệu tổng hợp.
Hạ tầng quyết định chi phí và tốc độ: GPU hiệu năng cao, đám mây co giãn, điện toán biên cho ứng dụng cần độ trễ thấp, kho và hồ dữ liệu, xử lý luồng thời gian thực. Học chuyển giao (transfer learning, tận dụng mô hình huấn luyện sẵn) cần ít dữ liệu nên hợp doanh nghiệp nhỏ.
Nhân lực gồm nhà khoa học dữ liệu, chuyên gia học máy, người hiểu nghiệp vụ để định nghĩa đúng bài toán, nhóm nghiên cứu tinh chỉnh mô hình và thói quen học liên tục. Tại Việt Nam, khảo sát 100 đơn vị trong Báo cáo thường niên về AI 2025 (Viện Công nghệ Thông tin, ĐHQG Hà Nội, tháng 7 đến 10/2025) cho thấy 45% doanh nghiệp cung cấp AI coi thiếu nhân lực chất lượng cao là rào cản lớn nhất, gần gấp đôi mức 23% gặp khó về hạ tầng tính toán và dữ liệu[2].
Tuân thủ và đạo đức gồm bảo vệ dữ liệu cá nhân (như GDPR của châu Âu hoặc luật từng nước), đồng ý rõ ràng, công bằng, khả năng giải thích, kiểm toán thuật toán, quy định riêng của ngành, sở hữu trí tuệ, trách nhiệm pháp lý cho quyết định do AI đưa ra và tác động môi trường của hạ tầng AI.
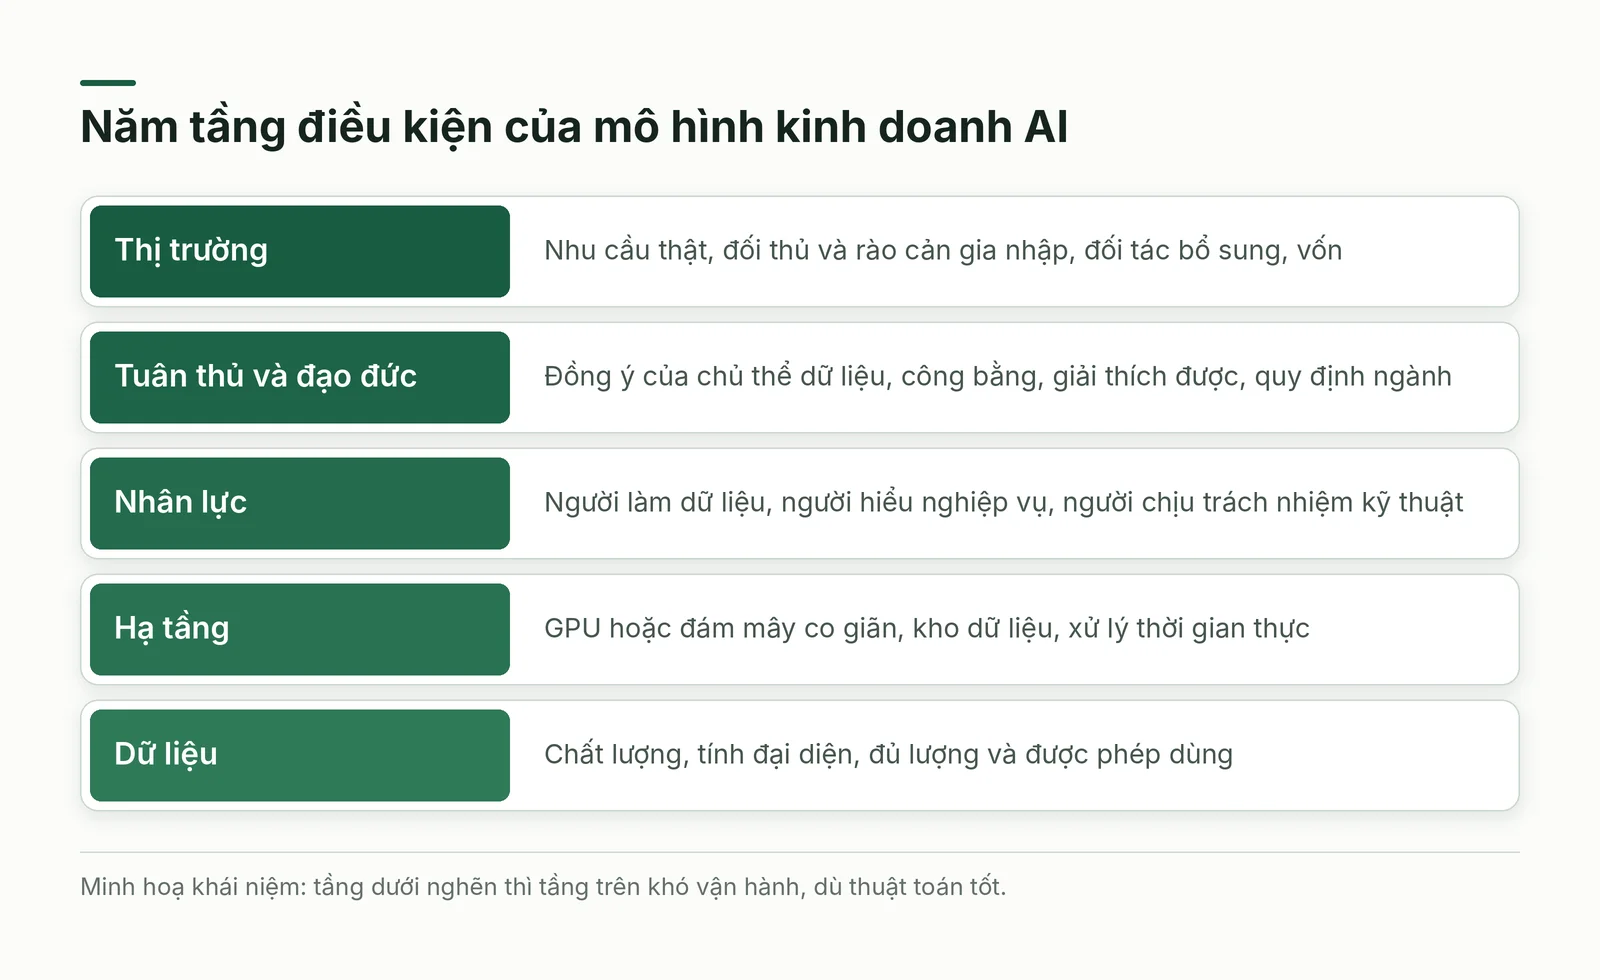
Cuối cùng là thị trường: nhu cầu thật, đối thủ và rào cản gia nhập, đối tác bổ sung, khả năng huy động vốn. Năm nhóm xếp chồng như Hình 3: tầng dưới nghẽn thì tầng trên không vận hành được, dù thuật toán có tốt đến đâu.
Bốn nhóm rủi ro và cách giảm
Rủi ro riêng tư bắt đầu từ khâu thu thập: cần đồng ý đầy đủ thông tin, chỉ lấy dữ liệu cần thiết, xoá khi hết nhu cầu. Ẩn danh hoá giảm rủi ro nhưng không tuyệt đối, vì ghép nhiều bộ dữ liệu có thể xác định lại danh tính. Về bảo mật, hệ thống AI là mục tiêu của tấn công mạng và sơ suất nội bộ, nên cần mã hoá, kiểm soát truy cập, chống sửa đổi dữ liệu; luật lưu dữ liệu trong lãnh thổ và quy định theo ngành thêm lớp tuân thủ.
Thiên lệch có ba nguồn: dữ liệu (thiếu đại diện, lấy mẫu lệch, nhãn sai), thuật toán (chọn đặc trưng, gán trọng số) và tương tác (phản hồi thiên kiến của người dùng bị khuếch đại). Hậu quả là phân biệt đối xử trong tuyển dụng, cho vay, y tế, củng cố định kiến, mất niềm tin. Cách giảm: dữ liệu đa dạng; chỉ số công bằng như cân bằng nhân khẩu học (tỷ lệ nhận kết quả tích cực ngang nhau giữa các nhóm); con người giám sát; khả năng giải thích.
Chi phí AI đến từ hạ tầng và GPU, dữ liệu, nhân lực khan hiếm, nghiên cứu liên tục; độ phức tạp đến từ hệ thống cũ, quy định, vận hành ổn định. Năm cách giảm: hợp tác với nhà cung cấp hoặc viện nghiên cứu; thuê đám mây và AI dạng dịch vụ; dùng AutoML (tự động hoá chuẩn bị dữ liệu, chọn mô hình); chia sẻ dữ liệu với đối tác; đào tạo nhân viên hiện có.
Nhà cung cấp mang lại chuyên môn, hạ tầng, tốc độ, nhưng kèm ba rủi ro: khoá nhà cung cấp (vendor lock-in) làm chi phí chuyển đổi tăng dần, chất lượng không khớp nhu cầu, nhà cung cấp ngừng hỗ trợ. Bốn biện pháp: dùng nhiều nhà cung cấp; hợp đồng có chỉ số, thoả thuận mức dịch vụ (SLA) và phương án thoát; xây năng lực nội bộ để đánh giá giải pháp ngoài; giữ quyền sở hữu dữ liệu.
Cách áp dụng từng bước
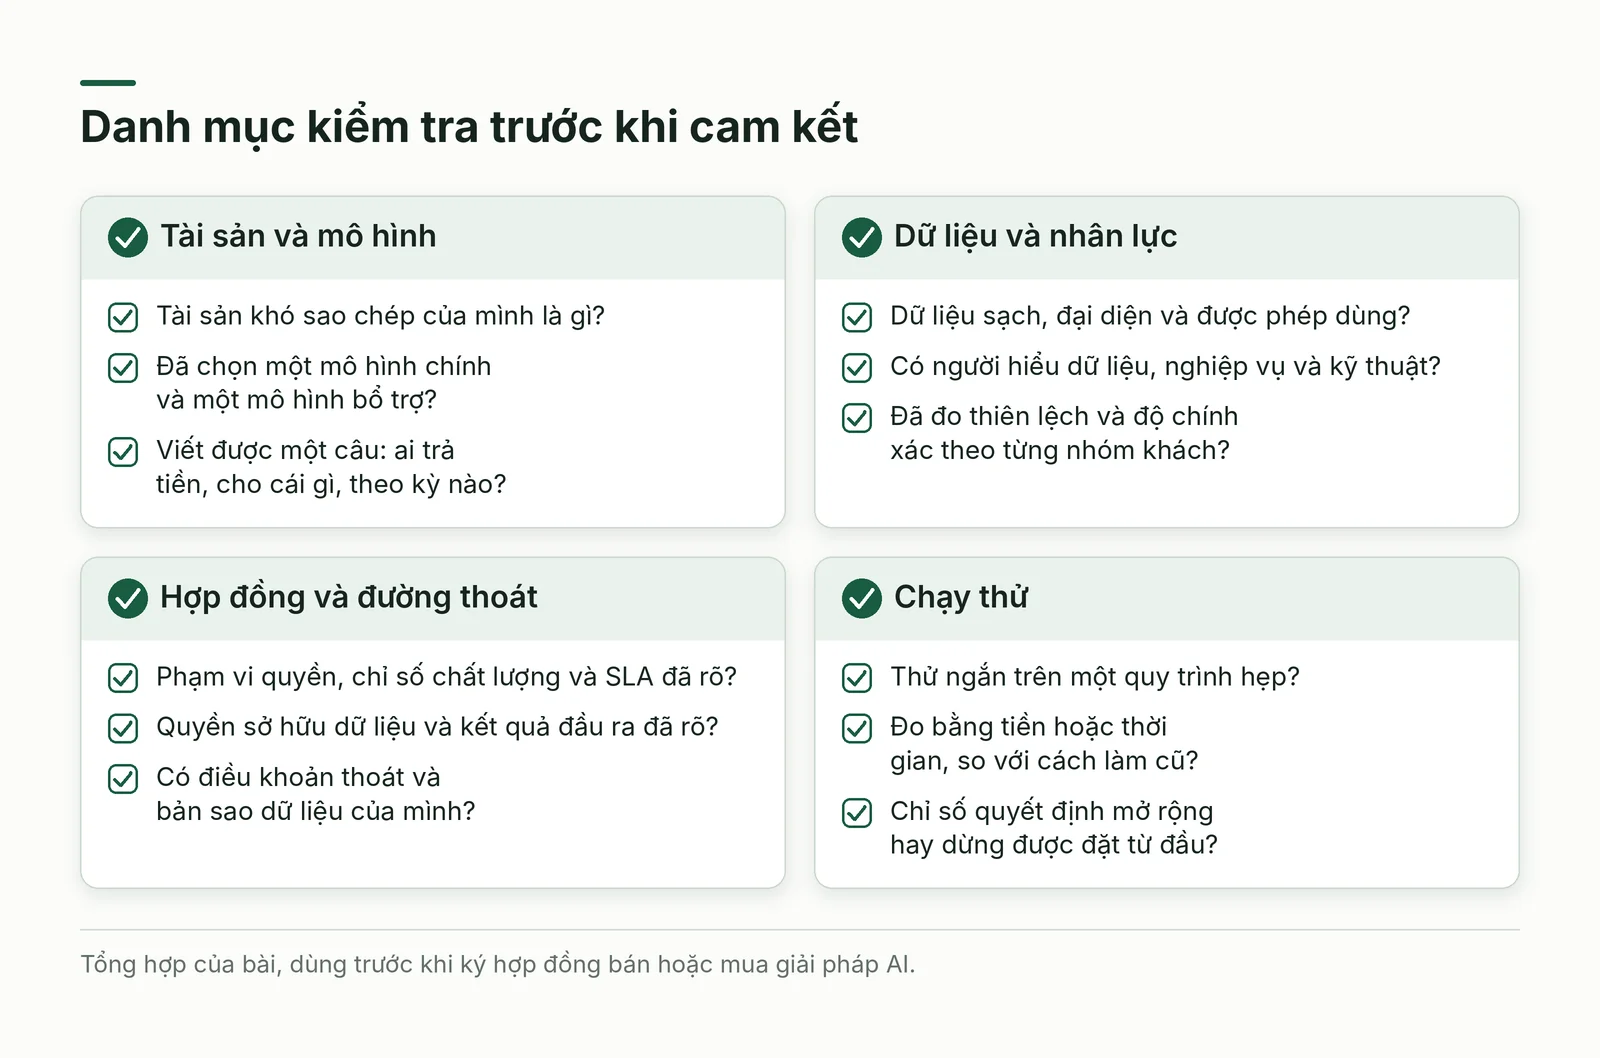
- Bước 1: Kiểm kê tài sản (dữ liệu, mô hình, chuyên môn ngành, khách hàng, kênh bán); thứ khó sao chép nhất quyết định mô hình chính.
- Bước 2: Chọn một mô hình chính và một mô hình bổ trợ theo Hình 1, rồi viết thành một câu: ai trả tiền, cho cái gì, theo kỳ nào.
- Bước 3: Kiểm tra điều kiện nền: chất lượng và quyền dùng dữ liệu; nhân lực tối thiểu gồm người hiểu dữ liệu, người hiểu nghiệp vụ, người chịu trách nhiệm kỹ thuật.
- Bước 4: Soạn hợp đồng và giá: phạm vi quyền, chỉ số chất lượng, SLA, quyền sở hữu dữ liệu và kết quả đầu ra, điều khoản thoát.
- Bước 5: Chạy thử 4 đến 8 tuần trên một quy trình hẹp, đo bằng tiền hoặc thời gian, so với cách làm cũ.
- Bước 6: Giám sát thiên lệch, độ chính xác theo nhóm khách, chi phí điện toán; rồi mở rộng hoặc dừng.
Ví dụ quốc tế: hạ tầng, giấy phép có điều kiện và bài học từ y tế
Trong năm tài chính 2026 (kết thúc 25/1/2026), Nvidia báo doanh thu 215,9 tỷ USD, trong đó mảng trung tâm dữ liệu 193,7 tỷ USD, khoảng 90%[3]. Ở thái cực mở, giấy phép Llama 4 (hiệu lực từ 5/4/2025) buộc bên có sản phẩm trên 700 triệu người dùng hoạt động hằng tháng phải xin phép riêng Meta, và yêu cầu ghi nhận Llama trên sản phẩm[4]. Vậy nên mở trong AI thường là mở có điều kiện.
Bài học ngược chiều đến từ y tế. Tháng 1/2022, IBM bán mảng dữ liệu và phân tích cốt lõi của Watson Health cho quỹ Francisco Partners, giá không công bố; theo STAT, mảng này chưa có lãi và IBM gặp khó khi tích hợp dữ liệu, văn hoá của nhiều doanh nghiệp đã mua lại[5]. Giải pháp theo ngành cần chiều sâu dữ liệu, không chỉ chiều rộng.
Tình huống áp dụng tại Việt Nam
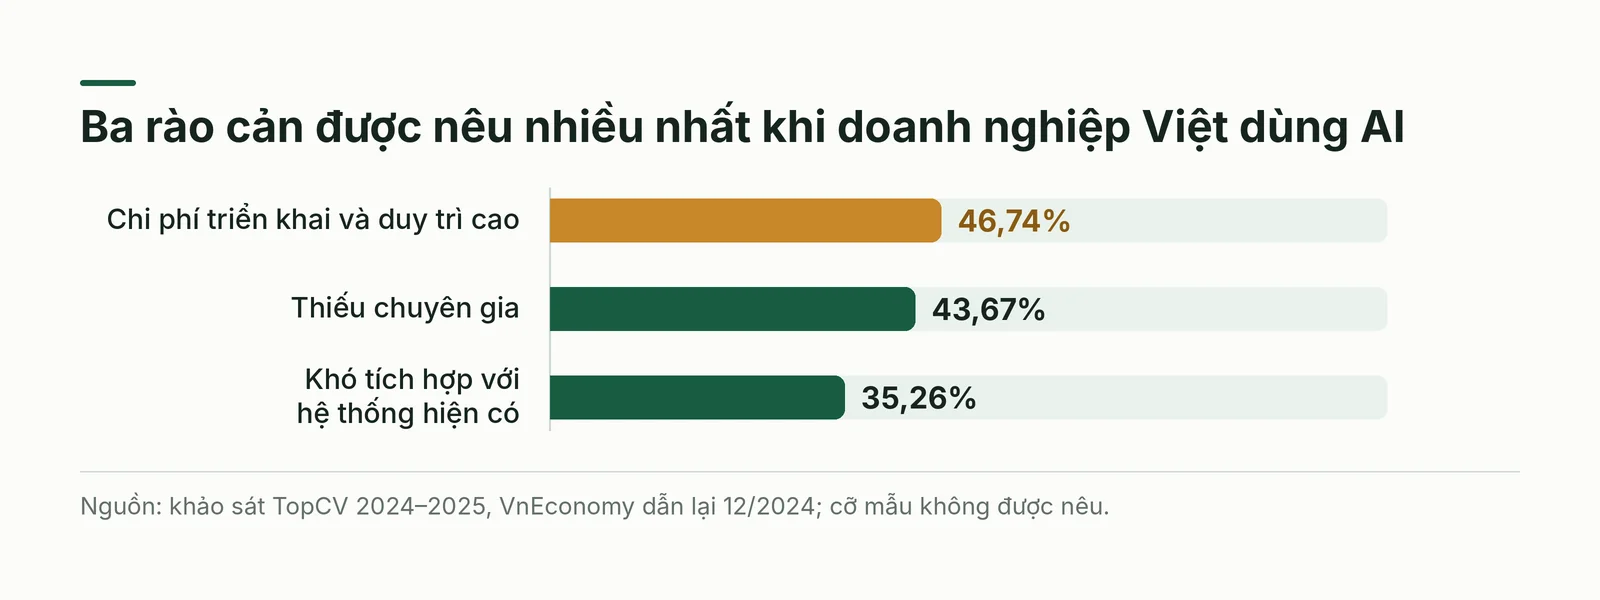
Phía mua trước: theo khảo sát của TopCV trong báo cáo thị trường tuyển dụng 2024–2025, VnEconomy dẫn lại tháng 12/2024, 46,74% doanh nghiệp coi chi phí triển khai và duy trì cao là rào cản lớn nhất khi dùng AI, 43,67% nêu thiếu chuyên gia, 35,26% khó tích hợp với hệ thống hiện có[6]. Bài báo không nêu cỡ mẫu nên chỉ đọc như tín hiệu. Ba rào cản này khớp ba cách giảm ở trên: thuê hạ tầng, dùng nền tảng có sẵn, chọn đối tác tích hợp.
Về hạ tầng, tháng 4/2024 FPT công bố biên bản ghi nhớ với NVIDIA, dự kiến đầu tư 200 triệu USD cho nhà máy AI dùng GPU H100, cung cấp đám mây có chủ quyền và dịch vụ cho thuê GPU cho doanh nghiệp[7][8]. Doanh nghiệp nhỏ thuê sức mạnh tính toán thay vì mua GPU, nhưng cần tính rủi ro phụ thuộc nếu toàn bộ hệ thống chạy trên một nền tảng.
Về mã nguồn mở, VinAI giới thiệu PhởGPT ngày 5/12/2023 tại AI Day ở TP HCM như dự án nghiên cứu mã nguồn mở về mô hình ngôn ngữ lớn tiếng Việt, huấn luyện từ đầu; lãnh đạo VinAI cho biết không giới hạn mục đích thương mại[9]. Mô hình mở hạ ngưỡng thử nghiệm vì có thể tinh chỉnh bằng dữ liệu riêng; lợi thế của doanh nghiệp nằm ở dữ liệu, tích hợp và dịch vụ.
Về dữ liệu, Luật Dữ liệu số 60/2024/QH15 (hiệu lực 1/7/2025) quy định riêng dịch vụ trung gian, phân tích và tổng hợp dữ liệu, cùng sàn dữ liệu do đơn vị sự nghiệp công lập hoặc doanh nghiệp nhà nước vận hành; dữ liệu chưa được chủ thể đồng ý không được giao dịch, trừ trường hợp luật có quy định khác[10].
Luật Bảo vệ dữ liệu cá nhân số 91/2025/QH15 (hiệu lực 1/1/2026) cấm mua, bán dữ liệu cá nhân, trừ trường hợp luật khác có quy định[1]; theo tóm tắt của Cổng thông tin tỉnh Hà Tĩnh, mức phạt có thể tới 10 lần khoản thu có được từ vi phạm[11]. Đường bán dữ liệu cá nhân vì vậy bị đóng; dịch vụ phân tích và dùng dữ liệu cải thiện sản phẩm là hai đường an toàn hơn. Đây là tóm tắt thông tin, không phải tư vấn pháp lý.
Sai lầm thường gặp, giới hạn và khi nào không nên dùng
Gốc chung của phần lớn sai lầm là chọn mô hình theo xu hướng thay vì theo tài sản, rồi đánh giá thấp những khoản chi nằm ngoài thuật toán. Bốn lỗi dưới đây đều phát hiện được sớm nếu kiểm tra trước khi ký hợp đồng bán hoặc mua AI.
- Chỉ tính chi phí huấn luyện mô hình, bỏ qua dữ liệu, tích hợp, vận hành và nhân lực.
- Coi mở là miễn phí, không điều kiện, và không đọc giấy phép của mô hình hay thư viện đang dùng.
- Bán hoặc chia sẻ dữ liệu khi chưa rõ cơ sở pháp lý và sự đồng ý của chủ thể dữ liệu.
- Gắn toàn bộ hệ thống vào một nhà cung cấp, không có điều khoản thoát và bản sao dữ liệu của mình.
Giới hạn của bài: mô tả hãng lớn lấy từ tài liệu năm 2022 trong khi thị trường đổi nhanh; số liệu Việt Nam đến từ báo chí và khảo sát không phải lúc nào cũng nêu cỡ mẫu. Chưa nên dùng AI khi chưa có bài toán đo được, dữ liệu chưa đủ tốt hoặc chưa được phép dùng, hay khi phần mềm thông thường giải quyết được với chi phí thấp hơn.
Kế hoạch thử nghiệm 2–4 tuần và câu hỏi tự kiểm
Kế hoạch dưới đây dành cho nhóm 3 đến 5 người muốn quyết định có theo đuổi một mô hình AI hay không mà chưa cần chi tiền lớn. Mỗi tuần kết thúc bằng một đầu ra cụ thể, và tuần cuối là điểm quyết định.
- Tuần 1: kiểm kê tài sản, chọn một mô hình chính, viết câu mô tả ai trả tiền cho cái gì.
- Tuần 2: đánh giá chất lượng và quyền sử dụng dữ liệu trên mẫu nhỏ; xin báo giá từ ít nhất hai nhà cung cấp.
- Tuần 3: chạy thử trên một quy trình hẹp, ghi chi phí thật và kết quả theo nhóm khách.
- Tuần 4: quyết định mở rộng, đổi mô hình hoặc dừng, dựa trên chỉ số đã chọn từ đầu.
Câu hỏi tự kiểm: nếu nhà cung cấp chính ngừng dịch vụ vào tháng sau, mình mất gì và mất bao lâu để khôi phục? Nhóm khách nào có thể bị mô hình đối xử kém hơn, và mình đo điều đó bằng cách nào?
Kết luận
Chọn mô hình kinh doanh AI là chọn cách biến một tài sản khan hiếm thành dòng tiền, rồi chuẩn bị đủ dữ liệu, hạ tầng, nhân lực, tuân thủ và đối tác để dòng tiền bền. Phần 3 của chuỗi bàn tiếp về rủi ro pháp lý, đạo đức, niềm tin công chúng, xu hướng tương lai và cách tự xây mô hình kinh doanh AI.
Nguồn và phương pháp
Bài là tổng hợp và phân tích có hỗ trợ AI, diễn đạt lại bằng lời riêng, không phải bản dịch. Phần khái niệm dựa trên tài liệu 'AI Business Models' (Daniel Pereira, bản quyền 2022), phần giữa (trang 73 đến 134 của bản PDF), được sắp xếp lại theo câu hỏi của người đọc; bản đồ năm mô hình, danh mục kiểm tra và các nhận định so sánh là phân tích của bài, không phải của tài liệu.
Số liệu và sự kiện thực tế lấy từ các nguồn web đánh số trong bài, truy cập ngày 20/10/2026. Điều chưa kiểm chứng: cỡ mẫu khảo sát TopCV không được nêu; mô tả về Google, Amazon, IBM, OpenAI, Nvidia và Baidu theo tài liệu năm 2022 có thể đã thay đổi; văn bản pháp luật được tóm tắt qua trang tổng hợp pháp lý nên cần đối chiếu bản gốc. Nên đọc tài liệu gốc để có đầy đủ chi tiết.