
Nền móng của lợi thế cạnh tranh: hiểu khách, chọn phương pháp nghiên cứu và thu thập dữ liệu (Phần 1/5)
Đăng ngày 23/10/2026
Mục lục bài nghiên cứu
Tóm tắt và điều cần nhớ
Đây là phần 1/5 của chuỗi năm bài về việc dùng nghiên cứu thị trường để tạo lợi thế cạnh tranh: phần này đặt nền về quyết định cần nghiên cứu, cách chọn phương pháp, cách thu dữ liệu và những cái bẫy cần tránh. Phần 2 đi tiếp với nhóm thảo luận, chân dung người mua và các khung phân tích.
- Nghiên cứu chỉ đáng làm khi gắn với một quyết định cụ thể.
- Đọc nguồn có sẵn (thứ cấp) trước khi tự hỏi khách: rẻ, nhanh, giúp câu hỏi sắc hơn.
- Định tính cho biết vì sao, định lượng cho biết bao nhiêu; muốn suy ra cho cả thị trường thì mẫu phải đại diện.
- Khách cá nhân, khách doanh nghiệp và mô hình qua trung gian cần cách nghiên cứu khác nhau.
- AI đọc dữ liệu rất nhanh nhưng không tự khách quan; vẫn cần người đặt câu hỏi và kiểm tra mẫu.
- Dữ liệu cá nhân chỉ thu cho mục đích rõ ràng, kèm sự đồng ý đúng cách.
Nghiên cứu thị trường phục vụ quyết định nào
Nghiên cứu thị trường là việc thu thập, phân tích và diễn giải có hệ thống thông tin về thị trường, khách hàng và đối thủ. Giá trị của nó nằm ở chỗ đổi một quyết định từ đoán sang có căn cứ. Lợi thế cạnh tranh thường đến từ việc hiểu khách và thị trường sớm hơn, đúng hơn đối thủ, chứ không chỉ từ vốn hay quy mô.
Phần lớn quyết định cần nghiên cứu thuộc ba nhóm: ai là khách và họ còn thiếu gì; nên đổi gì ở sản phẩm, giá, kênh bán hay thông điệp; thị trường và đối thủ đang dịch chuyển ra sao. Ba hiểu lầm khiến doanh nghiệp nhỏ bỏ qua việc này: chỉ công ty lớn mới làm được, một cuộc khảo sát là đủ, có số liệu thì khỏi hỏi vì sao.
Khái niệm cốt lõi và thuật ngữ
Một nghiên cứu có thể được gọi tên theo bốn trục. Nắm bốn trục này là đủ để đọc hầu hết tài liệu về nghiên cứu thị trường và để trao đổi với đơn vị nghiên cứu thuê ngoài mà không bị lạc.
- Theo nguồn: sơ cấp là dữ liệu bạn tự thu; thứ cấp là dữ liệu người khác đã thu rồi công bố, chẳng hạn niên giám thống kê, ấn phẩm của hiệp hội ngành, báo cáo tài chính doanh nghiệp.
- Theo bản chất dữ liệu: định tính là lời nói, chữ viết, hình ảnh để hiểu động cơ; định lượng là con số trên nhiều người để đo và kiểm tra giả thuyết.
- Theo mục đích: khám phá để định hình vấn đề, mô tả để biết quy mô và đặc điểm, nhân quả để xem đổi một yếu tố thì kết quả có đổi không.
- Theo đối tượng: khách hàng, phân khúc (nhóm khách có điểm chung đủ rõ để phục vụ riêng), đối thủ hoặc cả ngành.
Bốn câu hỏi trước khi chọn phương pháp
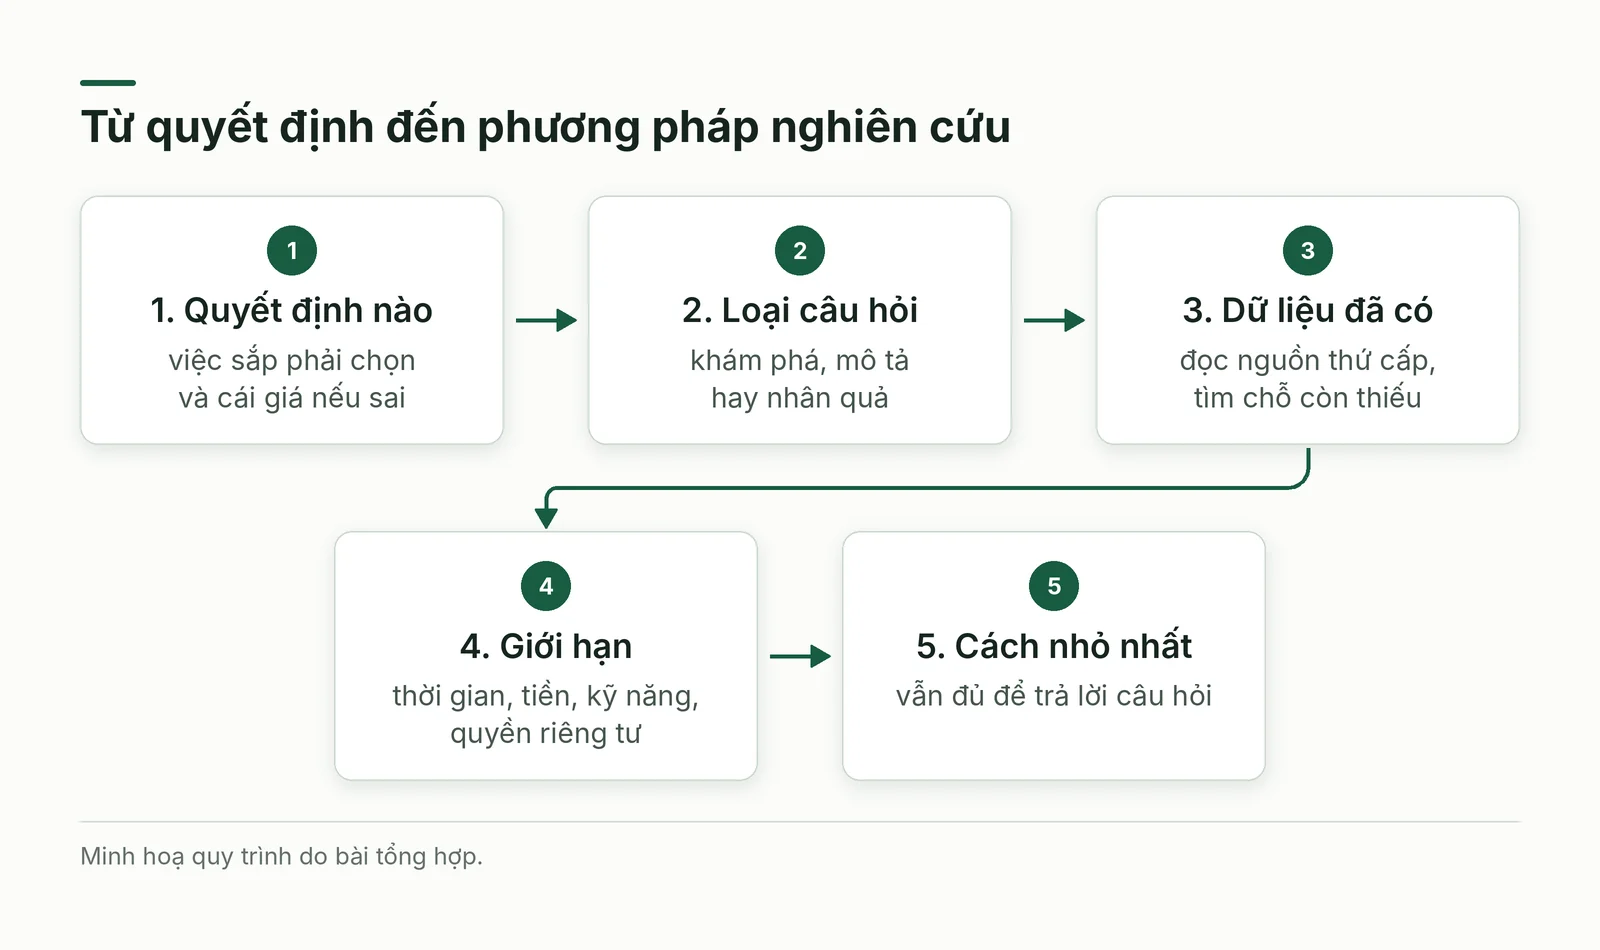
Sai lầm phổ biến là chọn phương pháp trước rồi mới nghĩ đến câu hỏi, chẳng hạn cứ gặp việc là làm khảo sát. Hãy đảo thứ tự bằng bốn câu hỏi dưới đây (Hình 1); trả lời xong, phương pháp thường tự lộ ra.
- Bước 1: Quyết định nào sắp phải đưa ra, và nếu sai thì mất gì? Quyết định càng đắt, bằng chứng càng phải chắc.
- Bước 2: Câu hỏi thuộc loại nào: khám phá (hợp phỏng vấn, quan sát), mô tả (hợp khảo sát, thống kê) hay nhân quả (hợp thử nghiệm)?
- Bước 3: Ai đã thu dữ liệu tương tự chưa? Đọc nguồn thứ cấp trước để biết chỗ còn thiếu.
- Bước 4: Thời gian, tiền, kỹ năng và giới hạn về quyền riêng tư cho phép đi xa đến đâu? Chọn cách nhỏ nhất vẫn đủ trả lời.
Sơ cấp hay thứ cấp: đọc cái có sẵn trước
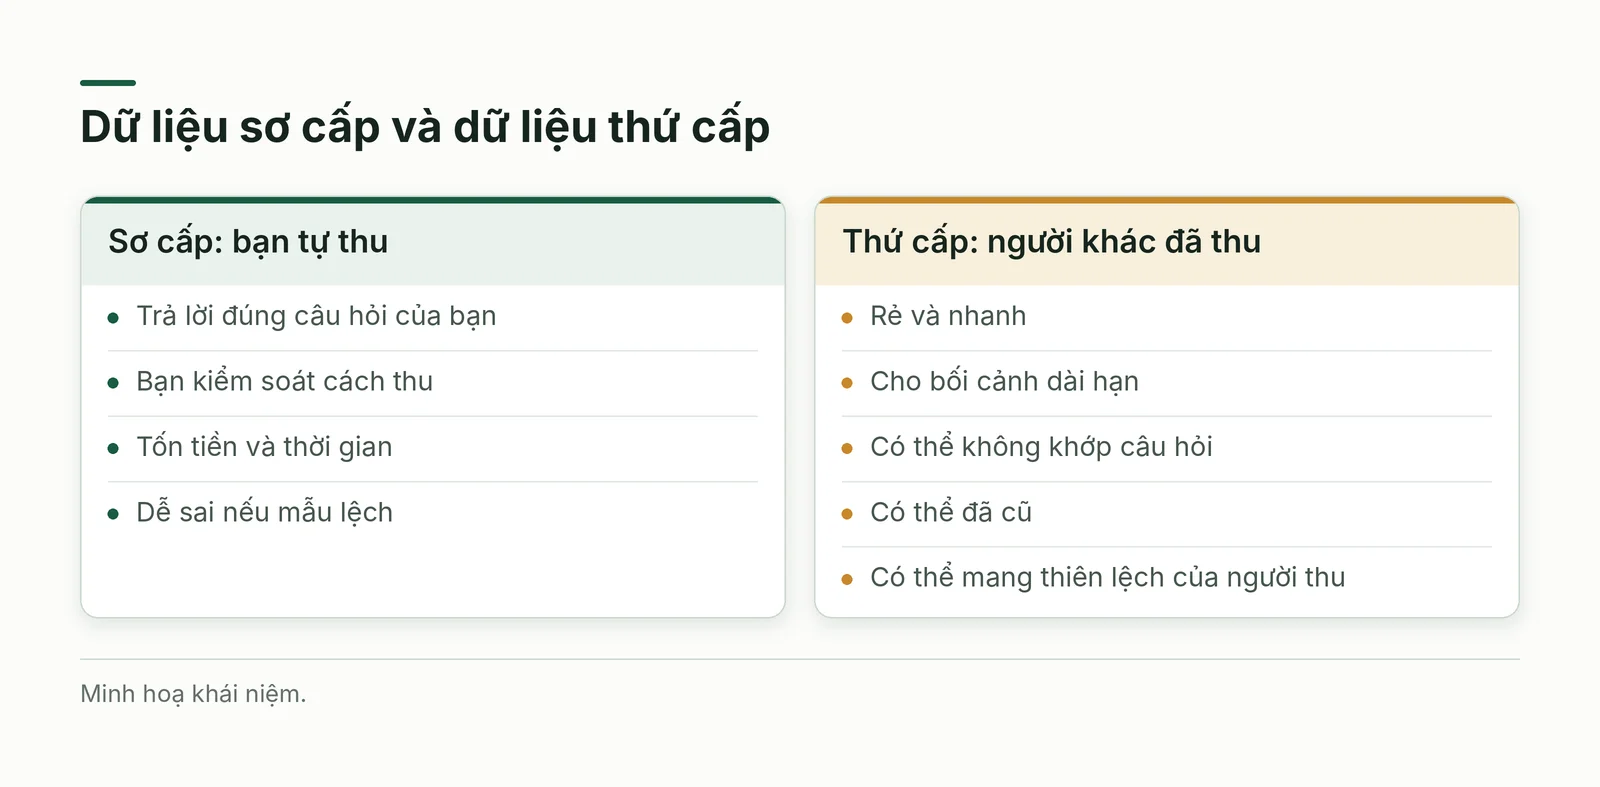
Dữ liệu sơ cấp trả lời đúng câu hỏi của bạn và do bạn kiểm soát cách thu, nhưng tốn tiền, tốn thời gian và dễ sai nếu mẫu lệch. Dữ liệu thứ cấp rẻ, nhanh, cho bối cảnh dài hạn, nhưng có thể không khớp câu hỏi, đã cũ hoặc mang thiên lệch của người thu (Hình 2).
Quy tắc thực dụng là đi từ thứ cấp sang sơ cấp. Số liệu thống kê chính thức, nghiên cứu của hiệp hội ngành, báo cáo thường niên, trang web của đối thủ, bài học thuật và tin tức giúp thấy chỗ trống kiến thức và viết câu hỏi khảo sát sắc hơn. Khi đã biết mình thật sự thiếu gì, khoản chi cho dữ liệu sơ cấp mới đáng đồng tiền.
Chín cách thu thập dữ liệu và chỗ mạnh, chỗ yếu của từng cách
Mỗi cách dưới đây mạnh ở một loại câu hỏi và yếu ở một chỗ, nên hãy ghép ít nhất hai cách. Một gợi ý: dữ liệu có sẵn để định hướng, phỏng vấn hoặc quan sát để hiểu, khảo sát để đo, thử nghiệm để kiểm tra nguyên nhân.
- Phỏng vấn (có cấu trúc, bán cấu trúc hoặc mở; phỏng vấn sâu đào kỹ một chủ đề): moi được động cơ, hỏi tiếp được, nhưng tốn công và khó đại diện.
- Khảo sát (mô tả, so sánh nhóm hoặc tìm quan hệ giữa các biến): đo được trên nhiều người, chi phí vừa phải; chất lượng tuỳ vào câu hỏi và mẫu.
- Thử nghiệm (phòng kín, thực địa, A/B trên mạng): so hai nhóm tương đương để thấy nguyên nhân; cần mẫu đủ lớn, cân nhắc đạo đức; bản thực địa còn cho thấy sản phẩm chạy ra sao ngoài đời.
- Quan sát (tự nhiên, theo bảng tiêu chí hoặc tham gia nhóm): thấy điều khách thật sự làm thay vì điều họ nói; người quan sát có thể thiên kiến.
- Thăm dò nhanh (poll): một câu hỏi, đáp ngay, hợp với sự kiện hay kiểm tra nhanh; người tự chọn trả lời thường không đại diện.
- Theo dõi theo thời gian (cùng một nhóm người hoặc nhóm cùng đặc điểm): thấy thay đổi và tác động dài hạn; tốn thời gian, người tham gia rụng dần.
- Nghiên cứu tình huống: đào sâu một trường hợp thành công, thất bại hoặc điển hình để hiểu cơ chế và sinh giả thuyết; không khái quát từ một ca.
- Rà soát tài liệu và hồ sơ: đánh giá của khách, báo cáo nội bộ, số liệu bán hàng, tài liệu của đối thủ; rẻ, có sẵn nhưng chất lượng không đều.
- Dữ liệu lớn: giao dịch, web, mạng xã hội, cảm biến, thu tự động; mạnh về quy mô và tốc độ, yếu ở việc giải thích vì sao.
Hỏi sao cho không dẫn dắt: phỏng vấn và khảo sát
Phỏng vấn tốt bắt đầu bằng bản hướng dẫn một trang: mục tiêu, đối tượng cần gặp, vài câu hỏi mở. Chọn người đại diện cho nhóm bạn quan tâm chứ không chỉ người dễ liên lạc, hỏi những câu khuyến khích kể chuyện thay vì gợi sẵn đáp án, ghi âm khi được phép. Hỏi người ta đã làm gì lần gần nhất thường đáng tin hơn hỏi họ sẽ làm gì.
Với khảo sát, mỗi câu chỉ hỏi một việc, dùng ngôn ngữ trung tính, tránh câu dẫn dắt và câu ghép hai ý trong một. Luôn chạy thử với nhóm nhỏ để bắt câu khó hiểu và đo thời gian trả lời, kiểm tra hiển thị trên điện thoại. Quà tặng nhỏ có thể tăng tỷ lệ trả lời nhưng làm lệch kết quả nếu chỉ người thích quà mới trả lời.
Định tính hay định lượng: chọn thế nào và đọc kết quả ra sao
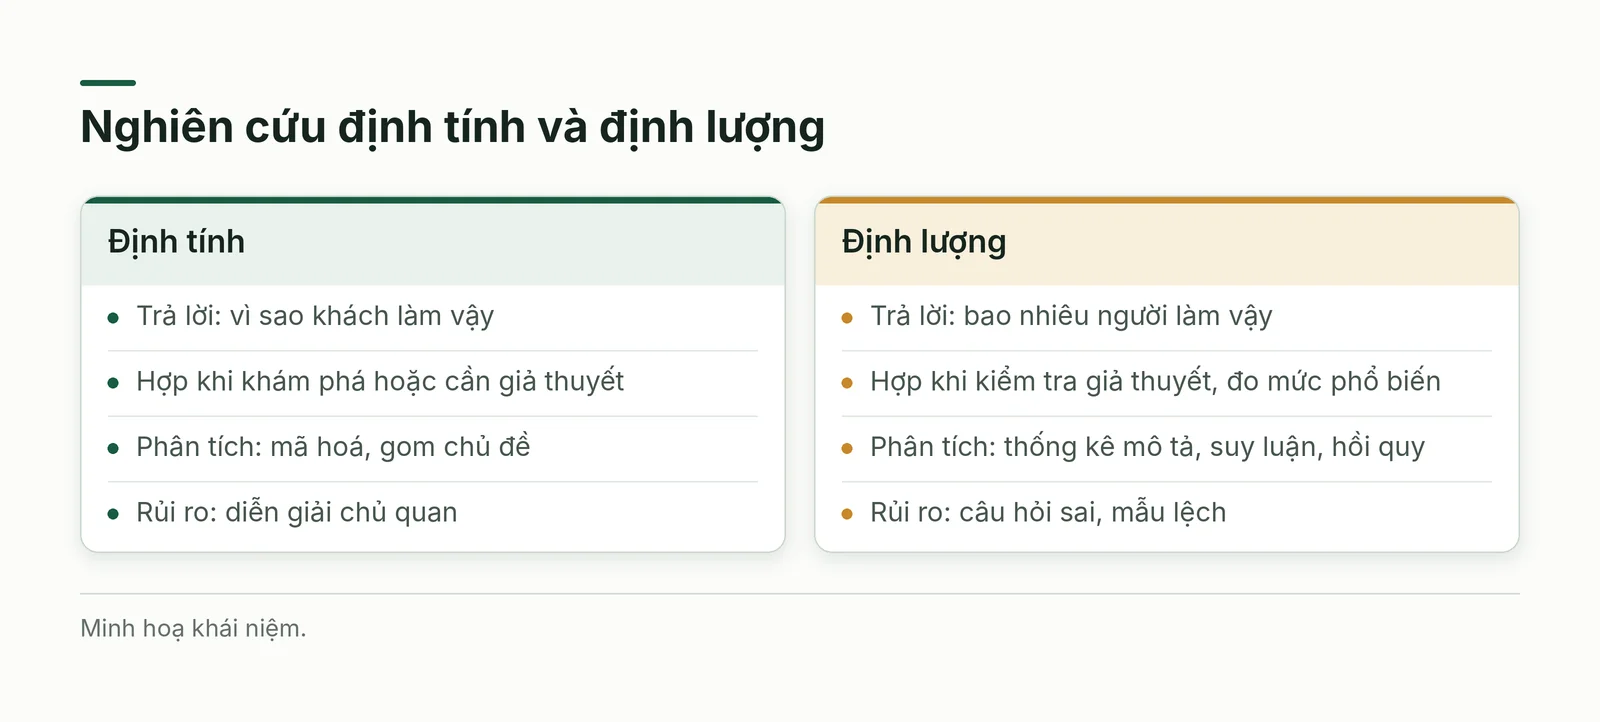
Chọn định tính khi mới khám phá một chủ đề, khi cần hiểu vì sao khách hành xử như vậy hoặc cần giả thuyết để kiểm tra sau. Chọn định lượng khi cần kiểm tra giả thuyết, đo mức phổ biến của một ý kiến hay hành vi, hoặc nói điều gì đó về cả nhóm lớn; muốn vậy mẫu phải đại diện, vì mười hai người được phỏng vấn sâu cũng không cho biết tỷ lệ của thị trường.
Dữ liệu định tính được phân tích bằng cách mã hoá và gom chủ đề lặp lại, đọc những câu chuyện khách kể hoặc xem họ dùng ngôn từ thế nào; phần mềm chuyên dụng giúp quản lý các mã. Dữ liệu định lượng bắt đầu bằng thống kê mô tả (trung bình, trung vị, độ lệch chuẩn), rồi thống kê suy luận để kiểm định giả thuyết và hồi quy để xem biến này liên hệ với biến kia ra sao; khi dữ liệu lệch, hãy đọc trung vị bên cạnh trung bình. Rủi ro của định tính là diễn giải chủ quan, của định lượng là câu hỏi sai hoặc mẫu lệch (Hình 3).
Hiểu khách và chia nhóm khách
Hiểu khách bắt đầu từ việc nghe cả điều họ không nói thẳng. Đánh giá trực tuyến, bình luận mạng xã hội và cuộc gọi chăm sóc khách hàng cho thấy nỗi bực chưa ai hỏi tới; quan sát khách trong cửa hàng hay trên ứng dụng cho thấy chỗ họ vấp mà chính họ không nhận ra. Bản đồ hành trình, từ lúc biết đến sau khi mua, giúp chọn điểm chạm cần sửa trước.
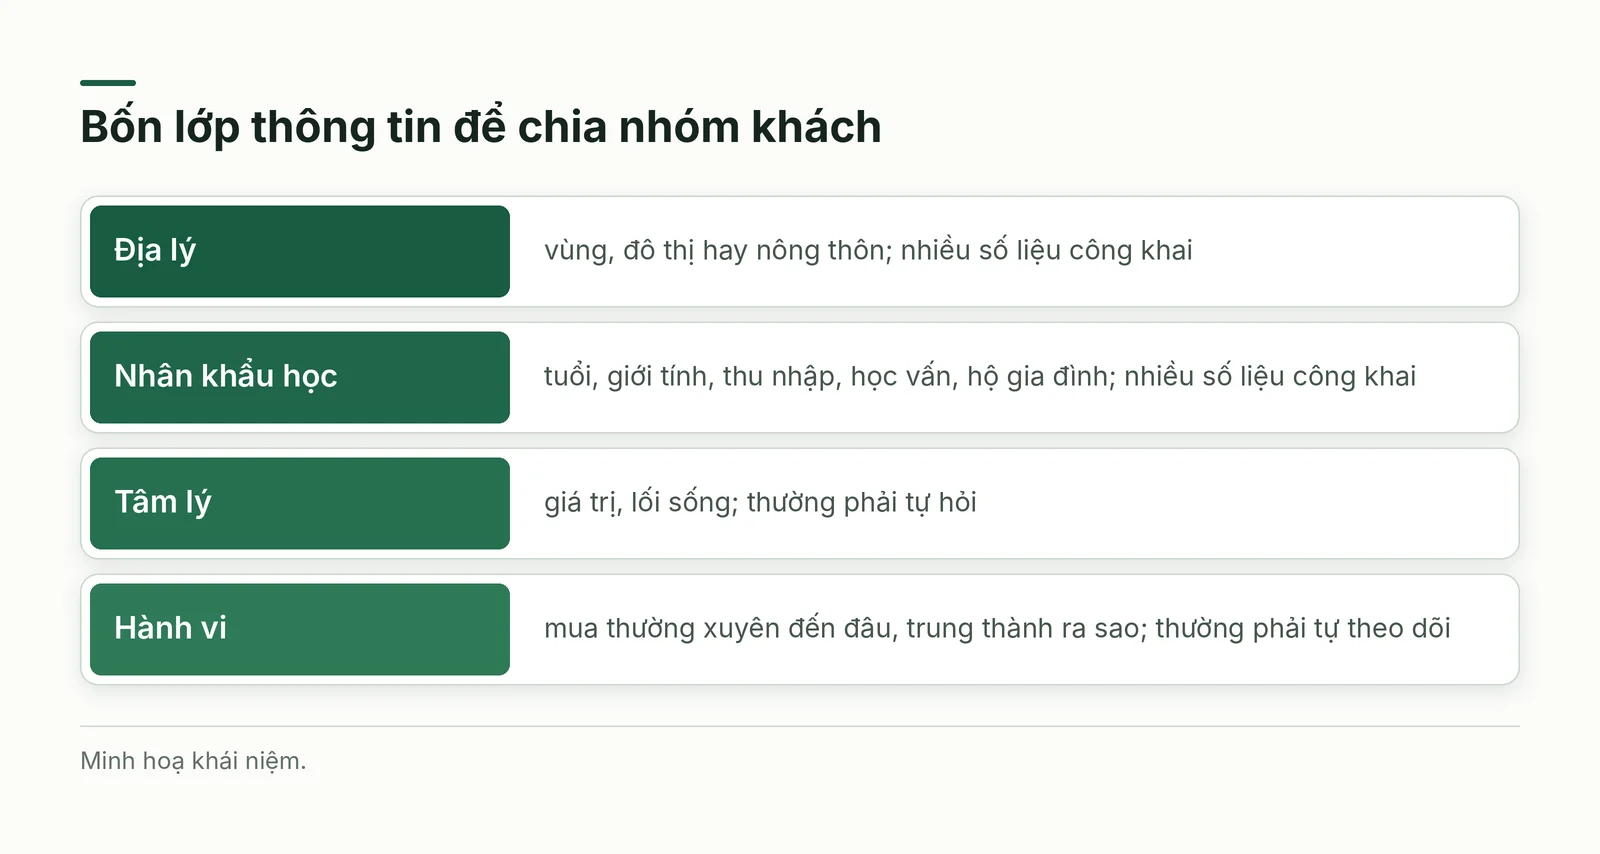
Chia khách thành nhóm thường bắt đầu bằng hai lớp có nhiều số liệu công khai: địa lý (vùng, đô thị hay nông thôn) và nhân khẩu học (tuổi, giới tính, thu nhập, học vấn, hộ gia đình). Nhưng hai người cùng tuổi, cùng mức thu nhập vẫn có thể chọn mua theo những động cơ khác hẳn nhau, nên cần thêm tâm lý (giá trị, lối sống) và hành vi (mua thường xuyên đến đâu, trung thành ra sao), hai lớp thường phải tự hỏi hoặc tự theo dõi (Hình 4).
Ví dụ giả định, minh hoạ: một trung tâm ngoại ngữ nhỏ chia học viên theo mục tiêu học (lấy chứng chỉ, giao tiếp đi làm, học thêm cho con) thay vì theo tuổi, nên mỗi nhóm có lịch học, mức giá và cách quảng bá riêng. Hãy đối chiếu từng phân khúc với doanh thu và chi phí phục vụ, rồi rà lại định kỳ.
Ba kiểu khách: người tiêu dùng, doanh nghiệp và mô hình qua trung gian
Với khách cá nhân (B2C), người mua thường là một người, quyết định nhanh hơn và chịu ảnh hưởng của cảm xúc, thói quen; mẫu lớn, khảo sát, lắng nghe mạng xã hội và thử nghiệm A/B (cho hai nhóm khách xem hai bản khác nhau rồi đối chiếu kết quả) là công cụ chính. Với khách doanh nghiệp (B2B), người mua thường là cả một nhóm gồm người dùng, người duyệt chi và người kiểm tra kỹ thuật, cân nhắc hiệu quả đầu tư và rủi ro; phỏng vấn sâu, báo cáo ngành và nghiên cứu tình huống với mẫu nhỏ nhưng chọn kỹ thường hợp hơn. Đây là xu hướng chung, không phải quy luật. Chân dung người mua cũng khác theo hai kiểu khách này (phần 2).
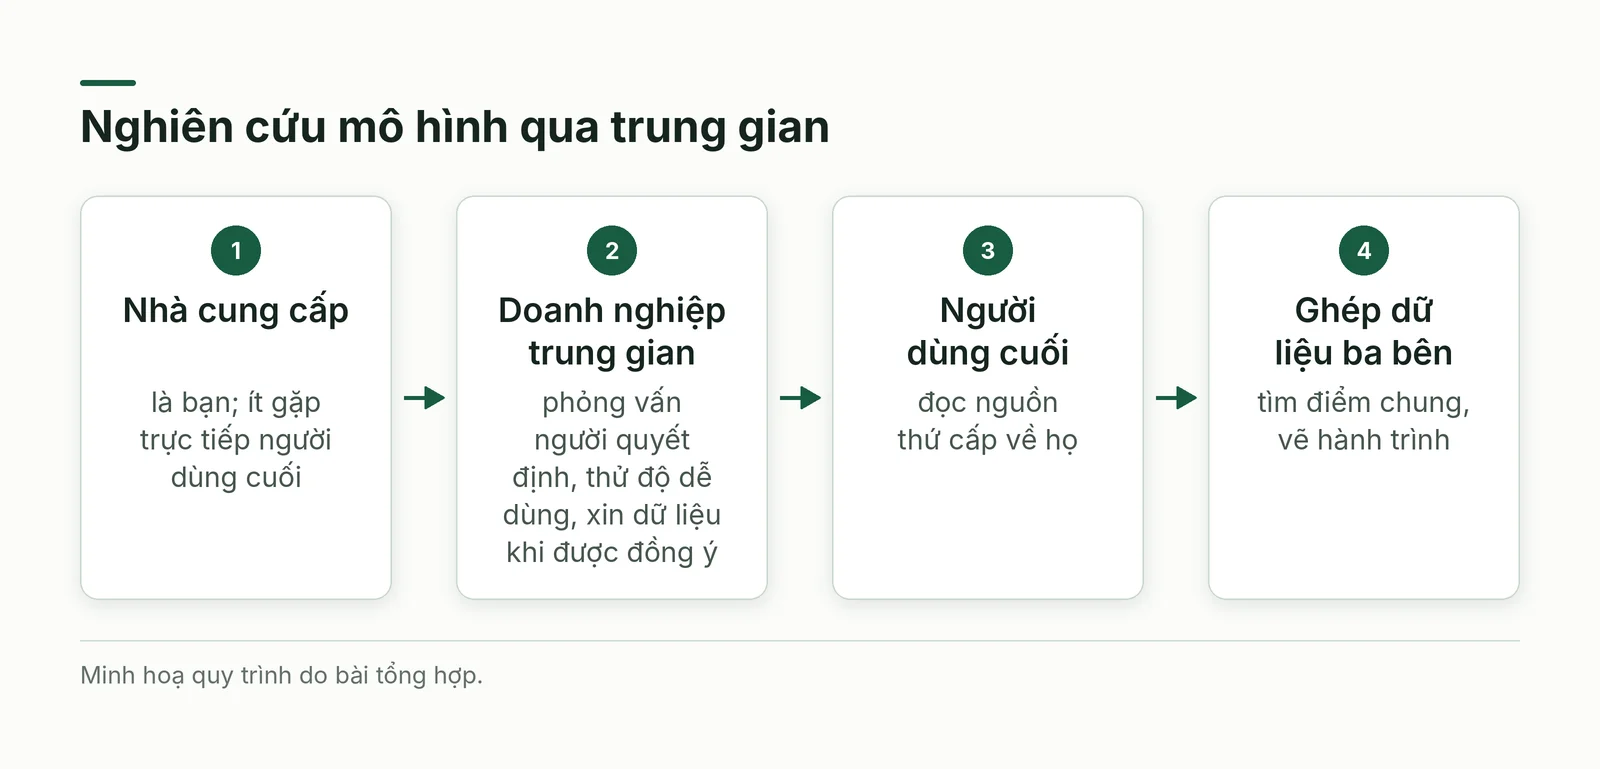
Mô hình qua trung gian (B2B2C) có ba bên: nhà cung cấp, doanh nghiệp trung gian đưa sản phẩm đến tay người dùng và người dùng cuối. Nhà cung cấp ít khi gặp trực tiếp người dùng cuối nên dễ hiểu sai nhu cầu. Hãy nghiên cứu cả ba: phỏng vấn người quyết định ở doanh nghiệp trung gian, xin dữ liệu khách của họ khi có thoả thuận và sự đồng ý hợp lệ, đọc nguồn thứ cấp về người dùng cuối, thử độ dễ dùng tại chỗ trung gian, rồi ghép dữ liệu ba bên để tìm điểm chung và vẽ hành trình (Hình 5).
Ví dụ giả định, minh hoạ: một nhà máy làm máy lọc nước gia đình bán qua các đơn vị lắp đặt. Đơn vị lắp đặt chọn mẫu máy và báo giá, còn hộ gia đình là người uống nước hằng ngày và tự mua lõi lọc thay thế; chỉ hỏi đơn vị lắp đặt thì nhà máy có thể bán được lô đầu mà vẫn không hiểu vì sao khách không mua lại lõi lọc.
Đọc ngành: định giá, xu hướng và dòng chảy
Hãy đặt doanh nghiệp vào bối cảnh ngành bằng ba lát cắt. Định giá cả ngành (tổng vốn hoá hay giá trị doanh nghiệp) cho thấy vốn đang chảy vào đâu, nhưng định giá cao có thể phản ánh kỳ vọng hơn là sức khoẻ thực. Xu hướng chịu bốn lực đẩy: công nghệ, khẩu vị người tiêu dùng, kinh tế và quy định. Dòng chảy là mạng nhà cung cấp, sản xuất, phân phối, bán lẻ và người mua, nơi một khâu nghẽn kéo chậm cả chuỗi. Doanh nghiệp nhỏ thường được lợi hơn từ hai lát cắt sau; chuỗi giá trị của riêng doanh nghiệp ở phần 2.
AI và dữ liệu lớn: nhanh hơn nhưng không tự khách quan
AI giúp nghiên cứu ở bốn việc: học máy tìm khuôn mẫu trong dữ liệu lớn; xử lý ngôn ngữ tự nhiên đọc rất nhiều bình luận để rút chủ đề và cảm xúc; phân tích dự báo ước lượng hành vi sắp tới từ dữ liệu quá khứ; và theo dõi dữ liệu thời gian thực để phản ứng sớm. Nhóm khách do máy gom chỉ hữu ích khi bạn gọi tên và kiểm chứng được nó.
Quan niệm cho rằng AI không có thiên kiến vì không có cảm xúc là sai. NIST, cơ quan tiêu chuẩn và đo lường thuộc chính phủ Mỹ, nhận định yếu tố con người, thể chế và xã hội cũng là nguồn quan trọng của thiên kiến trong AI, và thiên kiến có thể gây hại bất kể chủ ý [1]. Dữ liệu lệch hay mẫu thiếu một nhóm khách đều để lại dấu trong kết quả; hãy kiểm tra mẫu, đọc lại một số phản hồi gốc và dùng định tính để giải thích điều con số cho thấy.
Dữ liệu lớn hay được nhận ra qua ba chữ V trong tiếng Anh: lượng rất lớn, sinh ra rất nhanh và có nhiều dạng khác nhau; nó được thu tự động từ máy tính tiền, công cụ phân tích web, mạng xã hội, cảm biến. Phân tích thời gian thực theo dõi điều đang xảy ra, dữ liệu lớn nhìn cả lịch sử, còn AI học từ cả hai để dự báo. Chúng cho biết khách làm gì ở quy mô rộng, hiếm khi cho biết vì sao; phần 2 bàn tiếp.
Tình huống Việt Nam: số liệu thống kê, dữ liệu hộ gia đình và dữ liệu cá nhân
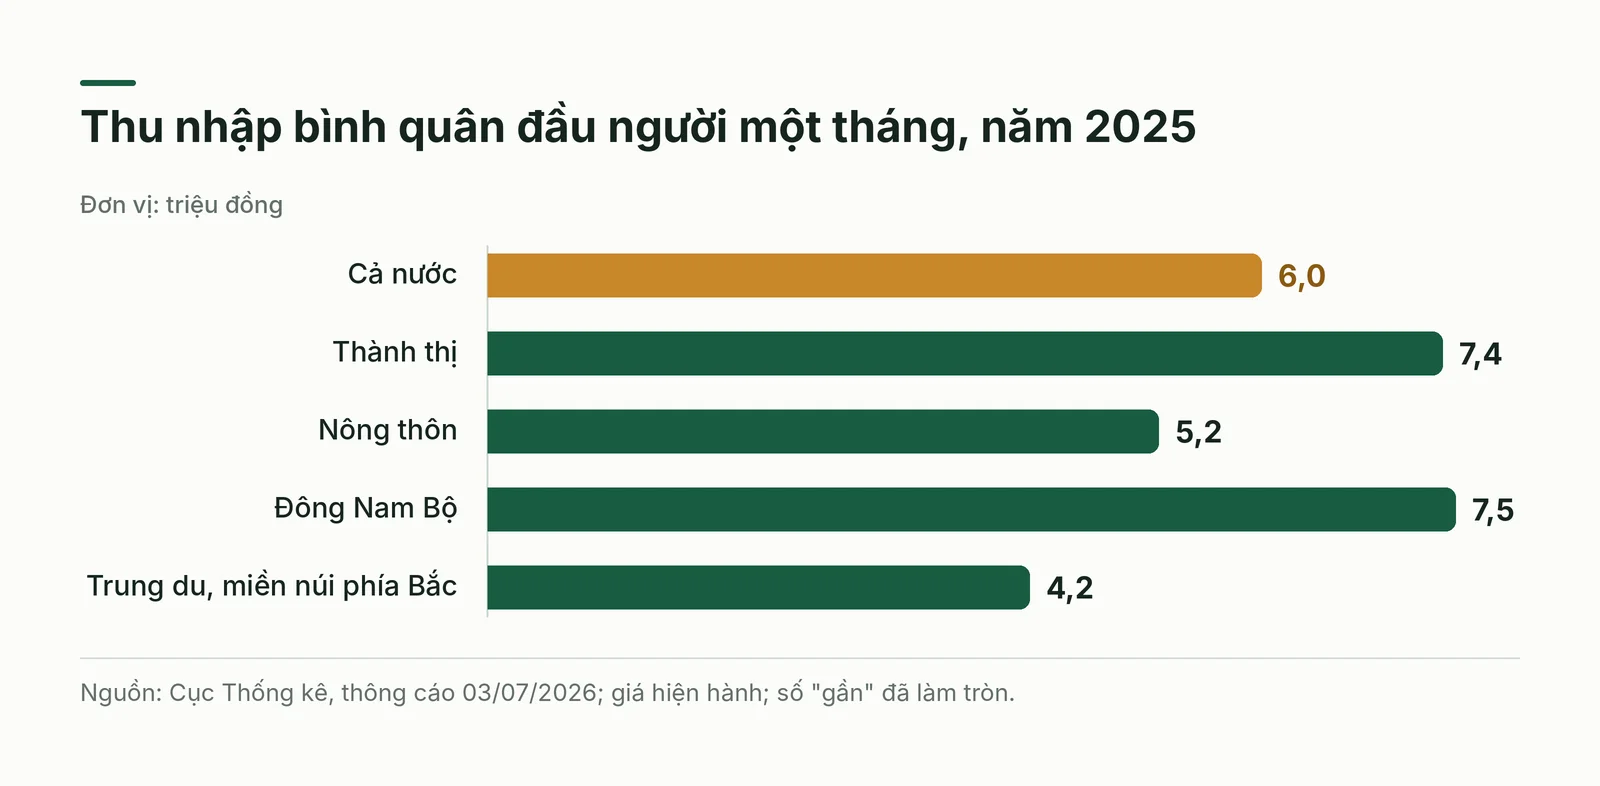
Nguồn thứ cấp đáng đọc đầu tiên ở Việt Nam là điều tra của cơ quan thống kê. Khảo sát mức sống dân cư năm 2025, Cục Thống kê công bố ngày 03/07/2026, có mẫu 46.995 hộ đại diện toàn quốc [2]. Thu nhập bình quân đầu người một tháng theo giá hiện hành đạt 6,0 triệu đồng; thành thị gần 7,4 triệu, nông thôn gần 5,2 triệu [2]. Đông Nam Bộ cao nhất, gần 7,5 triệu, còn Trung du và miền núi phía Bắc thấp nhất, gần 4,2 triệu; nhóm 20% thu nhập cao nhất gấp 5,6 lần nhóm thấp nhất [2] (Hình 6).
Không có một khách Việt Nam trung bình để định một mức giá hay thông điệp chung; hãy đối chiếu địa bàn bán với từng vùng và nhóm thu nhập. Đây là thu nhập, không phải chi tiêu hay mức sẵn lòng trả, nên vẫn cần hỏi chính khách của mình.
Theo mô tả đăng trên Brands Vietnam, báo cáo Brand Footprint 2023 của Kantar Worldpanel Việt Nam dùng dữ liệu hành vi mua sắm của hộ gia đình, gồm hộ nông thôn Việt Nam và hộ thành thị ở bốn thành phố lớn, cho năm nhóm hàng tiêu dùng; chỉ số Consumer Reach Points của báo cáo gộp hai con số: số hộ có mua một thương hiệu và số lần họ mua [3]. Dữ liệu này cho biết bao nhiêu hộ mua và mua bao lâu một lần, không cho biết vì sao; trang không nêu số hộ trong mẫu, và chỉ số là của riêng bên bán dịch vụ [3].
Thu thập dữ liệu khách còn vướng ràng buộc pháp lý. Văn bản cần nắm trước hết: Luật Bảo vệ dữ liệu cá nhân, hay Luật số 91/2025/QH15, được thông qua ngày 26/6/2025 và bắt đầu có hiệu lực từ 01/01/2026 [4]. Điều 3 khoản 2 đòi hỏi dữ liệu chỉ được thu thập, xử lý đúng phạm vi và mục đích cụ thể, rõ ràng. Điều 9 đặt điều kiện cho sự đồng ý: tự nguyện, biết rõ thông tin, tách riêng từng mục đích; im lặng hay không phản hồi không được tính là đồng ý [4].
Cách đọc của người viết, không thay cho tư vấn pháp lý: ghi mục đích ngay trên phiếu đồng ý khi phỏng vấn; muốn dùng lại bản ghi âm vào việc khác thì xin đồng ý riêng; chỉ hỏi dữ liệu thật sự cần cho quyết định đang cân nhắc.
Sai lầm thường gặp và giới hạn của bài
Bài này là phần nền, chưa đi vào nhóm thảo luận, chân dung người mua và khung phân tích. Hai nguồn số liệu Việt Nam chỉ minh hoạ cách dùng dữ liệu thứ cấp và dữ liệu hành vi; thu nhập là số bình quân và bài không kiểm tra được cách chọn mẫu chi tiết. Các ví dụ giả định chỉ để hình dung. Năm sai lầm sau hay gặp nhất khi doanh nghiệp tự làm nghiên cứu.
- Chọn phương pháp trước câu hỏi, rồi thu về dữ liệu không gắn với quyết định nào.
- Hỏi bằng câu dẫn dắt, hoặc chỉ hỏi người dễ liên lạc rồi coi kết quả là của cả thị trường.
- Dùng mẫu nhỏ hoặc mẫu tự chọn, như thăm dò trên mạng xã hội, để suy ra tỷ lệ toàn thị trường.
- Tin con số trung bình mà không nhìn phân bố, hoặc nhầm hai thứ cùng tăng là cái này gây ra cái kia.
- Giao AI tóm tắt rồi không đọc lại phản hồi gốc, hoặc thu dữ liệu cá nhân vượt mức cần mà không xin đồng ý đúng cách.
Kế hoạch thử nghiệm trong hai đến bốn tuần
Giả sử một tiệm sửa xe máy muốn quyết định có thêm dịch vụ đón và trả xe tại nhà hay không (ví dụ giả định, minh hoạ). Kế hoạch dùng ngân sách nhỏ và ghép cả định tính lẫn định lượng.
- Bước 1 (tuần 1): Viết quyết định và tiêu chí chọn trong một câu, chẳng hạn cần bao nhiêu khách quan tâm thì đáng làm; đọc số liệu thứ cấp về địa bàn.
- Bước 2 (tuần 1 đến 2): Gặp khoảng 8 đến 10 khách cũ và mới, hỏi theo cùng một bản hướng dẫn dài một trang, kèm phiếu đồng ý nêu rõ mục đích; ghi lại những chủ đề lặp lại.
- Bước 3 (tuần 2 đến 3): Từ các chủ đề, viết khảo sát dưới mười câu, chạy thử với năm người rồi gửi qua nhiều kênh để mẫu bớt lệch.
- Bước 4 (tuần 3 đến 4): Chạy thử thật ở quy mô nhỏ, so nhóm có và không có dịch vụ nếu được, đo bằng chỉ số đã định từ đầu.
- Bước 5 (cuối kế hoạch): Họp một giờ đối chiếu ba nguồn. Nếu cùng chỉ một hướng thì tăng quy mô thử; nếu lệch nhau, quay lại chỗ lệch nhất thay vì thu thêm dữ liệu cùng loại.
Kết luận
Nghiên cứu thị trường tạo lợi thế khi nó biến mỗi quyết định thành một giả thuyết kiểm tra được: biết mình cần trả lời câu hỏi nào, đọc cái đã có trước, chọn cách thu nhỏ nhất đủ dùng và tôn trọng người cung cấp dữ liệu. Phần 2 đi tiếp từ nền này: phần còn lại của dữ liệu lớn (thu từ web và dấu vết hành vi, ghép nối, chất lượng, quyền riêng tư), nhóm thảo luận, chân dung người mua và mười khung phân tích như SWOT, VRIO, PESTLE, Năm lực lượng, BCG và Ansoff.
Nguồn và phương pháp
Bài này không phải bản dịch hay tóm tắt theo từng chương. Nội dung được viết lại và sắp xếp lại quanh các quyết định của người làm kinh doanh, với sự hỗ trợ của trí tuệ nhân tạo (AI), rồi đối chiếu với các nguồn bên dưới. Tài liệu nguồn là sách điện tử Competitive Advantage Explained của Business Explained (tệp Competitive-Advantage-EXPLAINED.pdf), trang 1 đến 95; bài bỏ qua các ví dụ minh hoạ riêng của sách, các lời mời đọc thêm và những khẳng định chưa kiểm chứng được. Bạn đọc nên tìm tài liệu gốc để đọc đầy đủ.
Nguồn web, truy cập ngày 20/10/2026: tài liệu NIST SP 1270 về thiên kiến trong AI; thông cáo báo chí Khảo sát mức sống dân cư năm 2025 của Cục Thống kê; mô tả báo cáo Brand Footprint 2023 của Kantar Worldpanel Việt Nam đăng trên Brands Vietnam; văn bản Luật Bảo vệ dữ liệu cá nhân trên thuvienphapluat.vn. Điều chưa kiểm chứng: trang Brands Vietnam không ghi ngày đăng và không nêu cỡ mẫu; văn bản luật được đọc qua trang thứ cấp, chưa đối chiếu các sửa đổi về sau và chưa đọc văn bản hướng dẫn; các định nghĩa chung về nghiên cứu thị trường lấy từ sách nguồn và kiến thức phổ thông. Sách nguồn có vài chỗ đã được chỉnh theo nguồn ngoài, như cách nói AI không có thiên kiến.