Paperless-ngx: số hóa và lưu trữ tài liệu có OCR trên máy chủ riêng
Đăng ngày 12/10/2026
Mục lục bài nghiên cứu
Tóm lược: kho tài liệu có OCR vận hành trên máy chủ của chính đơn vị
Paperless-ngx là hệ thống quản lý tài liệu mã nguồn mở, biến giấy tờ được scan và tệp số thành một kho lưu trữ trực tuyến tìm kiếm được. Dự án là người kế nhiệm chính thức của Paperless và Paperless-ng, do một nhóm cùng chia trách nhiệm phát triển và hỗ trợ thay vì một cá nhân. [1][4]
Nên cân nhắc khi văn phòng nhận chứng từ đều đặn từ máy scan, email và tải lên thủ công, cần OCR (nhận dạng ký tự quang học, biến ảnh chữ thành văn bản tìm được), gắn nhãn, phân quyền và tự động phân loại. Các khả năng dùng mô hình ngôn ngữ lớn đều là tùy chọn, tắt theo mặc định. [4][5]
Không nên chọn khi chỉ có hạ tầng không tin cậy: README cảnh báo dữ liệu được lưu dạng rõ, không mã hóa. Khuyến nghị của bài là thí điểm với một nhóm hồ sơ có ranh giới rõ, đo OCR tiếng Việt và kiểm thử phân quyền trước khi đưa giấy tờ tùy thân hay hợp đồng vào kho. [1]
Giấy tờ nằm rải rác giữa máy scan, hộp thư, ổ chia sẻ và tủ hồ sơ
Ở nhiều doanh nghiệp vừa và nhỏ, một bộ hồ sơ nằm ở bốn nơi: tủ giấy, máy kế toán, hộp thư chung và nhóm chat. Ổ chia sẻ gom được tệp nhưng không đọc được chữ trong bản scan và không ghi được ngữ cảnh như đối tác, loại giấy tờ hay ngày phát hành.
Paperless-ngx dùng một mô hình dữ liệu riêng cho tài liệu: correspondent (bên gửi hoặc nhận), document type (loại như hóa đơn, hợp đồng), tag (nhãn, một tài liệu mang được nhiều nhãn), storage path (vị trí lưu tệp), ngày tạo, số lưu trữ ASN để tìm lại bản giấy và trường tùy biến. Không dùng thư mục là lựa chọn có chủ ý, vì nhãn linh hoạt hơn. [5]
Bài toán thứ hai là vừa giữ nguyên bản gốc vừa có bản dễ đọc, dễ tìm. Paperless lưu tệp gốc không chỉnh sửa, tạo bản PDF/A (biến thể PDF dành cho lưu trữ dài hạn) có lớp chữ cho tài liệu scan, và đưa nội dung vào chỉ mục tìm kiếm. Việc tách bản gốc khỏi bản lưu trữ là khác biệt cơ bản so với một thư mục chia sẻ. [4][5][7]
Bốn mảnh ghép: webserver, consumer, Celery và message broker
Tài liệu sử dụng mô tả bốn thành phần: webserver phục vụ trang quản trị, API và giao diện web; consumer theo dõi thư mục đầu vào; task processor dựa trên Celery (thư viện hàng đợi tác vụ phân tán) làm phần việc nặng; và message broker như Valkey hoặc Redis chuyển tác vụ giữa các tiến trình, vốn có thể chạy trên những máy khác nhau. Dữ liệu lưu trong PostgreSQL, MariaDB hoặc SQLite. [5]
Consumer chỉ báo cho task processor rằng có tệp mới. Task processor mới là nơi tiêu thụ tài liệu từ thư mục lẫn giao diện web, kiểm tra email định kỳ, duy trì chỉ mục tìm kiếm và thuật toán khớp tự động, nhờ vậy xử lý song song nhiều tài liệu trên máy nhiều nhân; bộ lập lịch đi kèm chạy các tác vụ định kỳ. [5]
Xung quanh lõi là các thành phần chuyên dụng: OCRmyPDF với Tesseract cho OCR; Apache Tika và Gotenberg cho tệp Office và email .eml; chỉ mục Tantivy cho tìm kiếm toàn văn với stemmer (bộ rút từ về gốc) theo ngôn ngữ; backend tương thích OpenAI hoặc Ollama cùng chỉ mục vector khi bật AI. Cài trực tiếp chỉ hỗ trợ Linux với Python 3.11 đến 3.14 và các dịch vụ systemd riêng. [6][7][8]
Một chứng từ đi qua hệ thống: từ thư mục tiêu thụ tới chỉ mục
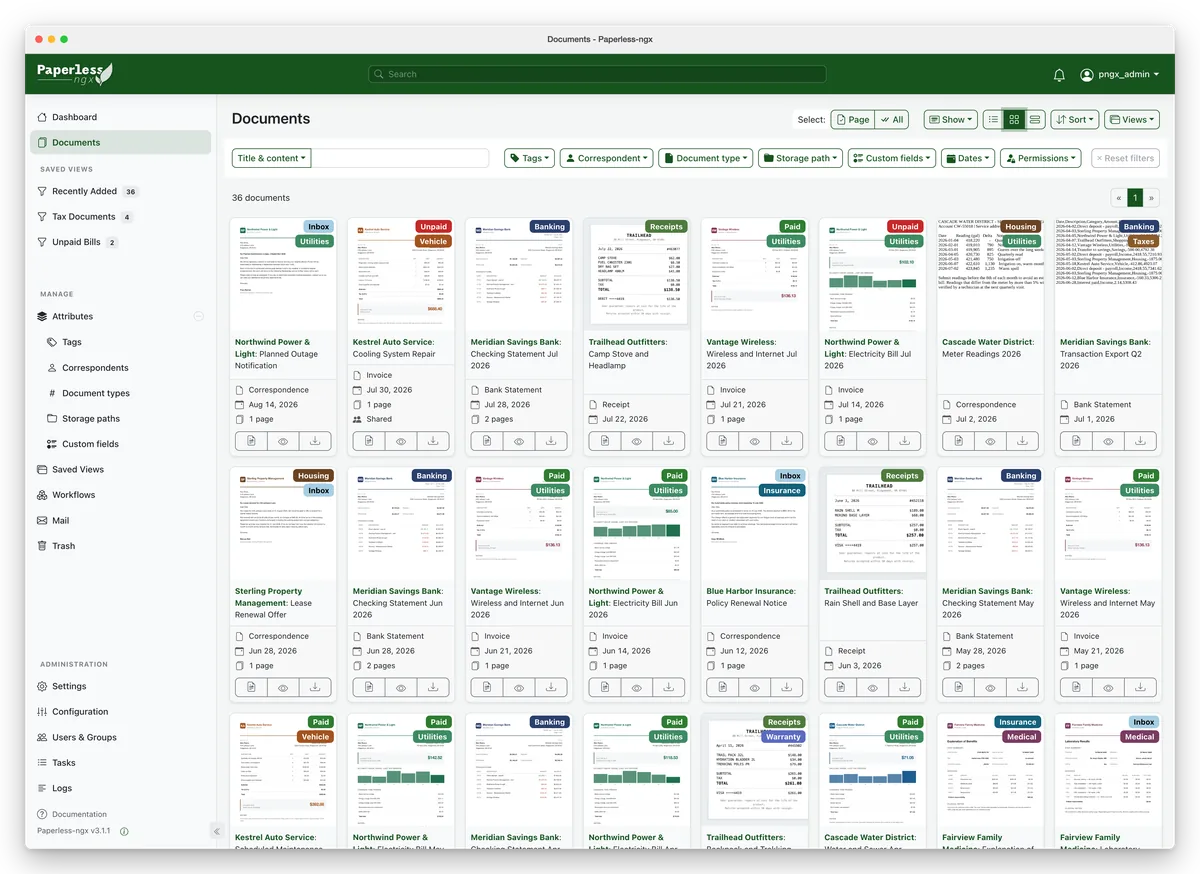
Tài liệu vào qua bốn cửa: thư mục tiêu thụ (consumption directory) nhận tệp từ máy scan qua FTP hay chia sẻ Samba, nút tải lên hoặc kéo thả trên web, quy tắc lấy thư từ tài khoản email, và REST API. Tệp trong thư mục tiêu thụ sau khi xử lý được chuyển vào cấu trúc lưu trữ của Paperless và không còn ở chỗ cũ. [5]
Khi tiêu thụ, hệ thống chạy OCR nếu tài liệu chưa có lớp chữ, tạo bản PDF/A, rồi tự khớp nhãn, correspondent và loại tài liệu trước khi lưu vào cơ sở dữ liệu; bản gốc không bị ghi đè, trừ vài thao tác được cảnh báo rõ. Workflow (luồng tự động hóa) móc vào bốn thời điểm: bắt đầu tiêu thụ, sau khi thêm, khi cập nhật và theo lịch kiểm tra hằng giờ. [5]
Trang giới thiệu khẳng định dữ liệu nằm trên máy chủ của người dùng và chỉ được truyền đi khi người dùng chủ động chọn: link chia sẻ công khai không cần đăng nhập, email, webhook, OCR từ xa qua Azure hay lời gọi tới nhà cung cấp AI. Mỗi đường ra là một quyết định chính sách cần ghi vào sổ đăng ký hoạt động xử lý dữ liệu. [4][5][7]
Danh mục tính năng đối chiếu với tài liệu chính thức
Tổ chức và tìm kiếm: nhãn lồng nhau tối đa năm cấp, correspondent, loại tài liệu, đường dẫn lưu trữ; trường tùy biến kiểu văn bản, ngày, số, tiền tệ theo mã ISO 4217, liên kết tài liệu, danh sách chọn; tìm kiếm toàn văn có gợi ý, xếp hạng theo độ liên quan, tô sáng, tìm tài liệu tương tự và cú pháp nâng cao theo trường, khoảng ngày. [4][5]
Xử lý tài liệu: OCR bằng Tesseract cho hơn 100 ngôn ngữ, OCR từ xa qua Azure AI khi chủ động bật; bản PDF/A cạnh bản gốc; bộ phân loại học máy không dùng LLM để gợi ý metadata; nhiều phiên bản tệp dưới một bản ghi; mã vạch để tách tài liệu hoặc gán ASN; chỉnh sửa PDF cơ bản. Cộng tác: phân quyền toàn cục và theo đối tượng, xác thực hai lớp, lịch sử thay đổi, thùng rác giữ 30 ngày mặc định, quy tắc email hỗ trợ OAuth2 cho Gmail và Outlook. [4][5][7]
AI tùy chọn: đặt PAPERLESS_AI_ENABLED (mặc định false) và chọn backend thì hệ thống gợi ý tiêu đề, ngày, nhãn, correspondent, loại tài liệu bằng LLM, cho trò chuyện với một hay nhiều tài liệu, và cập nhật chỉ mục LLM theo lịch hằng ngày. Đây là tính năng hiện hành theo tài liệu; chất lượng với tiếng Việt tùy vào mô hình được chọn. [5][7][8]
Văn phòng nào hưởng lợi, văn phòng nào chưa cần
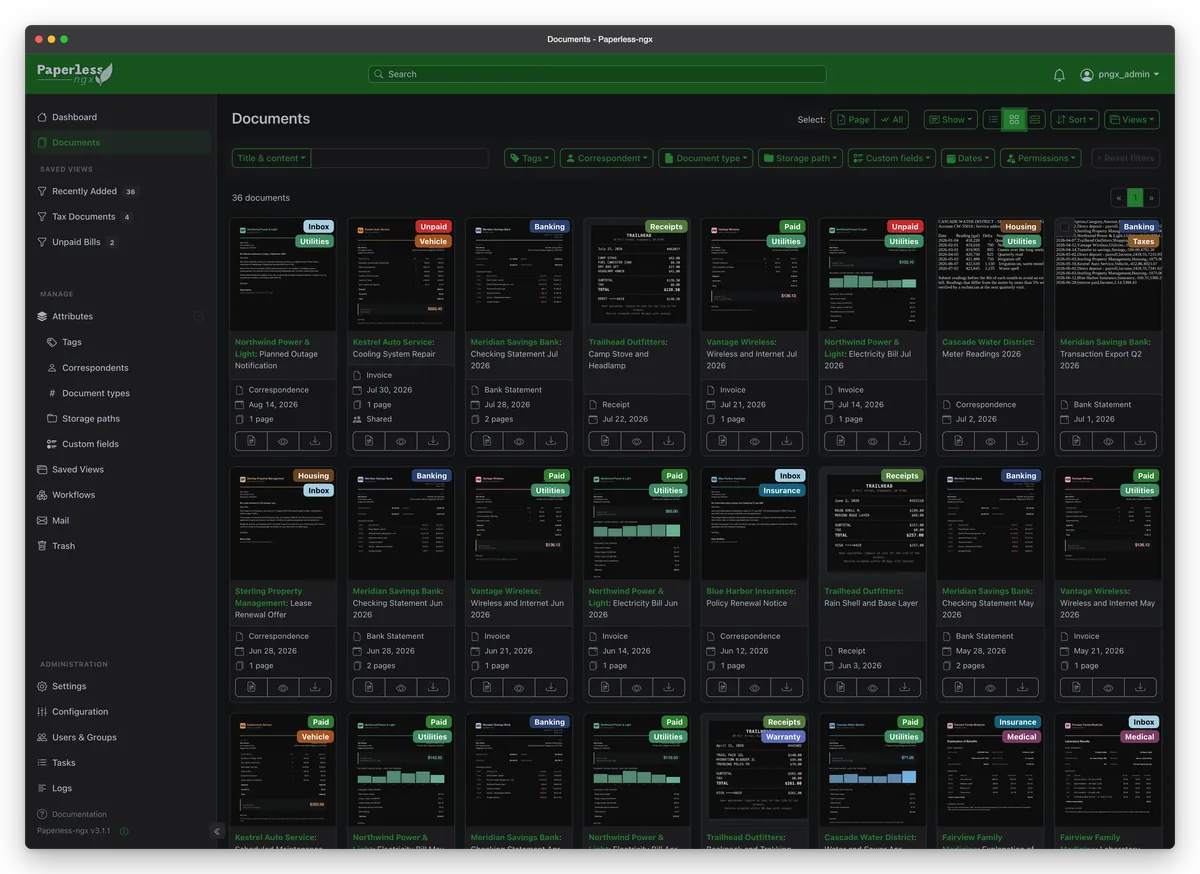
Người dùng điển hình là văn phòng có chứng từ đến đều: kế toán dịch vụ, công ty lữ hành, phòng khám, văn phòng luật, hộ kinh doanh nhiều hóa đơn đầu vào. Điều kiện là có người giữ quy ước nhãn, loại tài liệu, và đặt được máy chủ trong văn phòng hoặc trên hạ tầng do đơn vị kiểm soát, đúng khuyến nghị an toàn của README. [1]
Bộ phận CNTT nhỏ có tập lệnh cài đặt và mẫu Docker Compose; nhóm vững Linux có thể cài trực tiếp để kiểm soát từng dịch vụ. Hệ thống chạy được trên Raspberry Pi với vài điều chỉnh như dùng SQLite, giảm số worker hay chỉ OCR trang đầu, hợp với văn phòng rất nhỏ. [6]
Chưa cần Paperless là nơi tài liệu chủ yếu là bản thảo đang cộng tác, cần phê duyệt và ký số tích hợp, hoặc lượng giấy tờ quá ít để bù công thiết lập. Với cá nhân và gia đình, hệ thống vẫn hữu ích, vì tài liệu sử dụng mô tả nó trước hết như ứng dụng quản lý giấy tờ cá nhân. [5]
Tình huống giả định: hồ sơ đoàn khách của một công ty lữ hành
Giả sử một công ty du lịch lữ hành khoảng 25 nhân viên tổ chức tour nội địa và đưa khách ra nước ngoài. Mỗi đoàn sinh ra hợp đồng với khách, bản sao hộ chiếu và thị thực, xác nhận đặt phòng, vé máy bay, hóa đơn nhà xe, nhà hàng, hợp đồng hướng dẫn viên và biên bản thanh lý; phần lớn đến qua email, phần còn lại là giấy cần scan. Toàn bộ tình huống là giả định để minh họa cách áp dụng.
Cấu hình đề xuất: một máy chủ nhỏ tại văn phòng chạy Paperless-ngx bằng Docker Compose với PostgreSQL; máy scan đẩy tệp vào thư mục tiêu thụ qua chia sẻ mạng; hộp thư đặt dịch vụ được nối bằng quy tắc email chỉ lấy thư từ nhà cung cấp quen và đánh dấu đã đọc sau khi xử lý. Mỗi đoàn có trường tùy biến Mã tour, ngày khởi hành và giá trị hợp đồng kiểu tiền tệ; lưu ý kiểu này yêu cầu đúng hai chữ số thập phân. [5][6]
Workflow giữ dữ liệu nhạy cảm đúng chỗ: hộ chiếu, thị thực được gán chủ sở hữu là bộ phận điều hành; hóa đơn cấp quyền cho kế toán. Cần kiểm thử kỹ, vì tài liệu vào qua thư mục tiêu thụ mặc định không có chủ sở hữu, mà đối tượng không có chủ thì mọi người dùng đều thấy. Hợp đồng ký tay được dán mã vạch ASN trước khi scan; giấy tờ tùy thân không đi qua AI hay OCR từ xa, và thử nghiệm LLM chỉ dùng hóa đơn nhà cung cấp sau khi đối chiếu quy định bảo vệ dữ liệu cá nhân hiện hành. [5][7]
OCR và tìm kiếm tiếng Việt: những thiết lập phải tự kiểm chứng
Mặc định Paperless OCR bằng tiếng Anh, và image Docker chỉ cài sẵn gói ngôn ngữ Anh, Đức, Ý, Tây Ban Nha, Pháp. Muốn đọc tiếng Việt cần thêm mã ISO 639-2 của tiếng Việt (vie) qua PAPERLESS_OCR_LANGUAGES và đặt PAPERLESS_OCR_LANGUAGE, ví dụ vie+eng cho chứng từ song ngữ; nhiều ngôn ngữ làm Tesseract tốn CPU hơn đáng kể, và tùy chọn cài thêm ngôn ngữ không dùng được với container rootless. [6][7]
Tìm kiếm dùng stemmer của Tantivy theo PAPERLESS_SEARCH_LANGUAGE, mặc định suy ra từ ngôn ngữ OCR; nếu ngôn ngữ đó không có stemmer tương ứng thì stemming bị tắt. Tài liệu mô tả tìm kiếm không phân biệt dấu bằng ví dụ chữ Latin như résumé, nên với tiếng Việt cần thử: gõ không dấu có ra văn bản có dấu không, cụm nhiều âm tiết trong ngoặc kép có khớp đúng không, tìm kiếm mờ có gây nhiễu với âm tiết ngắn không. [5][7]
Ngày tháng là điểm dễ sai thứ ba. Thứ tự mặc định DMY hợp cách ghi ở Việt Nam; ngôn ngữ phân tích ngày dùng mã của thư viện dateparser, cần kiểm tra mã tiếng Việt có được hỗ trợ, và tài liệu vẫn khuyên rà lại ngày vì OCR kém hoặc nhiều ngày trong một văn bản dễ gây sai. Chất lượng tiếng Việt vì vậy là giả thuyết cần đo, chưa phải đặc tính đã được xác nhận. [5][7]
Docker Compose, cơ sở dữ liệu và lịch bảo trì
Có ba đường cài: tập lệnh tương tác, mẫu Docker Compose, và cài trực tiếp dành cho người dùng nâng cao. Tài liệu khuyến nghị PostgreSQL cho cài mới; cấu hình nằm trong docker-compose.env, nhận Docker secrets qua hậu tố _FILE; thư mục tiêu thụ đặt trên NFS không có inotify thì phải bật chế độ quét định kỳ. [6]
Lệnh document_exporter xuất tài liệu, thumbnail, metadata và nội dung cơ sở dữ liệu, hỗ trợ cập nhật tăng dần, nén zip và mã hóa một số trường bằng passphrase; bản xuất không chứa API token. Điểm then chốt: bản xuất của phiên bản này không nhập được vào phiên bản khác, nên phương án khôi phục phải gắn với phiên bản cụ thể. [8]
Nâng cấp theo trình tự dừng tiêu thụ, sao lưu, kéo image mới rồi khởi động để chạy migration; image có thể ghim theo dòng phát hành. Bản lên v3 có thay đổi phá vỡ cần đọc hướng dẫn di trú, và từ bản 2.18 PostgreSQL tối thiểu là 14. Bảo trì định kỳ gồm sanity checker, dựng lại chỉ mục và phát hiện tài liệu gần trùng. [6][8]
Không mã hóa khi lưu: hệ quả cho hộ chiếu, hợp đồng và hóa đơn
README cảnh báo Paperless-ngx không bao giờ nên chạy trên máy chủ không tin cậy vì thông tin lưu dạng rõ, không mã hóa, và dự án không bảo đảm về bảo mật. Doanh nghiệp vì thế cần mã hóa ở tầng đĩa hoặc hạ tầng, kiểm soát chặt quyền vào máy chủ và tách mạng cho các dịch vụ phụ trợ. [1]
PAPERLESS_SECRET_KEY là bắt buộc, thiếu thì hệ thống từ chối khởi động. Broker phải được bảo vệ, vì SECURITY.md coi việc giải tuần tự hóa pickle dữ liệu từ broker là hành vi với thành phần tin cậy. Quyền AppConfig là quyền cấp quản trị, do một số thiết lập như tham số OCR được chuyển thẳng cho công cụ xử lý. [3][5][6][7]
Webhook mặc định cho gọi địa chỉ nội bộ và mọi cổng; kết nối email và endpoint AI cũng mặc định chấp nhận máy nội bộ, nên cần siết lại. Workflow không có chủ sở hữu nhưng đổi được quyền của tài liệu, nên chỉ giao cho quản trị viên. Link chia sẻ không cần đăng nhập nên phải đặt hạn dùng; lỗ hổng được báo qua Security Advisory của GitHub. [3][5][7]
GPLv3: tự do sửa đổi đi kèm nghĩa vụ khi phân phối
Tệp LICENSE ở gốc kho tại commit khảo sát là toàn văn GNU General Public License phiên bản 3, một giấy phép copyleft: người nhận được chạy, nghiên cứu, sửa và phân phối lại, nhưng khi chuyển giao bản sao, kể cả bản đã sửa, cho người khác thì phải kèm hoặc cung cấp mã nguồn tương ứng theo cùng giấy phép. Phân tích dưới đây không thay thế tư vấn pháp lý. [2]
Nếu chỉ cài và dùng nội bộ, GPLv3 cho phép tạo, chạy và lan truyền những bản không chuyển giao cho ai mà không kèm điều kiện. Nghĩa vụ cung cấp mã nguồn phát sinh khi một đơn vị tích hợp sửa Paperless-ngx rồi giao cho khách dưới dạng thiết bị hay image cài sẵn. GPLv3 không có điều khoản về người dùng qua mạng như AGPL; điều 13 chỉ nói về việc kết hợp với tác phẩm theo AGPL. [2]
Giấy phép bao trùm mã của kho tại commit này, không bao trùm Tika, Gotenberg, broker, cơ sở dữ liệu, Tesseract cùng dữ liệu ngôn ngữ, mô hình AI, dịch vụ Azure hay ứng dụng cộng đồng. Năm tài liệu docs cùng README không nói tới bản thương mại hay dịch vụ đám mây chính thức nào; bản demo do nhà tài trợ hạ tầng hỗ trợ, còn nhà cung cấp hosting trên wiki là bên thứ ba cần kiểm tra kỹ. [1][4][6][7]
Ước lượng nguồn lực: máy chủ, lưu trữ, con người và tùy chọn AI
Phần mềm không thu phí bản quyền, nhưng chi phí sở hữu gồm phần cứng hoặc máy ảo, lưu trữ và sao lưu, thời gian nhân sự, và chi phí biến đổi nếu bật OCR từ xa hay AI qua API; bài không đưa đơn giá. OCR tốn CPU, và tài liệu cảnh báo tích số worker với số luồng mỗi worker không nên vượt số nhân CPU. [7]
Dung lượng phụ thuộc việc giữ cả bản gốc lẫn PDF/A; tắt tạo bản lưu trữ thì tiết kiệm đĩa nhưng trình xem web hiển thị trực tiếp tệp gốc. Giả định nhân sự: một người kỹ thuật dành vài ngày dựng hệ thống rồi vài giờ mỗi tháng bảo trì; một người nghiệp vụ thiết kế nhãn và trường tùy biến; số hóa tồn kho giấy cũ nên tách thành dự án riêng. [6][7]
Bật AI qua API trả phí thì mỗi tài liệu khớp hành động Apply AI Suggestions tạo một truy vấn; tài liệu cảnh báo về chi phí, quyền riêng tư và nguy cơ chiếm hàng đợi khi workflow khớp số lượng lớn. Dùng Ollama chạy cục bộ chuyển khoản này sang phần cứng suy luận đặt tại chỗ. [5][7]
Các lựa chọn khác: ổ chia sẻ, DMS thương mại, nền tảng ECM
Ổ chia sẻ hoặc lưu trữ đám mây theo quy ước thư mục thì dễ học, nhưng thiếu OCR, metadata có cấu trúc và phân quyền đến từng tài liệu. Paperless-ngx bổ sung đúng các lớp đó, đổi lại phải vận hành máy chủ. [4][5]
Phần mềm quản lý tài liệu thương mại hoặc SaaS có hỗ trợ và hạ tầng sẵn, nhưng dữ liệu nằm ở nhà cung cấp và chi phí thường tính theo người dùng. Các hệ mã nguồn mở khác như Mayan EDMS, Teedy hay nền tảng nội dung doanh nghiệp Alfresco Community đáng so sánh khi cần quy trình phê duyệt; bài không đánh giá chi tiết chúng.
Nếu nhu cầu thật sự là đặt câu hỏi cho kho tài liệu thay vì quản lý hồ sơ, một phương án lai gồm công cụ chuyển đổi tài liệu và kho vector có thể đủ. Paperless-ngx đặt trọng tâm vào vòng đời hồ sơ: tiêu thụ, phân loại, phân quyền, chia sẻ, thùng rác và lịch sử thay đổi; AI chỉ là lớp tùy chọn đặt lên trên. [5]
Những trường hợp nên dừng lại trước khi triển khai
Dừng nếu không có hạ tầng tin cậy, hoặc nếu bắt buộc mã hóa ở mức ứng dụng cho từng tài liệu: các tài liệu đã đọc không mô tả tính năng này, và công cụ xuất chỉ mã hóa một số trường khi dùng passphrase. [1][8]
Thận trọng với tài liệu có chữ ký số, vì xoay và xóa trang làm thay đổi tệp gốc, có thể làm mất hiệu lực chữ ký. Từ bản 3, tài liệu trùng chỉ bị cảnh báo; muốn chặn trùng phải bật PAPERLESS_CONSUMER_DELETE_DUPLICATES. Tài liệu đã đọc không mô tả quy trình phê duyệt nhiều cấp, chỉ có workflow theo sự kiện và theo lịch. [5]
Với nhiều người dùng hoặc lưu lượng cao, tài liệu khuyến nghị PostgreSQL thay SQLite mặc định. Chính sách bảo mật ghi rằng báo cáo được xem xét khi nhóm có thời gian và không bảo đảm có bản sửa, nên đơn vị phụ thuộc vào hệ thống cần tự theo dõi các bản phát hành. [3][7]
Lộ trình thí điểm sáu tuần với tiêu chí dừng rõ ràng
Tuần 1 và 2: dựng môi trường thử với dữ liệu giả hoặc dữ liệu đã được phép dùng, cấu hình OCR vie+eng, nhập khoảng 300 hóa đơn nhà cung cấp, hợp đồng khách đoàn và xác nhận đặt dịch vụ; đo tỷ lệ lỗi ký tự OCR trên 30 trang có bản gõ tham chiếu và tỷ lệ ngày tạo được đọc đúng. Mọi ngưỡng và số lượng ở đây là thiết kế cho thí điểm, chưa phải kết quả.
Tuần 3 và 4: bật quy tắc email cho một hộp thư phụ, dựng workflow gán nhãn và quyền. Ghi tỷ lệ tài liệu được gán đúng loại và correspondent, số lần sửa tay mỗi ngày, số truy vấn tìm đúng chứng từ trong 20 truy vấn mẫu. Kiểm thử bằng tài khoản vai trò kinh doanh: không được thấy bản scan hộ chiếu nào, kể cả qua tìm kiếm toàn cục. [5]
Tuần 5 và 6: diễn tập sao lưu bằng document_exporter, khôi phục sang máy khác cùng phiên bản, chạy sanity checker và thử nâng cấp một bản vá. Dừng nếu OCR tiếng Việt không đủ để tìm kiếm, phân quyền thất bại mà workflow không khắc phục được, hoặc khôi phục không thành công; mở rộng khi các chỉ số đạt ngưỡng đặt trước và đã có người phụ trách vận hành. [8]
Kết luận: lưu trữ có trật tự trước, AI là lớp tùy chọn
Paperless-ngx có mô hình dữ liệu và luồng tiêu thụ rõ ràng, kèm tài liệu vận hành chi tiết từ cài đặt, sao lưu đến bảo trì. Giá trị nằm ở việc biến giấy tờ phân tán thành kho có OCR, metadata, phân quyền và workflow. [4][8]
Điều kiện thành công phần lớn nằm ngoài phần mềm: máy chủ tin cậy, quy ước nhãn rõ, OCR tiếng Việt được đo, kỷ luật sao lưu. Bật AI hay OCR từ xa với giấy tờ tùy thân phải là quyết định chính sách có người ký duyệt.
Với công ty lữ hành giả định, nên bắt đầu từ hóa đơn nhà cung cấp, nơi rủi ro thấp và lợi ích tìm kiếm thấy ngay; hồ sơ khách hàng chỉ nên đưa vào sau khi kiểm thử phân quyền đạt yêu cầu.
Phương pháp, phiên bản mã và phạm vi nguồn
Paperless-ngx thuộc nhóm RAG và quản trị tri thức. Căn cứ chọn là bản sao lưu trữ do một bên độc lập duy trì của các trang Trending: trang lưu ngày 18/01/2026 xếp paperless-ngx/paperless-ngx trong mục Python. Bản lưu chỉ có bốn mục Python, Go, JavaScript, Swift và vắng hai ngày 3/9 và 12/10/2026, vì vậy loạt bài không đại diện cho một Top 100 chính thức. [9]
Nhận định kỹ thuật được đối chiếu với README, LICENSE, SECURITY.md và năm tài liệu index, usage, setup, configuration, administration trong thư mục docs tại commit 973af89f611785a2e21c157a59f4f45dc86dfea1, tạo ngày 11/10/2026 và được rà soát ngày 12/10/2026. Tài liệu ở một commit có thể khác bản phát hành đang chạy. [1][2][3][4][5][6][7][8]
Phương pháp là đọc tài liệu: Paperless-ngx không được cài, không được chạy thử, tốc độ hay độ chính xác OCR không được đo; dữ liệu GitHub API ngày 12/10/2026 không ghi nhận kho ở trạng thái archived. Tình huống lữ hành, ước lượng nguồn lực và lộ trình thí điểm là đề xuất phân tích, không phải công bố khoa học đã bình duyệt.
Xem mã nguồn Paperless-ngx trên GitHub