PyTorch: nền tảng học sâu từ huấn luyện tới triển khai mô hình trong nhà máy
Đăng ngày 12/10/2026
Mục lục bài nghiên cứu
Tóm tắt: PyTorch là động cơ học sâu, chưa phải ứng dụng AI hoàn chỉnh
PyTorch là gói Python cung cấp hai năng lực nền: tính toán tensor (mảng số nhiều chiều) giống NumPy nhưng tăng tốc bằng GPU, và mạng nơ-ron sâu dựng trên autograd, cơ chế tự tính đạo hàm theo kiểu "băng ghi" [1]. Đây là bộ công cụ để xây dựng, huấn luyện và triển khai mô hình [6], không kèm sẵn mô hình kiểm tra lỗi hay phần mềm nghiệp vụ.
Nên cân nhắc khi cần huấn luyện hoặc tinh chỉnh mô hình trên dữ liệu riêng như ảnh sản phẩm, tín hiệu cảm biến, và muốn kiểm soát đường đi tới tệp mô hình chạy ở hiện trường; torch.export chụp mô hình thành đồ thị có thể lưu, nạp và chạy ở môi trường khác [8]. Điều kiện là đội ngũ viết được Python và theo kịp nhịp nâng cấp.
Không nên bắt đầu bằng PyTorch nếu phần mềm đóng gói đã đủ tốt, nếu chưa ai chịu trách nhiệm về mô hình, hoặc nếu không thể cập nhật đều đặn, vì bản vá bảo mật chỉ áp dụng cho bản phát hành hiện hành [3]. Khuyến nghị: chọn bài toán hẹp có dữ liệu gán nhãn, ghim bản phát hành chính thức thay vì commit nhánh phát triển, đo trước khi mở rộng.
Vấn đề gốc: gom GPU, đạo hàm tự động và mã Python về một chỗ
Huấn luyện mạng nơ-ron cần cùng lúc phép tính nhanh trên phần cứng tăng tốc, cơ chế tính gradient (đạo hàm theo từng trọng số) và cách mô tả kiến trúc đủ linh hoạt để thử nghiệm. README định vị PyTorch vừa thay NumPy để dùng GPU, vừa là nền tảng nghiên cứu học sâu [1].
Lựa chọn thiết kế cốt lõi là thực thi mệnh lệnh: dòng lệnh chạy ngay khi gọi, stack trace chỉ đúng chỗ định nghĩa phép tính, và đạo hàm ngược cho phép đổi hành vi mạng giữa các lượt chạy [1]. README đặt điều này cạnh cách nhìn "đồ thị tĩnh" mà nó gán cho vài framework thế hệ trước; đó là tự mô tả của dự án, không phải đánh giá độc lập.
Với doanh nghiệp, khó khăn nằm ở khoảng cách giữa sổ tay thí nghiệm và máy tính cạnh dây chuyền. Bộ biên dịch và công cụ xuất mô hình thu hẹp một phần khoảng cách đó [6][8]; dữ liệu, gán nhãn, kiểm định và quản lý phiên bản mô hình vẫn là việc của đơn vị triển khai.
Kiến trúc theo tầng: tensor, autograd, nn.Module, bộ biên dịch, lớp phân tán
Tầng dưới là tensor, cấu trúc dữ liệu nền nằm trên CPU hoặc GPU, kèm phép cắt lát, chỉ mục, đại số tuyến tính, rút gọn [1][6]. Autograd ghi lại phép tính trên tensor và dựng đồ thị tính toán động để tính gradient [6]. Về hiệu năng, PyTorch tích hợp Intel MKL, cuDNN, NCCL và có bộ cấp phát bộ nhớ GPU riêng [1].
Tầng mô hình xoay quanh nn.Module, lớp cơ sở quản lý tham số [6]. DataLoader lo chia lô, xáo trộn, nạp song song; torch.multiprocessing chia sẻ bộ nhớ tensor giữa các tiến trình [1][6]. Nguồn dữ liệu riêng kế thừa Dataset hoặc IterableDataset, phép toán đặc thù viết bằng C++ thành toán tử tùy biến [5].
Phía trên là bộ biên dịch, tập công cụ tối ưu cách chạy và giảm tài nguyên [6]; torch.export dùng TorchDynamo, AOT Autograd và Torch FX để biến chương trình thành đồ thị toán tử ATen [8]. Lớp phân tán có torchrun với rendezvous (điểm hẹn để tiến trình tìm thấy nhau) và khởi động lại khi lỗi [4]. Phần cứng chọn lúc build: CUDA, ROCm (chỉ Linux) hoặc GPU Intel, tắt bằng biến như USE_CUDA=0 [1].
Eager, torch.compile hay torch.export: ba cách chạy một mô hình
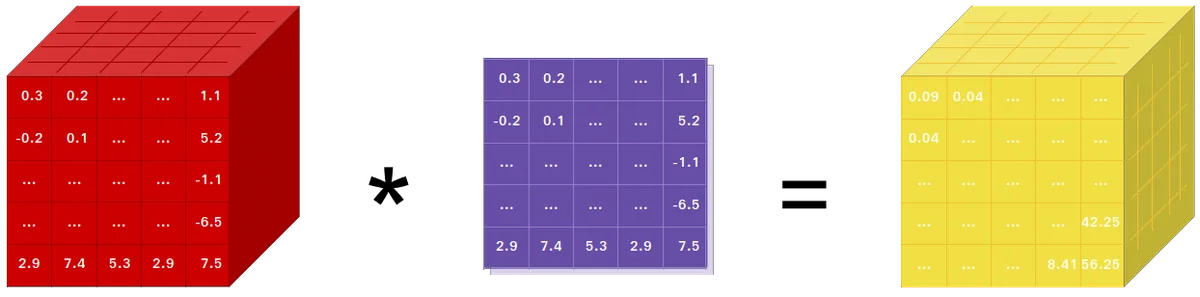
Mặc định PyTorch chạy eager, từng phép tính thực thi ngay trong Python [1]. torch.compile là trình biên dịch JIT: gặp mã không truy vết được thì tạo "graph break" và lùi về Python. torch.export là AOT (biên dịch trước), nhắm tới đồ thị trọn vẹn và báo lỗi thay vì lùi [8].
Đồ thị của torch.export tách khỏi runtime Python nên lưu, nạp và chạy được ở môi trường khác; đổi lại phải bổ sung thông tin hoặc viết lại mã [8]. Mặc định mọi kích thước đầu vào là tĩnh; chiều thay đổi như kích thước lô phải khai báo qua Dim và dynamic_shapes, hoặc để Dim.AUTO, AdditionalInputs suy ra [8].
Có ba mức biểu diễn trung gian: Training IR khoảng 3.000 toán tử, Inference IR thuần hàm khoảng 2.000 sau run_decompositions, Core ATen IR khoảng 180 cho backend tối giản [8]. Đó là số đo độ phức tạp, không phải hiệu năng. Kết quả lưu bằng torch.export.save thành tệp zip theo đặc tả PT2 Archive [8].
Luồng dữ liệu: mẫu huấn luyện, gradient, checkpoint, đồ thị xuất
Khi huấn luyện, mẫu đi từ Dataset qua DataLoader lên thiết bị tính toán [5][6]; trong container, nạp đa tiến trình cần nới bộ nhớ chia sẻ bằng tùy chọn ipc=host hoặc shm-size [1]. Lượt lan truyền xuôi qua nn.Module được autograd ghi lại để lượt ngược tính gradient [6].
Trạng thái lưu thành checkpoint. torch.save mặc định dùng pickle; nên lưu state_dict thay vì cả module; tệp là kho ZIP64 gồm data.pkl, thư mục data, version và byteorder [7]. Từ bản 2.6, torch.load mặc định weights_only=True nếu không truyền pickle_module; tham số mmap cho phép nạp lười [7].
Khi triển khai, mô hình và đầu vào mẫu qua torch.export.export thành ExportedProgram, tham số được nâng thành đầu vào đồ thị, rồi làm thuần hàm bằng run_decompositions trước khi lưu [8]. Huấn luyện nhiều nút thì tiến trình gặp nhau ở rendezvous c10d, mặc định cổng 29400, lỗi một nút được coi là thay đổi thành viên [4]; luồng này phải ở mạng tin cậy vì primitive phân tán không xác thực, không mã hóa [3].
Khả năng đã đối chiếu tại commit be90fe2
README xác nhận các thành phần torch, torch.autograd (hỗ trợ mọi phép tensor khả vi), torch.nn, torch.multiprocessing và torch.utils với DataLoader [1]. Bản cài có qua pip, Conda, image Docker dựng sẵn; wheel cho NVIDIA Jetson được ghi là do hai người đóng góp có tên duy trì [1].
torch.export hỗ trợ chiều động, ba mức IR, lưu và nạp chương trình, draft-export để liệt kê trước điểm không truy vết được, và chế độ non-strict khi TorchDynamo chưa hỗ trợ một cấu trúc Python [8]. Khâu lưu trữ có weights_only mặc định, danh sách cho phép add_safe_globals, hàm get_unsafe_globals_in_checkpoint, biến TORCH_FORCE_WEIGHTS_ONLY_LOAD=1 và checksum CRC32 bật sẵn [7].
Về tái lập có torch.manual_seed, torch.use_deterministic_algorithms, cờ cudnn.benchmark và gieo hạt cho worker [10]; về quy mô có torchrun chịu lỗi, co giãn số nút [4], hook quan sát toán tử và ghi nhận API [5]. Phần còn thử nghiệm cần tách riêng: torch.distributed trên Windows là prototype [1], và bảng tương thích đánh dấu vài bản CUDA cùng Python 3.15t là experimental [9].
Ai làm việc trực tiếp với PyTorch, ai dùng qua lớp ứng dụng
Người hưởng lợi trực tiếp là kỹ sư học máy, nhà nghiên cứu và đội sản phẩm cần mô hình riêng: thị giác cho kiểm tra chất lượng, chuỗi thời gian cảm biến, ngôn ngữ, giọng nói. Đội quen NumPy, SciPy bắt nhịp nhanh vì lớp mạng viết được ngay bằng Python [1].
Nhiều đội dùng PyTorch gián tiếp qua thư viện miền và mô hình huấn luyện sẵn; RELEASE.md coi TorchVision (pytorch/vision) là thư viện miền chính chủ, chuẩn bị nhánh phát hành song song với lõi [9]. Doanh nghiệp vừa nên tinh chỉnh một kiến trúc thị giác phổ biến thay vì thiết kế mạng mới.
PyTorch không dành cho bộ phận cần công cụ kéo thả, đội chỉ gọi API mô hình bên ngoài, hay tổ chức không có người vận hành GPU và Python. Các đơn vị đó nên đánh giá sản phẩm xây trên PyTorch thay vì chính framework.
Đề xuất cho nhà máy linh kiện điện tử Bắc Ninh: "ý kiến thứ hai" cho ảnh AOI
Giả sử một nhà máy quy mô vừa ở khu công nghiệp Bắc Ninh lắp ráp bo mạch dán bề mặt (SMT) cho khách hàng FDI. Máy AOI (kiểm tra quang học tự động) gắn cờ nhiều điểm nghi lỗi và kỹ thuật viên QC phải xem lại từng ảnh; giả định là nhiều cờ là báo động giả, khiến QC quá tải giờ cao điểm. Đây là tình huống đề xuất, chưa phải dự án đã diễn ra.
Mô hình phân loại được huấn luyện bằng PyTorch trên ảnh AOI đã gắn cờ cùng phán quyết lịch sử của QC: đạt, hoặc thiếu linh kiện, lệch vị trí, cầu thiếc, thiếu thiếc. Nó chỉ sắp thứ tự hàng chờ; QC vẫn quyết định. Ảnh và nhãn lưu nội bộ, phiên bản hóa theo mã sản phẩm và lô, vì thiết kế bo mạch là tài sản của khách hàng.
Việc huấn luyện diễn ra trên máy trạm GPU trong phòng máy; mô hình xuất bằng torch.export với chiều lô động cho máy cạnh chuyền [8], kết quả ghi vào MES (hệ thống điều hành sản xuất) kèm phiên bản, sự cố thì quay về kiểm tra thủ công. Nếu cần torchrun, lưu lượng phải nằm trong phân vùng mạng riêng [3][4]. Vì dữ liệu huấn luyện có thể bị khôi phục từ trọng số [3], tệp trọng số cần được bảo vệ ngang bộ ảnh và hợp đồng với khách hàng nên được rà trước.
Vận hành: ghim bản phát hành, khớp CUDA, lên lịch nâng cấp
Commit khảo sát thuộc nhánh phát triển, nên sản xuất cần ghim bản phát hành. Theo RELEASE.md, bản 2.14 cần Python từ 3.10, C++20, CUDA ổn định 12.6, 13.0 hoặc 13.2; bản 2.15 nâng lên Python 3.11; bản phân phối nhắm Linux x86_64 và aarch64 (glibc 2.17 trở lên), macOS arm64, Windows 10 trở lên; CUDA và ROCm thường chỉ được hỗ trợ hai bản minor mới nhất [9].
Lịch cho thấy các bản minor năm 2026 cách nhau khoảng tám tuần, mốc tương lai chỉ là dự kiến; bản vá tùy chọn, tối đa hai bản và chỉ cho minor mới nhất [9]. Cộng với việc không backport bản vá bảo mật [3], nhà máy cần quy trình kiểm thử hồi quy để nâng cấp vài lần mỗi năm thay vì đóng băng phiên bản.
Chỉ build từ nguồn khi cần tùy biến: cần trình biên dịch C++20 (gcc 11.3.0 trở lên trên Linux), ít nhất 10 GB đĩa, 30 đến 60 phút cho lần đầu [1]. Mỗi lần nâng cấp phải chạy lại bộ đánh giá vì kết quả không bảo đảm giống hệt giữa bản phát hành, commit, nền tảng hay giữa CPU và GPU; chế độ tất định giảm biến động nhưng thường chậm hơn [10].
Bảo mật: mô hình là chương trình, checkpoint là đầu vào không tin cậy
SECURITY.md viết rằng mô hình PyTorch là chương trình: chạy mô hình không tin cậy tương đương chạy mã không tin cậy [3]. Dự án khuyên tách trọng số khỏi mã Python, kiểm tra nguồn gốc hoặc checksum, chạy mô hình lạ trong sandbox như container hay máy ảo; safetensors an toàn nhất nhưng hạn chế nhất, torch.load linh hoạt hơn nhưng bề mặt tấn công lớn hơn [3].
weights_only thu hẹp nguy cơ thực thi mã từ xa nhưng không chống từ chối dịch vụ và chưa loại trừ hỏng bộ nhớ [7]; nó chỉ bảo đảm khâu giải tuần tự hóa, không bảo đảm đối tượng nạp ra an toàn khi dùng tiếp [3]. Mô hình TorchScript, kể cả tệp .ptl, là mã thực thi; ngay công cụ soi như torch.utils.model_dump cũng có thể chạy mã bên trong [3]. Đặt TORCH_FORCE_WEIGHTS_ONLY_LOAD=1 trên máy suy luận là chốt chặn ít tốn kém [7].
Rủi ro lớn nhất trong nhà máy là lớp phân tán: c10d, RPC, TCPStore không phân quyền, không mã hóa, nhận kết nối từ mọi nơi, nên ai vào được mạng là chạy được mã tùy ý; checkpoint phân tán cũng không được weights_only che chắn [3]. Dự án không coi crash do tham số sai, khác biệt số học hay cạn tài nguyên là lỗ hổng [3], nên ứng dụng phải tự kiểm tra đầu vào. Lỗ hổng thật báo qua GitHub security advisory và được công bố hoặc bác bỏ trong 90 ngày [3].
Giấy phép kiểu BSD ba điều khoản và ranh giới của nó
API GitHub ghi giấy phép của kho là "Other", mã NOASSERTION, nên phải đọc văn bản. LICENSE tại commit là văn bản kiểu BSD với ba điều kiện: giữ thông báo bản quyền trong mã nguồn, tái hiện thông báo khi phân phối nhị phân, không dùng tên Facebook, Deepmind, NYU, NEC Laboratories America hay IDIAP để quảng bá sản phẩm phái sinh khi chưa được phép; phần mềm được cung cấp nguyên trạng [2]. README cũng gọi đây là giấy phép kiểu BSD [1].
Bản quyền phân tán giữa nhiều tổ chức qua hai nguồn gốc PyTorch và Caffe2; riêng Caffe2 theo mô hình mỗi người đóng góp giữ bản quyền phần mình [2]. Nhà máy đóng gói PyTorch vào image cho máy cạnh chuyền vì vậy phải kèm văn bản giấy phép và các thông báo bản quyền.
Danh mục tệp tại commit cho thấy third_party, torch/_vendor và QNNPACK có tệp giấy phép riêng, cần rà khi phân phối một bản build tùy biến. Bản nhị phân gắn với MKL, cuDNN, NCCL [1] và Triton [9], mỗi thành phần có điều khoản riêng. Giấy phép không bao trùm trọng số tải về, dữ liệu hay mô hình doanh nghiệp tạo ra; tên và logo PyTorch theo hướng dẫn thương hiệu riêng [1].
Chi phí: phần mềm miễn phí, vòng đời mô hình thì không
Giấy phép không thu phí; chi phí thật nằm ở con người, phần cứng, dữ liệu và thời gian vận hành. Bài không đưa giá vì giá biến động theo thời điểm, chỉ đưa khung để doanh nghiệp tự điền.
Giả định cho tình huống Bắc Ninh: một kỹ sư học máy trong khoảng ba tháng, kỹ thuật viên QC vài giờ mỗi tuần để gán nhãn, một người IT hoặc OT lo mạng và sao lưu. Phần cứng gồm máy trạm GPU có VRAM đủ cho mô hình ảnh, máy cạnh chuyền suy luận bằng CPU hoặc GPU nhỏ, và kho lưu ảnh theo phiên bản.
Chi phí ẩn gồm gán nhãn lại khi đổi mã sản phẩm, kiểm thử hồi quy theo nhịp minor khoảng tám tuần [9], viết lại mã cho torch.export [8] và tốc độ giảm khi bật chế độ tất định [10]. Đơn vị đo nên là chi phí cho mỗi ảnh phân loại đúng hoặc số giờ kiểm tra lại mà QC tiết kiệm được, đo trong pilot chứ không giả định.
So sánh hướng đi: chỉnh máy AOI, mua phần mềm thị giác hay tự xây
Hướng thứ nhất là tinh chỉnh ngưỡng trên phần mềm AOI của nhà cung cấp máy: không cần đội học máy nhưng dư địa có hạn. Hướng thứ hai là mua phần mềm thị giác công nghiệp có học sâu: khởi động nhanh, có hỗ trợ, nhưng phải xem dữ liệu có rời nhà máy không và phí bản quyền tính theo trạm ra sao.
Hướng thứ ba là tự xây bằng framework mở; ngoài PyTorch còn TensorFlow với Keras và JAX, nên chọn theo kỹ năng đội, mô hình sẵn có và đích triển khai. Phần so sánh với framework "đồ thị tĩnh" trong README là tự mô tả [1]; bài không so sánh tốc độ.
Khi suy luận có thể giữ eager, dùng chương trình torch.export [8] hoặc chuyển sang ONNX Runtime, TensorRT, OpenVINO; mỗi lần đổi định dạng cần kiểm tra tương đương số học. So sánh công bằng đòi hỏi cùng bộ ảnh, cùng máy và cùng tiêu chí: độ nhạy với lỗi thật, thời gian so với nhịp chuyền, công sức vận hành.
Hạn chế và lúc chưa nên chọn PyTorch
PyTorch là framework, không phải nền tảng MLOps trọn gói: các nguồn đã đọc không mô tả công cụ gán nhãn, sổ đăng ký mô hình hay tích hợp MES trong kho. Thiếu người hiểu dữ liệu và biết đánh giá mô hình thì framework không cứu được dự án.
torch.export buộc viết lại mã khi gặp phần không truy vết được, rẽ nhánh phụ thuộc dữ liệu hay toán tử thiếu kernel fake/meta [8]. Kết quả không tái lập tuyệt đối giữa phiên bản và phần cứng [10]; lớp phân tán không dành cho mạng không tin cậy [3] và trên Windows còn là prototype [1].
Bản vá bảo mật chỉ có ở bản hiện hành [3], bản patch chỉ cho minor mới nhất [9], nên nhà máy mà mỗi thay đổi phần mềm phải được khách hàng duyệt sẽ khó cân bằng. Chưa nên dùng khi chưa có nhãn đáng tin, khi quy tắc xác định đã đủ, hoặc khi hợp đồng đòi giải pháp đã được chứng nhận.
Pilot mười hai tuần với tiêu chí dừng rõ ràng
Tuần 1 đến 3: thống nhất danh mục lỗi với QC, gom ảnh có phán quyết, cho hai kỹ thuật viên gán nhãn độc lập một tập con để đo mức đồng thuận; chia tập kiểm tra theo lô hoặc ngày để ảnh cùng bo không rơi vào cả hai phía; ghim PyTorch và CUDA theo bảng tương thích [9], cố định hạt giống và bật thuật toán tất định khi đánh giá [10].
Tuần 4 đến 7, ngoại tuyến: đo độ nhạy với lỗi thật, tỷ lệ ảnh đạt được xếp đúng vào nhóm ưu tiên thấp, độ ổn định qua ba lượt huấn luyện; xuất bằng torch.export với chiều lô động [8] và so đầu ra bản eager với bản xuất theo dung sai ghi trước. Tuần 8 đến 12, chạy song song (shadow mode) trên một chuyền: đo thời gian mỗi ảnh so với nhịp chuyền, độ sẵn sàng, mức khớp với QC, và kiểm tra việc ép weights_only [7] cùng cô lập thành phần phân tán [3].
Dừng nếu có lỗi nghiêm trọng bị xếp ưu tiên thấp khi chạy song song, nếu đồng thuận giữa hai kỹ thuật viên quá thấp, nếu suy luận không kịp nhịp chuyền, hoặc nếu đội không xong một vòng kiểm thử nâng cấp trong một chu kỳ phát hành. Chỉ chuyển sang hỗ trợ thật khi người phụ trách chất lượng ký nhận các ngưỡng đã đạt.
Kết luận: chọn PyTorch khi sẵn sàng sở hữu mô hình
PyTorch có tài liệu rõ về tensor, autograd, xuất mô hình, tái lập và bảo mật [1][3][8]; giá trị lớn nhất là biến dữ liệu nội bộ thành mô hình chạy tại hiện trường, không phụ thuộc dịch vụ bên ngoài.
Cái giá là trách nhiệm tự gán nhãn, kiểm định, nâng cấp và bảo vệ checkpoint như bảo vệ mã. Ở nhà máy Bắc Ninh, mô hình chỉ nên là ý kiến thứ hai; quyết định chất lượng vẫn do con người ký.
Chưa có người làm chủ vòng đời đó thì nên chọn sản phẩm đóng gói; đã có thì pilot mười hai tuần là cách ít tốn kém nhất để biết giá trị thật.
Nguồn, phiên bản và giới hạn nghiên cứu
Dự án được chọn từ kho lưu độc lập các danh sách GitHub Trending theo ngôn ngữ: pytorch/pytorch xuất hiện 13 lần từ 08/01/2026 đến 11/10/2026; trang bằng chứng là danh sách Python ngày 08/01/2026, vị trí 15 [11]. Kho lưu chỉ có Python, Go, JavaScript, Swift, thiếu ngày 03/09 và 12/10, và không phải Top 100 chính thức của GitHub.
Đối chiếu dựa trên commit be90fe2665c2b8579dfc50cad211ac154eae2649 (ngày commit 12/10/2026, nhánh phát triển), kiểm tra ngày 12/10/2026, gồm README [1], LICENSE [2], SECURITY.md [3], hướng dẫn elastic [4], ghi chú triển khai quy mô lớn [5], tổng quan thành phần [6], tuần tự hóa [7], torch.export [8], RELEASE.md [9] và tính tái lập [10]; nhận định về thư mục có giấy phép riêng dựa trên danh mục tệp tại cùng commit.
Đây là nghiên cứu tài liệu, không phải bài báo khoa học đã qua phản biện; PyTorch không được cài, chạy hay đo trong quá trình viết. Tình huống, chi phí, so sánh và kế hoạch thử nghiệm là đề xuất của bài.
Xem mã nguồn PyTorch trên GitHub