RAGFlow 1.0 RC: động cơ RAG hiểu tài liệu sâu và cái giá vận hành đi kèm
Đăng ngày 12/10/2026
Mục lục bài nghiên cứu
RAGFlow nên được đánh giá như hạ tầng tri thức, không phải một ứng dụng chat
RAGFlow là động cơ RAG (Retrieval-Augmented Generation, sinh câu trả lời dựa trên tài liệu được truy xuất) mã nguồn mở của infiniflow, xây quanh khâu hiểu tài liệu sâu: phân tích bố cục, OCR, nhận dạng bảng, chia đoạn theo mẫu để trả lời có trích dẫn. [1][3] README còn đặt mục tiêu kết hợp RAG với agent thành lớp ngữ cảnh cho mô hình ngôn ngữ lớn (LLM). [1]
Thời điểm khảo sát rơi vào giai đoạn chuyển đổi: bản 1.0.0-rc1 ra ngày 29/09/2026, và từ tag này backend là bản triển khai Go chạy từ một tệp nhị phân. [1][5] RC (release candidate) là bản ứng viên, chưa phải bản ổn định cuối, nên các nhận định dưới đây cần đọc lại khi có bản chính thức.
Nên cân nhắc RAGFlow khi tài liệu khó đọc, như bản scan, bảng, trang nhiều cột, slide, và đội ngũ cần xem, sửa từng đoạn trước khi đưa vào truy xuất. Chưa nên chọn nếu chỉ có máy Mac hoặc máy ARM, thiếu người vận hành Docker trên Linux, hoặc cần một hệ thống đã ổn định lâu dài. [3][5]
Vì sao “đưa PDF vào vector database” thường chưa đủ
RAG đơn giản nhất là trích văn bản thô, cắt theo số token cố định rồi nhúng thành vector. Với giáo trình scan, bảng nhiều cột hay slide, văn bản thô dễ mất cấu trúc: tiêu đề tách khỏi nội dung, hàng bảng bị cắt đôi. Câu trả lời khi đó vẫn có nguồn nhưng có thể dẫn sai đoạn; đây là nhận định phân tích, không phải số đo.
RAGFlow lấy khâu đầu vào làm trọng tâm theo khẩu hiệu “chất lượng vào, chất lượng ra”: trích xuất tri thức dựa trên hiểu tài liệu định dạng phức tạp, chia đoạn theo mẫu có thể giải thích, hiển thị kết quả chia đoạn để con người can thiệp. [1] Quickstart cho phép xem từng đoạn, thêm từ khóa hoặc câu hỏi để nâng thứ hạng của đoạn. [3]
Bài khái niệm của dự án mở rộng vấn đề sang “context engineering”: nhà phát triển phải tự lắp lời nhắc, logic truy xuất, mô tả công cụ, lịch sử hội thoại cho từng agent. Bài phác thảo một Agent Context Engine gồm lõi tri thức, lớp bộ nhớ và bộ điều phối công cụ như tương lai RAGFlow hướng tới [9]; phần này được xếp vào định hướng, không vào tính năng đã kiểm chứng.
Một tệp nhị phân Go, bốn chế độ chạy và một cụm dịch vụ phụ trợ
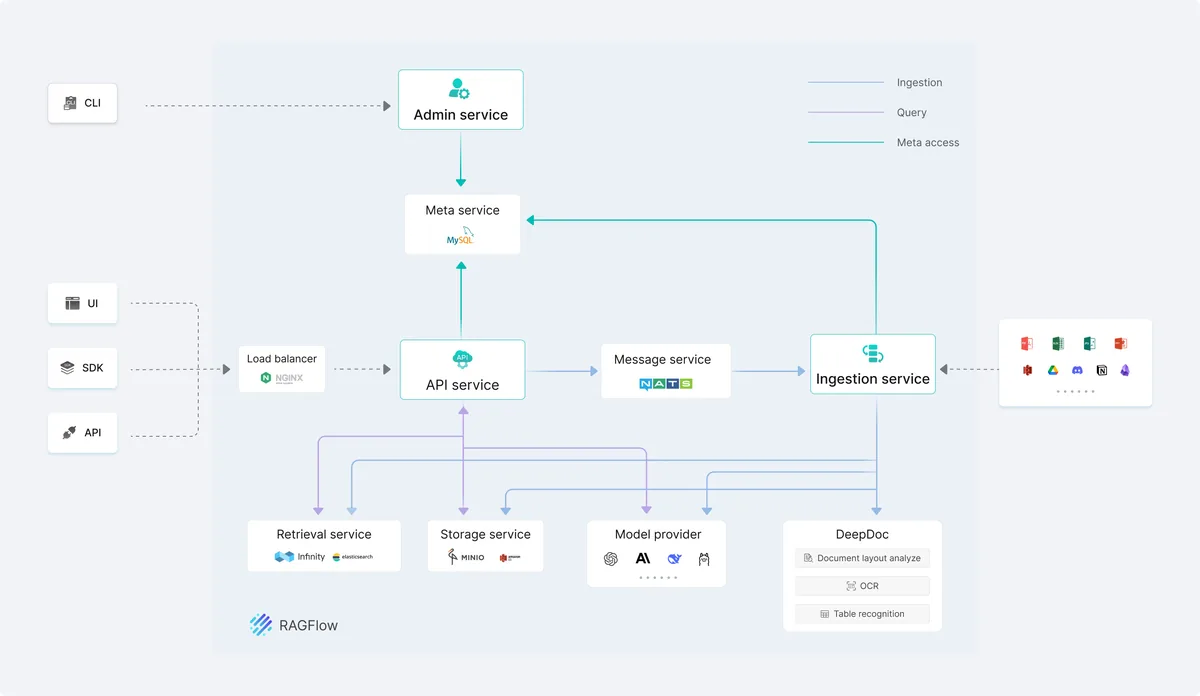
Image Docker bản Go chạy bốn chế độ API, Admin, Ingestor, Syncer từ cùng tệp bin/ragflow_server; DeepDoc, bộ phân tích bố cục, OCR và cấu trúc bảng, chạy trong tiến trình bằng ONNX Runtime liên kết tĩnh. [5] Theo README, Admin lo quản trị ở cổng 9381, Ingestor nạp và phân tích dữ liệu, Syncer đồng bộ nguồn ngoài, API phục vụ giao diện web và SDK ở cổng 9380. [1]
Cấu hình Compose mặc định kéo theo Elasticsearch, MySQL, MinIO, Kvrocks, NATS và ClickHouse. [5] Elasticsearch là document engine (nơi lưu và tìm kiếm các đoạn) mặc định, thay được qua tệp .env, chẳng hạn bằng Infinity. [1][5] MySQL giữ siêu dữ liệu và đổi được sang OceanBase; MinIO lưu tệp; Kvrocks làm cache tương thích Redis; NATS JetStream làm hàng đợi cho nạp dữ liệu, đồng bộ, bộ nhớ và biên dịch tri thức. [5]
Phía trước là Nginx ở cổng 80 và 443, chuyển yêu cầu web tới API. [5] Thiết kế này tách đường xử lý nặng (Ingestor) khỏi đường phục vụ truy vấn (API), nhưng số thành phần cần vận hành nhiều hơn hẳn một ứng dụng chat đóng gói trong một container.
Bản Go 1.0 RC thay đổi những gì cần biết trước khi cam kết?
Tài liệu Docker ghi rằng tag v1.0.0-rc1 và các tag sau dùng bản triển khai Go; entrypoint di trú cơ sở dữ liệu MySQL rồi khởi động Syncer, Admin, API, Ingestor. [5] Mục tiêu build Docker gốc được hỗ trợ là Linux x86-64; Linux ARM64 chưa được hỗ trợ vì image phụ thuộc thư viện native cho x86-64, còn macOS tạm thời không được backend Go hỗ trợ. [3][5]
Bản dựng từ nhánh phát triển có thể báo phiên bản mã thấp hơn phiên bản di trú của cơ sở dữ liệu và bị từ chối khởi động; RAGFLOW_DEV_MODE chỉ dành cho phát triển, production phải dùng tệp nhị phân có phiên bản không thấp hơn phiên bản di trú. [3] Nghĩa là không quay lui phiên bản tùy ý được, và sao lưu trước mỗi lần nâng cấp là bắt buộc.
Ở bản mã nguồn mở 1.0, DeepDoc suy luận bằng CPU cho phân tích bố cục, OCR và nhận dạng bảng. [1][5] Với kho lớn toàn bản scan, thời gian phân tích là ẩn số phải đo trên phần cứng thật.
Đường đi của một tài liệu: phân tích, chia đoạn, làm giàu, lập chỉ mục, truy xuất
Dataset trong RAGFlow là một tập tài liệu, gắn với một mô hình embedding (chuyển văn bản thành vector) và một phương pháp phân tích. Mô hình embedding không đổi được sau khi đã dùng để phân tích tệp, vì mọi tệp trong dataset phải cùng một không gian vector. [3]
Bước phân tích dùng phương pháp dựng sẵn hoặc một ingestion pipeline tùy biến. Phương pháp dựng sẵn gồm General, Q&A, Manual, Table, Paper, Book, Laws, Presentation, One, Tag, Audio, Email; với PDF có thể chọn DeepDOC, Naive, Docling, OpenDataLoader, TCADP, MonkeyOCRv2 hoặc mô hình thị giác bên ngoài, kèm tùy chọn bỏ mục lục, đầu trang, chân trang. [6]
Bước chia đoạn: General Chunker nhắm khoảng 512 token mỗi đoạn, có chồng lấn và chế độ đoạn cha–con; Title Chunker cắt theo cấp tiêu đề, có thể gắn đường dẫn tiêu đề vào đoạn. Bước làm giàu dùng mô hình sinh từ khóa, câu hỏi, thẻ, tóm tắt ngữ cảnh, siêu dữ liệu; bước lập chỉ mục chọn vector, toàn văn hoặc cả hai. [6]
Khi truy vấn, điểm PageRank của dataset được cộng vào điểm tương đồng lai của đoạn khớp [6], và README mô tả truy xuất nhiều đường kết hợp xếp hạng lại. [1] Trợ lý chat trả lời có trích dẫn; điền mục Empty response thì hệ thống trả đúng câu đó khi không tìm thấy gì, để trống thì mô hình có thể ứng biến và dễ bịa. [3]
Năng lực đã đối chiếu, tách khỏi phần định hướng
Nhóm tài liệu: nhận Word, PowerPoint, Excel, TXT, ảnh, PDF, bản scan, dữ liệu có cấu trúc, trang web; chia đoạn theo mẫu; trực quan hóa kết quả chia đoạn để con người chỉnh; trích dẫn truy vết được. [1] Cập nhật gần đây có nạp website qua sitemap (10/09/2026) và Google BigQuery với đồng bộ tăng dần (02/07/2026). [1]
Nhóm truy xuất nâng cao, có từ 19/08/2026: Agentic Retrieval để mô hình tách câu hỏi, truy xuất và kiểm chứng bằng chứng qua nhiều vòng với bốn mức suy nghĩ Low, Medium, High, Ultra; Knowledge Compilation biên dịch tài liệu và dataset thành wiki, đồ thị, cây, PageIndex, sơ đồ tư duy, dòng thời gian, skill. [1] Hai tính năng còn mới nên cần thử độ ổn định.
Nhóm tích hợp và quản trị: HTTP API có khóa API, hỗ trợ mô hình chạy cục bộ qua Ollama, Xinference, LocalAI [3]; thành phần CodeExec chạy mã Python, JavaScript trong sandbox [4]; đăng nhập OAuth2, OIDC hoặc GitHub [5]; hệ thống quyền ba lớp và phạm vi chia sẻ tài nguyên. [8][7]
Cần đọc như định hướng: bài khái niệm Agent Context Engine viết bằng giọng tầm nhìn [9], lộ trình 2026 nằm trong một issue GitHub mà bài không đọc, và dịch vụ cloud của RAGFlow là kênh riêng, không đồng nghĩa với bản tự lưu trữ. [1]
Ai hưởng lợi nhiều nhất từ phân tích bố cục và chia đoạn theo mẫu?
Phù hợp nhất là tổ chức có kho tài liệu đa dạng, khó đọc: sách, sổ tay, báo cáo nghiên cứu, văn bản luật, bảng biểu, bộ hỏi đáp. Danh sách phương pháp phân tích dựng sẵn, từ Book, Manual, Paper, Laws tới Table và Q&A, cho thấy dự án nhắm vào chính các dạng này. [6]
Đội ngũ cần ít nhất một người quen Docker trên Linux, sẵn sàng theo dõi nhiều dịch vụ phụ trợ; cấu hình khởi điểm được khuyên là 4 nhân CPU, 16 GB RAM, 50 GB ổ trống. [1] Đội có kỹ sư dữ liệu khai thác được ingestion pipeline và API; đội nghiệp vụ vẫn dùng được giao diện dataset và chat.
Lĩnh vực tiêu biểu: giáo dục, pháp lý, sản xuất có tài liệu kỹ thuật, tổ chức nghiên cứu. Ít phù hợp với cá nhân muốn chạy trên laptop Mac, hoặc nhóm chỉ hỏi đáp vài chục tệp văn bản thuần, khi một ứng dụng chat tài liệu gọn hơn sẽ đỡ công vận hành.
Kịch bản đề xuất: thư viện học liệu có trích dẫn cho một tổ chức phi lợi nhuận về giáo dục
Giả định một tổ chức phi lợi nhuận hỗ trợ giáo viên tiểu học vùng núi phía Bắc, văn phòng tại Hà Nội, khoảng 200 giáo viên cộng tác. Học liệu gồm sách bài tập scan, giáo án DOCX, slide và ghi âm tập huấn, tệp hỏi đáp từ đường dây hỗ trợ. Mục tiêu: giáo viên hỏi bằng tiếng Việt, nhận câu trả lời trỏ đúng trang, đúng slide. Kịch bản chưa từng được triển khai.
Dataset tách theo dạng tài liệu: sách bài tập dùng Book với DeepDOC cho PDF scan; tập huấn dùng Presentation; hỏi đáp dùng Q&A để mỗi cặp thành một đoạn; ghi âm dùng Audio, vốn cần mô hình nhận dạng giọng nói bên ngoài. [6] Title Chunker nhận biểu thức chính quy cho tiêu đề H1 đến H5, nên khai báo được mẫu “Chương”, “Bài”, “Tiết” của sách Việt Nam. [6]
Học liệu công khai đặt phạm vi Team; báo cáo nhà tài trợ và danh sách giáo viên đặt Only me, vì tài nguyên không tự được chia sẻ. [7] Trợ lý chat nên điền Empty response để từ chối khi thiếu học liệu. [3] Múi giờ mặc định của bản Docker là Asia/Shanghai, nên đổi TZ sang Asia/Ho_Chi_Minh. [5] Không nạp dữ liệu cá nhân của học sinh.
Hai điểm cần đo riêng: trường Language của dataset ảnh hưởng giả định ngôn ngữ khi phân tích [6], nên phải thử cấu hình hợp nhất với văn bản có dấu; và chất lượng OCR của DeepDoc trên giáo trình scan mờ hoặc chụp nghiêng.
Vận hành cần máy Linux đủ mạnh, cấu hình chặt và theo dõi sức khỏe dịch vụ
Yêu cầu khởi điểm: 4 nhân CPU x86-64, 16 GB RAM, 50 GB ổ trống, Docker từ 24.0.0, Compose từ v2.26.1; mô hình cục bộ và OceanBase cần thêm tài nguyên. [3] Dùng Elasticsearch thì phải đặt vm.max_map_count tối thiểu 262144 và ghi vào /etc/sysctl.conf để giữ sau khi khởi động lại. [1][3]
MEM_LIMIT là trần bộ nhớ cho từng container, mặc định khoảng 7,52 GiB, không phải tổng bộ nhớ hệ thống dùng. [5] Image không kèm mô hình embedding; profile tei-cpu hoặc tei-gpu khởi chạy dịch vụ embedding cục bộ, và HF_ENDPOINT cho phép dùng mirror khi khó truy cập Hugging Face. [5]
Sức khỏe dịch vụ kiểm tra qua /api/v1/system/healthz; container RAGFlow không có healthcheck trong Compose nên cần giám sát từ ngoài, khi lỗi thì đọc nhật ký container ragflow-cpu [1], cũng là nơi quickstart chỉ tới khi phân tích bị đứng. [3]
Nâng cấp theo tag cố định và sao lưu MySQL, MinIO, document engine trước mỗi lần đổi phiên bản, vì máy chủ từ chối chạy trên cơ sở dữ liệu đã được phiên bản mới hơn di trú. [3]
Bề mặt tấn công rộng hơn: nhiều cổng, mật khẩu mặc định và một sandbox chạy mã
Quickstart yêu cầu đổi mật khẩu mặc định trước khi đưa lên máy truy cập được qua mạng. [3] Tài liệu Docker cho thấy nhiều cổng được công bố ra máy chủ: Elasticsearch 1200, MySQL 3306, MinIO 9000 và 9001, Kvrocks 6379, cùng cổng NATS. [5] Chỉ nên để Nginx ra ngoài; cổng khác chặn bằng tường lửa hoặc bỏ ánh xạ.
HTTPS dùng chứng chỉ Let's Encrypt hoặc chứng chỉ sẵn có gắn vào Nginx; đăng nhập OAuth2, OIDC hoặc GitHub nối được với hệ thống danh tính của tổ chức. [5] Quyền có ba lớp, thành viên nhóm, phạm vi chia sẻ và quyền thao tác, áp dụng cho knowledge base, agent, chat, ứng dụng Search, memory. [8]
Thành phần CodeExec cần sandbox. Nhà cung cấp mặc định self_managed chạy mã trong container Docker trên nền gVisor; mạng mặc định là none, bộ nhớ 256 MB mỗi container, giới hạn 10 giây, seccomp mặc định tắt; executor manager nghe ở 127.0.0.1 với token chia sẻ cần đặt mạnh. [4] Các nhà cung cấp aliyun_codeinterpreter, e2b, tenki chạy mã trên đám mây; ssh chạy trên máy từ xa. [4]
Khi dataset dùng mô hình thị giác, ASR hay LLM bên ngoài, nội dung tài liệu đi tới nhà cung cấp đã cấu hình. [6] Tổ chức xử lý dữ liệu nhạy cảm nên chọn mô hình cục bộ qua Ollama, Xinference hoặc LocalAI. [3]
Apache-2.0 bao phủ mã nguồn; bản cloud và các “phiên bản” khác cần tách bạch
LICENSE tại commit khảo sát là văn bản Apache License 2.0 chuẩn, không kèm dòng bản quyền điền sẵn. Giấy phép cho phép dùng, sửa, phân phối, kèm quyền sáng chế từ người đóng góp; điều kiện gồm giữ thông báo, ghi rõ tệp đã sửa, chuyển kèm NOTICE nếu có; quyền sáng chế chấm dứt nếu người dùng khởi kiện sáng chế liên quan; nhãn hiệu không được cấp phép. [2]
Giấy phép chỉ áp dụng cho mã tại commit này, không bao trùm dịch vụ RAGFlow Cloud hay tài nguyên mô hình và thư viện native mà script download_deps.py tải về khi build [1], parser bên ngoài như Docling, MonkeyOCRv2 [6], sandbox đám mây [4], cũng như mô hình embedding do tổ chức tự chọn, vì image không đóng gói sẵn mô hình nào. [5]
Một số tài liệu dùng cụm “phiên bản mã nguồn mở”: open-source edition chỉ có phạm vi chia sẻ Only me và Team, DeepDoc dùng CPU trong bản mã nguồn mở 1.0. [7][5] Cách nói này gợi ý có phiên bản khác mà tài liệu đã đọc không mô tả; yêu cầu bắt buộc nào phụ thuộc vào đó cần hỏi nhà phát triển và đọc hợp đồng.
Nguồn lực thực tế: máy chủ nền, giờ kỹ thuật và chi phí mô hình theo từng tùy chọn
Giả định: tổ chức giáo dục nói trên, khoảng 5.000 tệp, 20 người dùng cùng lúc giờ cao điểm. Cần một máy Linux x86-64 đạt mức khởi điểm [1]; embedding cục bộ bằng profile tei-cpu hay tei-gpu cần thêm RAM hoặc GPU [5]; kho scan lớn có thể cần nhiều nhân CPU hơn vì DeepDoc bản 1.0 chạy trên CPU. [5]
Chi phí mô hình phụ thuộc cấu hình dataset: tự sinh từ khóa, câu hỏi, tóm tắt ngữ cảnh, siêu dữ liệu, hay phân tích PDF và bảng bằng mô hình thị giác đều làm tăng lời gọi và token. [6] Nên bật từng tùy chọn trên tập mẫu, so chất lượng truy xuất với chi phí phát sinh, thay vì bật tất cả ngay từ đầu.
Giờ công gồm một kỹ sư hệ thống bán thời gian cho cài đặt, sao lưu, nâng cấp, giám sát; một người phụ trách học liệu chọn phương pháp phân tích, rà đoạn lỗi; nhóm giáo viên tình nguyện soạn và chấm câu hỏi. Với tổ chức phi lợi nhuận, giờ tình nguyện cũng nên được ghi nhận trong đề xuất xin tài trợ.
Các hướng tiếp cận thay thế và khác biệt về triết lý
So với ứng dụng chat tài liệu đóng gói như AnythingLLM hay Open WebUI, RAGFlow đầu tư nhiều hơn vào phân tích và chia đoạn, đổi lại cần nhiều dịch vụ phụ trợ. So với thư viện RAG theo đồ thị như LightRAG hay Microsoft GraphRAG, RAGFlow là nền tảng có giao diện, người dùng, pipeline, còn thư viện thường được nhúng vào ứng dụng tự xây.
Tự lắp ghép bằng LlamaIndex, Haystack hoặc LangChain cùng Docling hay một bộ OCR riêng cho phép chọn từng mảnh, nhưng đội phải tự làm giao diện kiểm tra đoạn, phân quyền và trích dẫn. Dịch vụ quản lý trên đám mây, kể cả bản cloud của RAGFlow, giảm việc vận hành nhưng đặt dữ liệu ngoài hạ tầng tổ chức.
Phương án tối giản là công cụ tìm kiếm toàn văn có OCR cùng thư mục học liệu gắn nhãn tốt: không có câu trả lời tổng hợp nhưng rẻ và dễ kiểm chứng. Bài chỉ so sánh ở mức cách tiếp cận, không đánh giá chất lượng các sản phẩm được nhắc tên.
Những điều kiện khiến RAGFlow chưa phải lựa chọn tốt
Trạng thái RC và việc chuyển sang backend Go khiến tài liệu, API và quy trình nâng cấp có thể còn đổi; chạy production trên bản ứng viên là chấp nhận rủi ro. [1][5] Build Docker gốc chỉ hỗ trợ Linux x86-64, chưa hỗ trợ macOS và ARM64. [3][5]
Mô hình embedding bị khóa sau lần phân tích đầu [3], chọn sai nghĩa là phân tích lại cả dataset. Thay đổi cấu hình siêu dữ liệu hay vai trò cột bảng chỉ áp dụng cho tài liệu phân tích sau đó; tài liệu cũ phải phân tích lại. [6]
Không nên chọn RAGFlow khi tổ chức không có người vận hành Linux, phần cứng dưới mức khởi điểm, hoặc kho chỉ gồm ít tệp văn bản thuần. Cũng nên dè dặt với mô tả tiếp thị như tìm “kim trong đống dữ liệu không giới hạn token” [1]: đó là tuyên bố của nhà phát triển, cần kiểm chứng trên dữ liệu thật.
Thử nghiệm ba giai đoạn với bộ học liệu mẫu và tiêu chí dừng
Giai đoạn 1, hai tuần: dựng RAGFlow trên máy Linux x86-64 theo tag cố định, đổi mọi mật khẩu mặc định, chặn cổng phụ trợ, bật HTTPS và đăng nhập OIDC. [3][5] Tạo ba dataset nhỏ khoảng 50 tệp mỗi loại, gồm cả bản scan xấu; qua giai đoạn khi endpoint sức khỏe ổn định và không tệp nào kẹt ở khâu phân tích quá ngưỡng đặt trước.
Giai đoạn 2, ba tuần: giáo viên cộng tác soạn 150 câu hỏi kèm trang hoặc slide nguồn. So ba cấu hình, General với DeepDOC, phương pháp chuyên biệt theo loại tài liệu, và phương pháp chuyên biệt cộng tự sinh câu hỏi [6], theo tỉ lệ trích đúng trang, tỉ lệ từ chối đúng, số đoạn phải sửa tay, thời gian phân tích mỗi trăm trang và lượng token.
Giai đoạn 3, hai tuần: 20 giáo viên dùng thử; kiểm tra phạm vi chia sẻ bằng tài khoản ngoài nhóm; cài chỉ dẫn độc hại vào tài liệu để xem trợ lý có làm theo không. Dừng nếu dữ liệu nhóm hạn chế bị lộ, tỉ lệ trích đúng dưới ngưỡng đặt trước, hoặc công vận hành vượt sức; chỉ mở rộng khi đạt cả ba và đã có bản chính thức. Kế hoạch này chưa có số đo.
Kết luận: mạnh ở khâu hiểu tài liệu, đòi kỷ luật vận hành tương xứng
RAGFlow nổi bật vì coi tài liệu đầu vào là trọng tâm: nhiều phương pháp phân tích theo loại tài liệu, giao diện xem và sửa đoạn, truy xuất lai có trọng số và trích dẫn. [1][6] Với học liệu, văn bản luật hay tài liệu kỹ thuật phức tạp, đây là những năng lực đáng thử.
Cái giá là hạ tầng nhiều thành phần, yêu cầu Linux x86-64 và giai đoạn chuyển sang bản Go còn ở mức RC. [3][5] Giấy phép Apache-2.0 thuận lợi, miễn là tách bạch mã nguồn với mô hình, dịch vụ cloud và các phiên bản khác. [2]
Lời khuyên cho tổ chức phi lợi nhuận hay doanh nghiệp nhỏ: thử trên tập mẫu có đáp án, bật tùy chọn tốn token có chủ đích, và chỉ cam kết khi đã có bản phát hành chính thức cùng quy trình sao lưu đã diễn tập.
Cách chọn dự án, phiên bản đã đọc và giới hạn của bài
RAGFlow được chọn cho nhóm RAG và quản trị tri thức từ một kho lưu độc lập các danh sách GitHub Trending. Dữ liệu tuyển chọn ghi 22 lần xuất hiện từ 26/02 đến 11/10/2026; bằng chứng là danh sách Python ngày 26/02/2026, vị trí thứ 9. [10] Kho chỉ theo dõi Python, Go, JavaScript, Swift, thiếu ngày 03/09 và 12/10, nên không đại diện cho toàn bộ GitHub Trending và không phải Top 100 chính thức.
Đối chiếu dựa trên commit e4695ca5594b70820d130374d904a038e57ec816 (ngày commit 12/10/2026), kiểm tra ngày 12/10/2026: README, LICENSE, quickstart, hướng dẫn sandbox [1][2][3][4] và năm tài liệu bổ sung về Docker, cấu hình dataset, phạm vi chia sẻ, tổng quan quyền, Agent Context Engine. [5][6][7][8][9] Hướng dẫn về MCP, memory, kênh chat, di trú phiên bản chưa được đọc nên không vào danh sách tính năng đã xác minh.
Phương pháp là nghiên cứu bàn giấy có trợ giúp của AI: RAGFlow chưa được cài hay chạy thử, và văn bản không phải bài báo đã qua phản biện. Kịch bản giáo dục, chi phí, kế hoạch thử nghiệm là đề xuất. Dự án nằm trong danh sách Python hồi tháng 2 [10] nhưng tài liệu tại commit khảo sát mô tả backend Go [5], dấu hiệu của thay đổi nhanh; hãy đọc lại tài liệu của bản phát hành định dùng.
Xem mã nguồn RAGFlow trên GitHub