SeaweedFS: kho S3 và tệp phân tán cho ảnh, nhật ký và hồ sơ của nhà thầu xây dựng
Đăng ngày 12/10/2026
Mục lục bài nghiên cứu
SeaweedFS có đáng thay chỗ lưu ảnh và hồ sơ rải rác khắp nơi không?
SeaweedFS là hệ thống lưu trữ phân tán, được README mô tả với hai mục tiêu: lưu hàng tỷ tệp và phục vụ chúng nhanh. Theo README, một tệp nhị phân duy nhất tên weed có thể cung cấp kho đối tượng tương thích S3, hệ thống tệp kiểu POSIX và một lớp lakehouse với S3 Tables trên cùng dữ liệu. [1]
Kết luận ngắn của bài viết: SeaweedFS đáng thử khi tổ chức có nhiều tệp nhỏ và vừa, cần giao diện S3 để công cụ có sẵn dùng được, và có người đủ kỹ năng vận hành một cụm lưu trữ. Nó không đáng thử nếu nhu cầu chỉ là vài terabyte chia sẻ trong văn phòng, nơi một thiết bị NAS hay dịch vụ lưu trữ thuê ngoài đơn giản hơn nhiều. Đây là lập luận của người viết, không phải kết quả đo.
Cần phân biệt ba lớp: tính năng của bản mã nguồn mở ở commit này, những điều dự án tự khẳng định mà chưa được kiểm chứng độc lập, và Enterprise Edition thương mại có thêm một số khả năng. [1] Tình huống đề xuất trong bài dành cho một nhà thầu xây dựng cần lưu ảnh công trường, nhật ký thi công và hồ sơ nghiệm thu từ nhiều công trình về một nơi có kiểm soát.
Hàng chục nghìn tệp nhỏ và vài tệp khổng lồ: kho nào cũng sợ trường hợp này
Nhiều hệ thống tệp truyền thống đặt mỗi tệp thành một mục riêng với siêu dữ liệu riêng. Khi số lượng tệp lên tới hàng chục triệu, việc tra thông tin tệp thành điểm nghẽn trước cả dung lượng đĩa. README của SeaweedFS xuất phát từ chính vấn đề đó, nên nhấn mạnh việc gói các tệp nhỏ vào những tệp volume chỉ ghi nối thêm, thay vì tạo một inode cho mỗi tệp. [1]
Dự án cho biết mô hình khởi nguồn từ bài báo Haystack của Facebook, phần mã hóa xóa (erasure coding) học từ f4, và tổng thể có nhiều điểm chung với Tectonic và Colossus. [1]
Ngoài quy mô còn bài toán tiếp cận: ứng dụng muốn nói bằng S3, người dùng muốn gắn như thư mục, dữ liệu phân tích muốn bảng Iceberg. README nhận cả ba trên cùng một hệ thống, giảm số hệ thống cần học nhưng tăng bề mặt cần hiểu. [1]
Ba vai trò master, volume, filer và vì sao master không đứng trên đường đọc
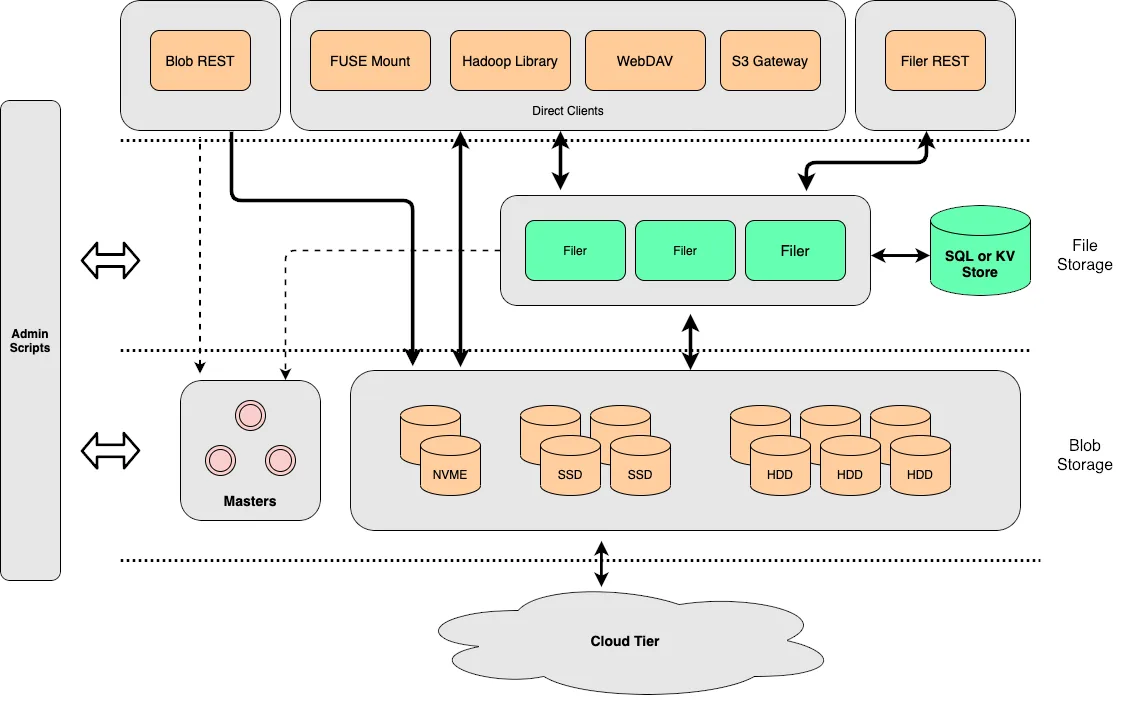
README mô tả ba loại máy chủ. Master, chạy một hoặc nhóm ba theo Raft, theo dõi volume nào nằm trên volume server nào và cấp mã tệp, nhưng không nằm trên đường đọc dữ liệu. Volume server lưu blob trong các tệp volume chỉ ghi nối, giữ trong bộ nhớ một mục chỉ mục 16 byte cho mỗi blob, và nhân bản hoặc mã hóa xóa ở cấp volume. Filer thêm lớp thư mục và tệp bên trên, đặt siêu dữ liệu trong một kho do bạn chọn, rồi mở các giao diện HTTP, S3, WebDAV, SFTP, FUSE và danh mục bảng. [1]
Lý do master nhỏ là nó chỉ theo dõi volume chứ không theo dõi từng tệp. README viết rằng cụm hàng tỷ tệp chỉ có vài nghìn volume, và máy khách lưu đệm ánh xạ volume tới máy chủ để gọi thẳng volume server. [1] Filer và cổng S3 được mô tả là không giữ trạng thái nên thêm bớt theo tải. [1]
Ở mức byte, tài liệu về cấu trúc needle (đơn vị lưu một blob trong volume) cho thấy mỗi needle gồm cookie 4 byte để chống dò đoán, mã định danh 8 byte, kích thước, dữ liệu, tổng kiểm CRC32 và phần đệm để căn 8 byte. Phiên bản 2 thêm cờ nén, tên, kiểu MIME, thời gian sửa và TTL; phiên bản 3 thêm dấu thời gian ghi nối. [5]
Một tấm ảnh công trường đi từ điện thoại tới đĩa: ghi, tra cứu, đọc lại
Xét một yêu cầu ghi qua cổng S3. Ứng dụng gọi bộ SDK như với AWS, với endpoint là cổng 8333 trong ví dụ của README. [1] README mô tả tệp nhỏ là một blob, còn tệp lớn được chia thành các khối vài megabyte, mỗi khối là một blob riêng. Master cấp mã tệp và chỉ ra volume nhận ghi, còn filer giữ tên và siêu dữ liệu; đó là cách bài viết diễn giải kiến trúc, không phải kết quả đọc mã từng bước. [1]
Khi đọc, máy khách tra volume cần dùng, rồi gọi thẳng volume server. Volume server tìm mục chỉ mục 16 byte trong bộ nhớ và đọc blob bằng một lần tìm vị trí trên đĩa, kể cả với dữ liệu đã mã hóa xóa; đó là khẳng định của README, chưa được kiểm chứng ở đây. [1] Dữ liệu nóng được nhân bản, dữ liệu ấm được mã hóa xóa nền để lần ghi không phải trả chi phí mã hóa. [1]
Tài liệu kiểm thử mã hóa xóa còn cho thấy hậu quả khi luồng này sai thứ tự: một lỗi từng làm cả tệp .dat gốc lẫn các shard .ec00 tới .ec13 cùng tồn tại, khiến dung lượng dùng tăng gấp đôi, vì vị trí volume được thu thập sau khi master đã cập nhật. Theo tài liệu, lỗi đã được sửa bằng cách thu thập vị trí trước khi mã hóa. [7]
Bảng kê năng lực theo lời README, và phần phải kiểm tra lại trước khi tin
README liệt kê một danh sách dài. Về S3, gateway hỗ trợ 73 thao tác đối tượng và bucket, 36 thao tác S3 Tables, 39 thao tác IAM và 5 thao tác STS; kèm versioning, Object Lock với retention và legal hold, lifecycle, tag, CORS, presigned URL, multipart và mã hóa phía máy chủ SSE-S3, SSE-KMS, SSE-C. [1] Về truy cập, có FUSE, WebDAV, SFTP, HDFS, HTTP, TUS và CSI driver cho Kubernetes. [1]
Về nhân bản và đám mây, README nêu nhân bản chủ động-chủ động giữa các cụm, sao lưu bất đồng bộ lên đám mây, Cloud Drive làm cache cho kho đối tượng ở xa và Cloud Tier chuyển volume ấm lên đám mây. Về bảo mật có AES256-GCM cho dữ liệu nghỉ, TLS, mTLS và JWT cho truy cập volume. [1]
Cần phân biệt ba lớp. Thứ nhất là tính năng đã mô tả trong README, mà bài viết không chạy thử nên chỉ ghi nhận chứ chưa xác nhận. Thứ hai là thành phần đang phát triển: README gọi volume server viết bằng Rust là phương án thay thế trên cùng định dạng đĩa, trong khi cây thư mục có tệp kế hoạch và danh sách tính năng còn thiếu cho thành phần này mà bài viết chưa đọc, nên mức tương đương chưa được khẳng định. Thứ ba là Enterprise Edition thương mại, với các khả năng nâng cao nêu ở phần giấy phép.
Ai hưởng lợi nhiều nhất, ai nên chọn thứ đơn giản hơn
Nhóm hưởng lợi rõ rệt là những tổ chức có khối lượng tệp lớn và đa dạng, tự quản lý hạ tầng vì lý do chi phí, chủ quyền dữ liệu hoặc kết nối. Ví dụ là công ty có nhiều chi nhánh, nhà thầu có nhiều công trường, đội ảnh và video, hoặc đội dữ liệu cần S3 nội bộ. README nói thêm máy chủ volume thì tăng dung lượng, và filer cùng S3 gateway có thể đặt sau bộ cân bằng tải. [1]
Nhóm thứ hai là đội nền tảng chạy Kubernetes, vì chart Helm, Operator và CSI driver có sẵn. [1][6]
Nên chọn thứ khác nếu doanh nghiệp chưa có người vận hành hạ tầng, hoặc cần cam kết hỗ trợ có hợp đồng mà không muốn mua bản thương mại. Dự án tự mô tả là mã nguồn mở độc lập được cộng đồng tài trợ. [1]
Nhà thầu xây dựng: một kho S3 nội bộ cho ảnh, nhật ký và hồ sơ nghiệm thu
Phần này là kịch bản đề xuất, chưa có đơn vị nào được nói là đã làm như vậy. Hình dung một công ty thầu xây dựng ở miền Trung đang chạy nhiều công trường cùng lúc. Mỗi ngày công trường tạo ra ảnh hiện trường, ảnh chụp nhật ký thi công, bản vẽ PDF hoặc CAD, biên bản nghiệm thu và video từ thiết bị bay. Giả định các tệp này đang nằm rải rác trên điện thoại, máy cá nhân và nhóm chat.
Đề xuất là một kho S3 đặt tại trụ sở công ty, mỗi dự án một bucket. README cho biết mỗi bucket là một collection riêng và xóa bucket là tức thì. [1] Điều này tiện nhưng cũng nguy hiểm nếu phân quyền lỏng, nên cần chính sách bucket chỉ cho vài người xóa. Bộ máy chính sách theo mô tả có thứ tự đánh giá Deny rõ ràng trước Allow, rồi mới tới từ chối mặc định. [8] Với hồ sơ đã nghiệm thu, dùng Object Lock với retention để tránh sửa xóa nhầm. [1]
Công trường mạng yếu có thể tải lên bằng công cụ hỗ trợ S3 như rclone khi có kết nối. Bản sao thứ hai đặt ở nơi khác bằng nhân bản bất đồng bộ. [1] Thời hạn lưu hồ sơ theo hợp đồng và pháp luật cần bộ phận pháp lý xác nhận, bài viết không nêu con số. Hệ thống này không thay thế phần mềm quản lý dự án, chỉ là kho chứa.
Vận hành: bắt đầu bằng weed mini, rồi mới tới cụm nhiều máy
Cách khởi động nhanh nhất theo README là lệnh weed mini với thư mục dữ liệu, tạo sẵn một S3 endpoint, một bucket và chạy luôn master, volume, filer, WebDAV, danh mục Iceberg và giao diện Admin trong cùng tiến trình. README gọi chế độ này là tối ưu cho một nút và chấp nhận được cho sản xuất một nút. Nếu không đặt mật khẩu Admin hoặc mTLS, giao diện Admin chỉ nghe ở loopback. [1] Docker, Docker Compose và Helm đều có hướng dẫn. [1]
Với Kubernetes, README chart giải thích master, filer và volume là StatefulSet có anti-affinity theo hostname. Đáng chú ý, dữ liệu master mặc định ở hostPath, nên master được lập lịch sang nút khác sẽ có thư mục rỗng và một mã định danh cụm mới. Tài liệu khuyên dùng PersistentVolumeClaim cho master. [6] Bộ lưu siêu dữ liệu filer mặc định là leveldb, còn để có nhiều bản sao và độ sẵn sàng cao thì nên dùng cơ sở dữ liệu tương thích MySQL. [6]
README cũng thẳng thắn rằng không có gì tự cân bằng cho tới khi bạn yêu cầu: cân bằng, vacuum, mã hóa xóa và sửa chữa chạy theo yêu cầu từ weed shell hoặc worker bảo trì. [1] Tài liệu kiểm thử còn nêu một lỗi đã biết: khi volume server đã đầy, bước cân bằng shard có thể báo không còn chỗ trống dù di chuyển shard sẽ giải phóng chỗ ở nguồn. [7] Vì vậy nên chừa dung lượng trống và diễn tập sự cố.
Bảo mật: mạng tin cậy cho thành phần lõi, S3 và IAM cho người dùng
SECURITY.md nêu mô hình tin cậy rất rõ: master, volume server và API thô của filer được thiết kế chạy trên mạng tin cậy. Các API nội bộ đó không phải ranh giới xác thực trừ khi bạn bật một cơ chế kiểm soát như JWT cho volume hoặc xác thực filer. Phơi cổng nội bộ ra máy khách không tin cậy bị coi là lỗi triển khai, không phải lỗ hổng của SeaweedFS. [3]
Các báo cáo trong phạm vi gồm truy cập trái phép dữ liệu cần xác thực, một danh tính S3 đọc hoặc xóa dữ liệu của danh tính khác, leo thang đặc quyền từ người dùng S3 lên quản trị, vượt Object Lock, và hỏng hoặc mất dữ liệu kích hoạt từ xa. Báo cáo cần có kịch bản tái hiện và chỉ bản phát hành gần đây được xét, còn kết quả quét tự động chưa xác minh sẽ bị coi là gợi ý củng cố. [3] Hàm ý là phải dựng mạng, tường lửa và danh tính trước khi nghĩ đến tính năng.
Ở lớp S3, tài liệu bộ máy chính sách mô tả bucket policy, IAM policy theo người dùng và nhóm, các điều kiện như dải IP hay yêu cầu SSL, và việc chuyển cấu hình identities.json cũ thành chính sách kiểu AWS. [8] README nêu mã hóa phía máy chủ và AES256-GCM cho dữ liệu nghỉ, nhưng chưa được thử ở đây. [1] Cuối cùng, kho có thư mục telemetry với tài liệu triển khai máy chủ thu thập số liệu; các tệp đã đọc không cho biết bản weed có gửi dữ liệu nào ra ngoài hay không, nên cần kiểm tra trước khi dùng trong môi trường nhạy cảm. [4]
Apache 2.0, bản thương mại và các tệp giấy phép khác trong cây thư mục
LICENSE ở gốc kho là văn bản Apache License 2.0, kèm điều khoản cấp phép sáng chế và điều khoản nói rằng giấy phép không cấp quyền dùng nhãn hiệu hay tên sản phẩm. [2] README cũng tuyên bố giấy phép Apache 2.0 và mô tả dự án là mã nguồn mở độc lập. [1]
Ranh giới cần ghi nhớ là Enterprise Edition. README giới thiệu bản này trên website của dự án với các tính năng nâng cao như khôi phục dữ liệu, lưu trữ tự phục hồi, mã hóa xóa tùy biến, vacuum và sửa chữa mã hóa xóa. [1] Điều khoản của bản đó không được đọc. Do đó, bài viết xếp các khả năng này ở nhóm thương mại hoặc chưa kiểm chứng, và không giả định chúng có trong bản mã nguồn mở.
Cây thư mục tại commit khảo sát còn chứa các tệp giấy phép của bên thứ ba, chẳng hạn trong thư mục glog, bản vendor reed-solomon-erasure và tài nguyên giao diện Admin. Bài viết chỉ thấy tên tệp mà chưa đọc nội dung, nên không kết luận điều khoản của chúng. Giấy phép chỉ áp dụng cho mã tại commit này, không bao phủ hình ảnh container do bên khác dựng, dịch vụ đám mây hay dữ liệu của bạn.
Chi phí: dung lượng đĩa nhân hệ số bản sao, cộng thời gian của người vận hành
Chi phí chính nằm ở đĩa và máy chủ. Ví dụ Helm trong README dùng hai bản cho mỗi lần ghi, ba master và ba volume server, nên dung lượng thô cần gấp khoảng hai lần dữ liệu hữu ích trước khi tính mã hóa xóa. [1] Đây là phép tính từ chính ví dụ đó, không phải mô hình chi phí đã kiểm chứng. Mã hóa xóa cho dữ liệu ấm có thể giảm hệ số này nhưng tài liệu đã đọc không nêu con số.
Phần cứng cần nghĩ theo loại: máy chủ nhiều đĩa cho volume, máy nhỏ có đĩa nhanh cho master, nơi lưu siêu dữ liệu filer đáng tin cậy, mạng nội bộ ổn định và nguồn dự phòng. Nhân lực gồm người am hiểu Linux, mạng và lưu trữ, cùng thời gian đọc wiki của dự án.
Nhân bản không phải sao lưu: xóa nhầm hay mã độc mã hóa dữ liệu vẫn có thể lan sang các bản sao. Vì vậy ngân sách nên có thêm bản sao lưu ngoài hệ thống, như sao lưu bất đồng bộ lên đám mây mà README nhắc tới. [1] Giá Enterprise Edition phải hỏi trực tiếp nhà phát triển.
Đặt cạnh Ceph, MinIO, NAS và kho đối tượng thuê ngoài
Phần so sánh trong README do chính dự án viết và tự nhận có thể lỗi thời. Dự án cho rằng SeaweedFS tối ưu cho tệp nhỏ với một lần đọc đĩa và kiến trúc phẳng đơn giản, trong khi Ceph linh hoạt hơn nhưng phức tạp, đặt dữ liệu bằng băm CRUSH. [1] Bài viết coi đó là quan điểm của dự án.
Về MinIO, README viết rằng từ ngày 25 tháng 4 năm 2026 MinIO ngừng phát triển và khuyến cáo mạnh không dùng. Bài viết không kiểm chứng phát biểu này; ai đang dùng MinIO cần kiểm tra trực tiếp trạng thái hiện hành trước khi quyết định di chuyển. [1] README cũng đưa ra bảng đối chiếu với GlusterFS, MooseFS và HDFS ở mức kiến trúc. [1]
Ở mức cách tiếp cận có thêm hai hướng. NAS chuyên dụng dễ vận hành hơn nhưng khó mở rộng theo chiều ngang. Kho đối tượng thuê ngoài chuyển trách nhiệm vận hành đi, đổi lại là chi phí lưu lượng, phụ thuộc đường truyền và vấn đề chủ quyền dữ liệu. Bài viết không có số liệu để xếp hạng; tiêu chí hợp lý là khối lượng tệp, kỹ năng nội bộ và yêu cầu S3.
Những giới hạn: số đo tự công bố, bề mặt rộng và các điểm đã biết
Điều đầu tiên là số liệu hiệu năng. README ghi tốc độ 15.708 lượt ghi và 47.019 lượt đọc ngẫu nhiên mỗi giây với một triệu tệp 1KB, đồng thời tự gọi đó là số "không khoa học", đo trên một máy xách tay có SSD. [1] Bài viết dùng chúng chỉ để minh họa mức độ tuyên bố, không dùng để dự báo hiệu năng hệ thống của bạn.
Thứ hai, bề mặt tính năng rất rộng: S3, Iceberg, Lance, FUSE, WebDAV, SFTP, message queue và hơn mười kho siêu dữ liệu. [1] Rộng nghĩa là nhiều tổ hợp cấu hình cần kiểm thử. Các lỗi đã công bố trong tài liệu kiểm thử mã hóa xóa là bằng chứng của cả hai chiều: dự án có kiểm thử hồi quy, nhưng lỗi nhân đôi dung lượng từng tồn tại. [7]
Thứ ba, các mặc định cần được đọc cẩn thận. Master mặc định lưu hostPath trong chart, cấu hình chứng chỉ được README chart ghi là chưa thử nghiệm, và nhiều bản sao filer cần kho siêu dữ liệu phù hợp. [6] Thứ tư, bài viết không chạy thử gì, nên việc volume server Rust tương đương bản Go hay tương thích một SDK cụ thể đều chưa được xác minh. Không nên dùng cho hồ sơ có yêu cầu pháp lý nghiêm ngặt khi chưa qua diễn tập khôi phục.
Kế hoạch thử nghiệm sáu tuần: từ một nút tới cụm ba máy và diễn tập sự cố
Tuần một: kiểm kê dữ liệu của hai công trường đã hoàn thành về số tệp, kích thước và tần suất truy cập. Chạy weed mini trong mạng nội bộ có đặt mật khẩu quản trị, dùng một bucket thử và các công cụ S3 đang có như AWS CLI. [1] Tiêu chí hoàn thành: tải lên và tải xuống đầy đủ, so sánh tổng kiểm từng tệp, không mất tệp nào.
Tuần hai và ba: dựng cụm ba máy theo mẫu của README chart hoặc Docker Compose, với nhân bản một bản dư, ba master và bộ lưu siêu dữ liệu ngoài nếu cần nhiều filer. [1][6] Bật xác thực S3, bucket policy và Object Lock cho một bucket hồ sơ nghiệm thu. Kiểm tra: thao tác xóa một tệp đang bị khóa phải bị từ chối, và người dùng không có quyền không đọc được bucket khác. [1][8]
Tuần bốn và năm: diễn tập sự cố, gồm tắt một volume server giữa lúc đang tải lên, khởi động lại master, và khôi phục từ bản sao lưu ngoài hệ thống. Tiêu chí do nhóm đặt trước, ví dụ mọi tệp đọc lại đúng tổng kiểm và đội khôi phục được trong thời gian đã thống nhất. Tuần sáu: đánh giá. Tiêu chí dừng là bất kỳ mất dữ liệu nào, hoặc không khôi phục được từ bản sao lưu, hoặc người vận hành không tự xử lý được sự cố sau đào tạo. Đây là ngưỡng đề xuất, không phải số của dự án.
Kết luận: công cụ mạnh cho đúng bài toán, và bài toán phải được chọn trước
SeaweedFS cho thấy một hướng thiết kế khác với hệ thống lưu trữ truyền thống: master nhẹ, volume server đọc một lần tìm, filer tách rời và nhiều giao diện cùng một dữ liệu. [1] Nhưng sức mạnh đó đi kèm việc phải hiểu một hệ thống rộng, và nhiều khẳng định của README chưa được kiểm chứng ngoài dự án.
Với nhà thầu xây dựng trong tình huống giả định, giá trị nằm ở một kho S3 tập trung, có phân quyền, khóa bất biến cho hồ sơ nghiệm thu và nhân bản giữa hai địa điểm. Nên bắt đầu từ pilot nhỏ, đặt tiêu chí dừng trước, và luôn có bản sao lưu ngoài hệ thống. Nếu nhu cầu thật chỉ là chia sẻ tệp văn phòng, một giải pháp đơn giản hơn sẽ hợp lý hơn.
Một site nghiên cứu như phamvanthu.com cũng có thể dùng kho S3 nội bộ cho tài liệu, nhưng đó chỉ là ví dụ áp dụng, không có nghĩa BDSG đang dùng.
Nguồn và phương pháp
Đây là nghiên cứu bàn giấy, không phải công bố khoa học đã bình duyệt, và người viết không cài đặt, chạy, đo hay triển khai SeaweedFS. Dự án được chọn từ kho lưu trữ GitHub Trending; lần ghi nhận đầu tiên là ngày 2026-01-15, vị trí thứ 23 trong danh sách Go. [9] Kho đó chỉ gồm danh sách Python, Go, JavaScript và Swift, thiếu ngày 2026-09-03 và 2026-10-12, và không phải bảng top 100 chính thức.
Commit được ghim là 1076ebdf4aea889d2892163c853a3a8e9ece1d1d, ngày 2026-10-12, kiểm tra ngày 2026-10-12. Các tệp đã đọc gồm README, LICENSE, SECURITY.md, telemetry/DEPLOYMENT.md, tài liệu bố cục needle, README của chart Helm, README kiểm thử mã hóa xóa và tài liệu bộ máy chính sách S3. [1][2][3][4][5][6][7][8]
Văn bản trong kho được coi là dữ liệu tham khảo. Nhận định mang số tham chiếu đối chiếu được với nguồn; phần phân tích, chi phí và tình huống Việt Nam là đề xuất của người viết.
Xem mã nguồn SeaweedFS trên GitHub