Cognee: bộ nhớ đồ thị tri thức cho AI agent, chạy cục bộ và triển khai thực tế
Đăng ngày 12/10/2026
Mục lục bài nghiên cứu
Cognee là gì và nên đặt nó ở đâu trong hệ thống tri thức?
Cognee giới thiệu mình là nền tảng bộ nhớ AI mã nguồn mở, biến tài liệu, mã nguồn và hội thoại thành một đồ thị tri thức tự lưu trữ để agent tìm và dùng lại qua nhiều phiên [1]. Bốn thao tác chính là remember để lưu, recall để truy xuất, improve để làm giàu và áp phản hồi, forget để xóa [1].
Nét riêng đáng chú ý là chế độ không cần khóa API: khi chưa cấu hình LLM, Cognee trích đồ thị bằng mô hình GLiNER cục bộ, tạo embedding bằng mô hình cục bộ chạy trên CPU, và các bước cần LLM tự bỏ qua [1]. Muốn có câu trả lời được sinh tự nhiên hay xử lý ảnh, âm thanh thì vẫn phải cấu hình LLM.
Cognee đáng thử khi câu hỏi phải nối nhiều mẩu thông tin qua quan hệ, kiểu “quyết định này dựa trên trao đổi nào”, hoặc khi agent cần trí nhớ xuyên phiên gắn với tri thức nội bộ. Nếu chỉ cần tìm đoạn văn giống câu hỏi, RAG vector thông thường đơn giản hơn. Khuyến nghị của bài: thử trên một miền dữ liệu hẹp và đo xem đồ thị có thật sự làm câu trả lời tốt hơn hay không.
Vì sao RAG theo đoạn văn chưa đủ cho bộ nhớ của agent?
RAG cổ điển cắt tài liệu thành đoạn, nhúng thành vector rồi lấy đoạn gần câu hỏi nhất. Cách này hụt hơi khi đáp án rải ở nhiều tài liệu và chỉ lộ ra qua quan hệ giữa các thực thể, hoặc khi agent cần nhớ quyết định, lỗi đã sửa, quy tắc rút ra từ phiên làm việc trước.
README nêu ba tình huống Cognee nhắm tới: dựng “bộ não công ty” nối một quyết định với cuộc thảo luận và phần triển khai đằng sau; cho agent trí nhớ xuyên các lượt chạy bằng cách chưng cất bài học trong phiên thành tri thức bền; và neo agent vào miền nghiệp vụ bằng mô hình dữ liệu tùy chỉnh cùng ontology [1].
Đồ thị chỉ tốt bằng bước trích xuất: thực thể sai hay quan hệ thiếu sẽ dẫn agent tới kết luận sai mà trông vẫn có cấu trúc. Vì vậy bài coi đồ thị là một giả thuyết cần đo trên dữ liệu thật, không phải bản nâng cấp mặc định của RAG.
Cognee ghép đồ thị, vector và phiên làm việc như thế nào?
Theo README, văn bản được biến thành thực thể, quan hệ và các đoạn tìm kiếm được; mã nguồn thành đồ thị ký hiệu và phụ thuộc; chưng cất phiên đưa những bài học đã được chấp nhận vào bộ nhớ lâu dài. Lúc truy vấn, bước truy xuất chọn ngữ cảnh từ đồ thị, vector hoặc mã [1].
Bản Docker tối giản dùng các cơ sở dữ liệu cục bộ mặc định là SQLite, LanceDB và Ladybug [4]; Helm chart triển khai backend kèm PostgreSQL có pgvector [5]. README cho biết từ bản 1.0 có thể chạy cả lớp nhớ trên một Postgres, nhưng Postgres làm graph store mới ở mức demo, còn bản sẵn sàng production là sản phẩm có giấy phép thương mại [1].
Phần xử lý được tổ chức thành pipeline gồm các task, mỗi task là một hàm async chạy trên luồng phần tử và được bộ chạy nối thành chuỗi; thư mục cognee/tasks chia nhóm cho chunking, đồ thị, đồ thị mã không dùng LLM, ingestion, memify, presort, provenance, lưu trữ, tóm tắt, dịch và thu thập web [2]. Lớp giao tiếp gồm SDK Python, CLI, REST API, máy chủ MCP, plugin cho Claude Code, Codex, OpenClaw cùng SDK TypeScript và Rust [1].
Dữ liệu đi qua add, cognify và recall ra sao?
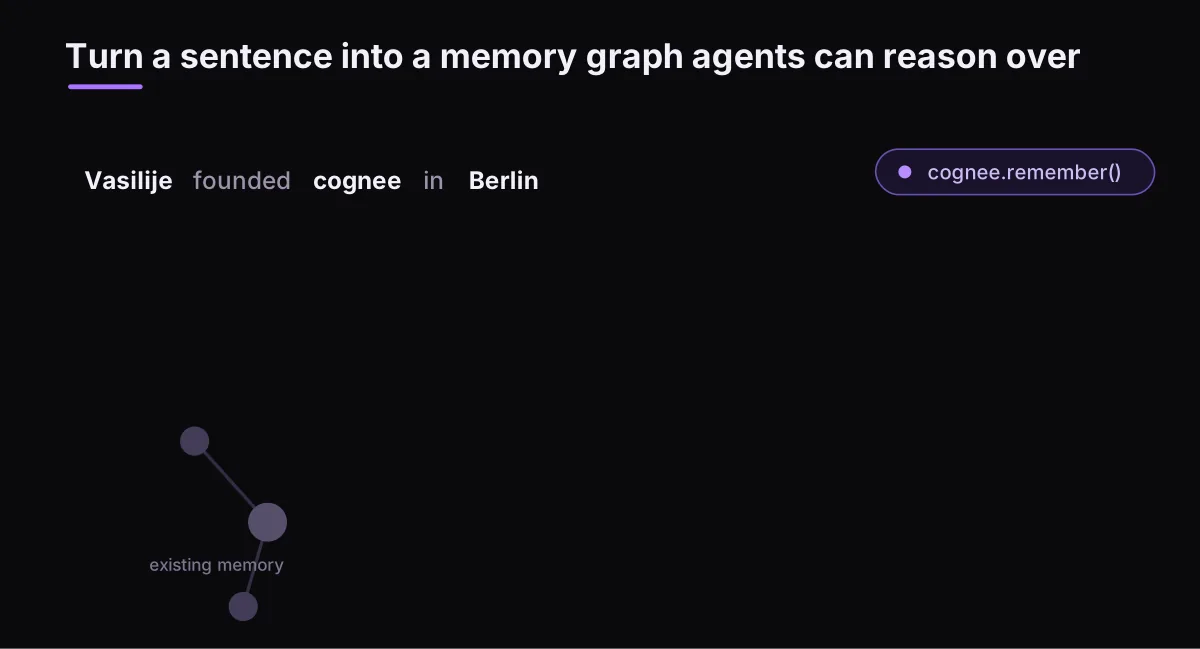
Qua REST API, luồng tối thiểu có ba bước: gửi tệp vào /api/v1/add theo tên dataset, gọi /api/v1/cognify để dựng đồ thị, rồi truy vấn /api/v1/search với kiểu tìm kiếm như GRAPH_COMPLETION [4]. Trong SDK, remember gói phần nạp và xử lý, còn recall lo truy xuất [1].
Pipeline cognify mặc định có bảy bước: phân loại dữ liệu thành tài liệu có kiểu; cắt đoạn; trích thực thể và cạnh bằng LLM hoặc GLiNER; tóm tắt đoạn bằng LLM; ghi điểm dữ liệu vào graph và vector store; ghi sổ provenance khi bật PROVENANCE_TRACKING; phát hiện mâu thuẫn khi bật CONTRADICTION_DETECTION [2]. Ngày tháng được trích ngay ở bước ba thành nút Timestamp [2].
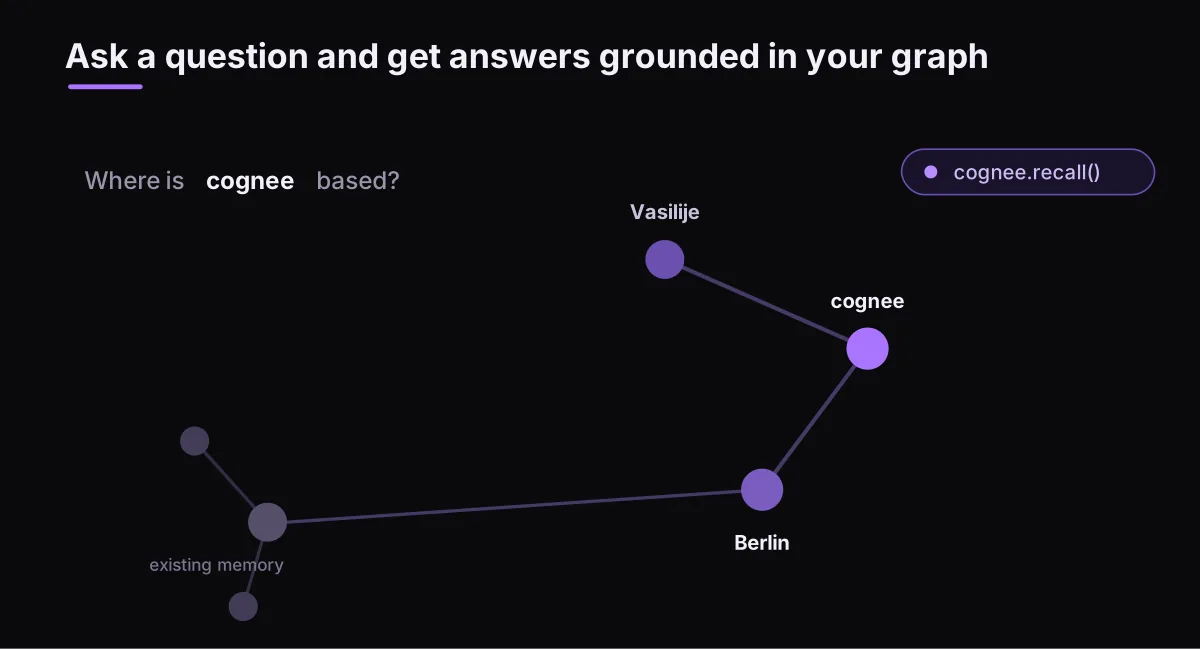
Ở chiều đọc, recall là cửa vào mặc định, search là thao tác cấp thấp bên dưới. recall thêm bộ định tuyến chọn kiểu tìm kiếm, cho phép lấy kết quả từ đồ thị, bộ nhớ phiên, vết hoạt động của agent hay đồ thị mã, và gắn nhãn nguồn cho từng kết quả [3]. Kiểu mặc định HYBRID_COMPLETION tìm trên đoạn văn, bản tóm tắt dựng sẵn và vùng lân cận của thực thể trong một lần gọi LLM [3].
Năng lực nào đã có trong bản mở, phần nào thuộc thương mại?
Theo README, bản mở hiện có: chạy cục bộ không cần khóa API; bốn thao tác remember, recall, improve, forget; đồ thị mã; lệnh demo dùng dữ liệu mẫu và tìm từ khóa; giao diện xem đồ thị; và nhập ký ức từ Mem0, Letta, Zep hoặc Graphiti qua định dạng COGX [1]. Chỉ mục task bổ sung bước presort phân loại, băm, khử trùng lặp và phát hiện dữ liệu cá nhân (PII) trước khi nạp, bước dịch nội dung đoạn trước khi trích xuất, và nạp lược đồ cùng dữ liệu từ cơ sở dữ liệu quan hệ [2].
Ranh giới thương mại được README nói khá thẳng: GLiNER đi kèm chỉ là bản demo của pipeline mô hình nhỏ, muốn bản production chính xác hơn phải liên hệ nhà phát triển; Postgres làm graph store bản production là sản phẩm có giấy phép; Cognee Cloud là lựa chọn dịch vụ được quản lý [1].
README công bố điểm BEAM 0,79 ở ngữ cảnh 100 nghìn token và 0,67 ở 10 triệu token, kèm lưu ý hai cấu hình khác nhau về hội thoại, mô hình nạp và cách chọn truy xuất, còn kết quả 10 triệu token chỉ mang tính thăm dò [1]. Bài không tái lập các số này.
Bộ định tuyến của recall xử lý câu hỏi tiếng Việt thế nào?
Khi không chỉ định kiểu truy vấn, recall dò một bảng quy tắc biểu thức chính quy theo thứ tự và không gọi LLM: cả câu nằm trong ngoặc kép thì tìm từ vựng, cụm “coding rules” thì lấy quy tắc lập trình, giới từ chỉ thời gian đứng trước một ngày tuyệt đối thì sang TEMPORAL, còn lại đi HYBRID_COMPLETION [3].
Các giới từ thời gian trong bảng đều là tiếng Anh như in, before, since, between [3]. Suy luận của bài: câu “giá nhập từ tháng 7/2026” nhiều khả năng không khớp và rơi về mặc định, còn quy tắc ngoặc kép dựa vào dấu câu nên vẫn hợp với tiếng Việt. Thiệt hại không lớn vì nhánh TEMPORAL chỉ xếp lại ứng viên của HYBRID theo khung thời gian [3]; cái mất là phần xếp hạng theo ngày.
Cách xử lý thực tế là để giao diện quyết định: khi người dùng chọn khoảng ngày, ứng dụng truyền thẳng query_type TEMPORAL, điều tài liệu cho phép ở SDK, REST và CLI [3]. Cũng cần nhớ rằng khi không có LLM khả dụng, recall chọn CHUNKS trước cả bộ định tuyến [3], nên mọi phép thử tiếng Việt phải ghi rõ đang chạy chế độ nào.
Ai được lợi nhiều nhất từ một đồ thị tri thức tự lưu trữ?
Nhóm kỹ thuật muốn agent lập trình nhớ quyết định và quy tắc dự án qua nhiều phiên là đối tượng được chăm chút nhất, với plugin Claude Code, Codex và máy chủ MCP [1]. Đồ thị mã được dựng bằng công cụ xác định, không dùng LLM [2], hợp với câu hỏi kiểu “hàm nào đang gọi dịch vụ này”.
Doanh nghiệp có tài liệu, phiếu hỗ trợ và cơ sở dữ liệu rời rạc có sẵn ví dụ dựng “bộ não công ty” từ cả ba nguồn [1]. Người làm tri thức cá nhân cũng có lối vào: skill companion trả lời dựa trên thư mục ghi chú như kho Obsidian và nhớ các cuộc trò chuyện trước [6], một hình mẫu gần với cách một trang tri thức cá nhân như phamvanthu.com có thể thử, miễn là tách bạch phần công khai và phần riêng tư.
Cognee ít hợp với tổ chức chỉ cần tìm văn bản đơn thuần, hoặc không có ai đủ hiểu mô hình dữ liệu để thiết kế ontology; khi đó công dựng và kiểm định đồ thị có thể vượt lợi ích thu được.
Một chuỗi nhà thuốc có thể dùng Cognee làm “bộ não” nội bộ ra sao?
Tình huống giả định: một chuỗi nhà thuốc khoảng ba mươi điểm bán ở đồng bằng sông Cửu Long có quy trình thao tác chuẩn, quy định bảo quản, chính sách đổi trả, danh mục sản phẩm trong cơ sở dữ liệu và tờ hướng dẫn sử dụng thuốc dạng PDF. Dược sĩ cửa hàng hay phải gọi trưởng khu vực để hỏi “biệt dược nào cùng hoạt chất với mặt hàng đang hết” hay “quy định bảo quản mới áp dụng từ khi nào”.
Đề xuất dựng mỗi vùng một dataset; danh mục sản phẩm nạp bằng task di chuyển cơ sở dữ liệu quan hệ và nạp lược đồ thành nút đồ thị [2], còn tài liệu đi qua cognify để nối hoạt chất, biệt dược, nhóm thuốc, điều kiện bảo quản và nhà cung cấp. Trước khi nạp, bước presort có phát hiện PII giúp sàng các thư mục lỡ chứa đơn thuốc hay thông tin khách [2]; dữ liệu bệnh nhân nằm ngoài phạm vi thí điểm.
Hệ thống chỉ phục vụ nhân viên, không trả lời trực tiếp khách về liều dùng; câu trả lời luôn kèm đoạn nguồn và dược sĩ chịu trách nhiệm cuối cùng. Bài học từ các phiên hỏi đáp chỉ vào bộ nhớ lâu dài sau khi trưởng chuyên môn duyệt, khớp với cách README mô tả việc chưng cất những bài học đã được chấp nhận [1]. Chế độ đa người dùng phải bật để cô lập dữ liệu theo người dùng và dataset [4]; nếu dùng LLM qua API, nội dung tài liệu sẽ tới nhà cung cấp mô hình [1], cần đánh giá theo quy định hiện hành về dữ liệu y tế và dữ liệu cá nhân.
Cần chuẩn bị gì để chạy Cognee ngoài máy cá nhân?
Cài đặt cần Python 3.10 đến 3.14 và gói cognee kèm tùy chọn gliner; mô hình trích xuất và embedding được tải về ở lần dùng đầu [1]. Image Docker đã kèm runtime GLiNER; khi chạy từ mã nguồn với các profile ui và mcp, API, UI và MCP lần lượt ở cổng 8000, 3000, 8001 [1].
Dữ liệu phải được gắn volume: tùy chọn --rm xóa dữ liệu trong container khi thoát [1]. Đường lưu trữ chuẩn là /cognee-storage thuộc người dùng không phải root có uid 1000; volume mới gắn ở đường khác sẽ thuộc root và phải cấp quyền ghi [4]. Các ví dụ đều dùng image tag main [4][5], nên môi trường thật cần ghim một phiên bản cụ thể.
Helm chart đòi Kubernetes 1.25 trở lên, khuyên tạo Secret ngoài Helm cho LLM_API_KEY và mật khẩu cơ sở dữ liệu, và tự khởi động lại cuốn chiếu khi Secret được xoay vòng [5].
Tài liệu Helm còn có hai cảnh báo đáng giá: chưa nên chạy quá một replica vì mã còn bộ đệm LRU, khóa asyncio cục bộ tiến trình và giả định một worker; liveness probe tắt mặc định vì /health kiểm cả cơ sở dữ liệu, vector store, graph store và hệ thống tệp, dễ gây vòng khởi động lại khi phụ thuộc chập chờn [5].
Đâu là các điểm rủi ro về quyền truy cập và dữ liệu?
Mặc định API chạy chế độ đa người dùng: mọi lời gọi /api/v1 cần người dùng đã xác thực và dữ liệu được cô lập theo người dùng, dataset [1][4]. Thế nhưng các ví dụ thử nhanh đặt ENABLE_BACKEND_ACCESS_CONTROL=false, tức một người dùng chung cơ sở dữ liệu cục bộ [4], và giá trị mặc định của khóa tương ứng trong Helm chart cũng là false [5]. Triển khai thật phải bật lại và rà các biến bảo mật trong .env.template trước khi mở API [4].
Tài liệu recall nêu một quyết định thiết kế đáng học: kiểu CYPHER không bao giờ được định tuyến tự động, vì đường recall chỉ kiểm quyền đọc, nên nếu được định tuyến thì ai đọc được dataset cũng có thể xóa nó bằng một câu Cypher [3]. Ứng dụng vì thế không nên chuyển nguyên lựa chọn searchType của người dùng cuối tới API, và nên coi quyền gọi CYPHER như quyền ghi. Bộ định tuyến chỉ ghi tên quy tắc vào log, không ghi nội dung câu hỏi [3].
Helm chart đặt sẵn vài mặc định an toàn: chặn leo thang đặc quyền, bỏ mọi Linux capability, không gắn token của service account [5]. Skill companion nhắc các nguyên tắc nên áp chung: ghi chú là dữ liệu riêng tư, không trích quá mức cần, không in tệp .env [6]. Lỗ hổng được báo qua email riêng với chữ SECURITY ở tiêu đề [7].
Apache 2.0 bao trùm những gì, và phần nào cần giấy phép thương mại?
LICENSE ở gốc kho là Apache License 2.0, phụ lục ghi bản quyền thuộc Topoteretes UG năm 2024 [8]. NOTICE.md ghi bản quyền Topoteretes UG và chừa một khung chú thích để liệt kê mã lấy từ nguồn ngoài, nhưng tại commit này khung đó chưa có mục nào [9]. Thư mục licenses/ được mô tả là nơi chứa giấy phép của phần mềm bên thứ ba được phân phối lại trong dự án [10].
Khi phân phối lại, Apache 2.0 buộc bên phân phối gửi kèm văn bản giấy phép, ghi chú rõ các tệp đã thay đổi và mang theo nội dung của tệp NOTICE, đồng thời không trao quyền dùng thương hiệu theo điều 6 [8]. Doanh nghiệp đóng gói Cognee vào sản phẩm riêng nên giữ cả NOTICE.md lẫn thư mục licenses/.
Phạm vi của giấy phép dừng ở mã nguồn tại commit khảo sát. Nó không bao gồm Cognee Cloud, bản GLiNER production hay bản graph store trên Postgres dành cho production mà README mô tả là sản phẩm thương mại hoặc phải liên hệ [1]; cũng không bao gồm mô hình của OpenAI, các kho tích hợp tách riêng như cognee-integrations, cognee-community, hay dữ liệu người dùng.
Chạy không cần API key có nghĩa là miễn phí?
Không hẳn. Chế độ không khóa API bỏ được chi phí gọi mô hình khi nạp và truy xuất văn bản, nhưng chuyển gánh nặng sang CPU, bộ nhớ và thời gian xử lý; README chỉ nói mô hình nhỏ chạy trên CPU, không công bố cấu hình phần cứng [1]. Khi bật LLM, cognify phát sinh lời gọi cho trích xuất và tóm tắt đoạn [2], còn câu trả lời sinh thêm lời gọi ở bước recall [3].
Helm chart cho một mốc tham khảo về loại tài nguyên: container Cognee yêu cầu 500m CPU, 512Mi bộ nhớ, giới hạn 4 CPU và 2Gi; Postgres đi kèm có ổ 2Gi [5]. Đây là giá trị mặc định của chart, không phải khuyến nghị dung lượng cho dữ liệu thật.
Nguồn lực con người thường chiếm phần lớn: người thiết kế mô hình dữ liệu và ontology, kỹ sư vận hành Postgres hoặc Kubernetes, chuyên gia nghiệp vụ chấm chất lượng quan hệ. Bài không ước tính giá; nên đo thời gian cognify trên một mẫu tài liệu đại diện rồi mới ngoại suy.
Nên so Cognee với những hướng tiếp cận nào?
So với RAG vector thuần, tự dựng bằng LangChain, LlamaIndex hay dùng nền tảng có sẵn, Cognee thêm lớp đồ thị và bộ nhớ phiên; cái giá là thêm bước trích xuất và thêm kho dữ liệu phải giữ nhất quán.
So với các hướng GraphRAG khác như Microsoft GraphRAG hay LightRAG, khác biệt nằm ở phạm vi: Cognee tự đặt mình là lớp nhớ cho agent, có phiên, phản hồi và đồ thị mã, chứ không chỉ là kỹ thuật truy xuất [1]. Với các lớp nhớ như Mem0, Letta hay Zep, Cognee hỗ trợ nhập dữ liệu từ chính các hệ đó qua COGX [1], cho thấy nhà phát triển coi chúng là lựa chọn thay thế trực tiếp.
Tiêu chí chọn nên cụ thể: câu hỏi có cần nối quan hệ không, có buộc chạy hoàn toàn cục bộ không, đội ngũ vận hành nổi nhiều kho dữ liệu không, và trên cùng bộ câu hỏi tiếng Việt thì phương án nào đúng hơn. Bài không nhận định chất lượng các dự án khác vì không có nguồn kiểm chứng trong phạm vi nghiên cứu.
Khi nào chưa nên dùng Cognee?
Khi cần nhiều bản sao để chịu tải, vì tài liệu Helm nói rõ mở rộng quá một replica phải được kiểm chứng trước [5]. Khi cần đồ thị trên Postgres cho production mà không muốn mua giấy phép, vì bản mở mới ở mức demo [1].
Khi chất lượng tiếng Việt chưa được đo: GLiNER đi kèm được gọi là demo [1], tài liệu không nhắc tới tiếng Việt, và bộ định tuyến recall dựa vào cụm từ tiếng Anh [3]. Dự án cũng thay đổi nhanh; README ghi một thay đổi phá vỡ tương thích khi dlt trở thành phụ thuộc lõi [1], nên cần ghim phiên bản và đọc ghi chú phát hành trước mỗi lần nâng cấp.
Cuối cùng, điểm BEAM do nhà phát triển báo cáo với cấu hình riêng cho benchmark [1]; không nên dùng chúng để dự báo chất lượng trên tài liệu dược hay hợp đồng của doanh nghiệp.
Thử nghiệm thế nào để biết đồ thị có thật sự giúp ích?
Giai đoạn một, hai tuần: chọn một vùng với vài trăm tài liệu và trích danh mục sản phẩm; dược sĩ soạn 120 câu hỏi tiếng Việt chia ba nhóm là tra một tài liệu, nối nhiều tài liệu và có mốc thời gian, mỗi câu kèm đáp án và nguồn. Số lượng tài liệu và câu hỏi ở đây là giả định để lập kế hoạch.
Giai đoạn hai, hai tuần: chạy ba cấu hình trên cùng bộ câu hỏi là tìm đoạn văn thuần, Cognee không LLM trả CHUNKS, và Cognee có LLM với HYBRID_COMPLETION. Đo tỷ lệ câu có nguồn đúng, tỷ lệ câu sai mà vẫn tự tin, thời gian cognify cho mỗi trăm tài liệu và số quan hệ sai trong một mẫu đồ thị do chuyên gia rà.
Giai đoạn ba, bốn tuần: một nhóm dược sĩ dùng thật với chế độ đa người dùng bật, phản hồi được đưa vào qua improve. Dừng nếu nhóm câu nối nhiều tài liệu không vượt phương án đoạn văn thuần, nếu phát hiện truy cập chéo dataset, hoặc nếu một câu trả lời sai về liều dùng lọt qua mà không bị chặn. Quyết định mở rộng thuộc về trưởng chuyên môn, dựa trên các ngưỡng đã ký trước khi thử.
Đọng lại gì sau khi đối chiếu tài liệu Cognee?
Cognee là bộ khung bộ nhớ thiên về đồ thị, có pipeline minh bạch, bộ định tuyến truy vấn được thiết kế thận trọng và lựa chọn chạy cục bộ không cần khóa API [1][2][3].
Phần mở theo Apache 2.0 đủ cho một thử nghiệm nghiêm túc [8], còn những mảnh để chạy production trên Postgres hay trích xuất chính xác hơn nằm ở phía thương mại [1].
Với doanh nghiệp Việt Nam, câu hỏi then chốt không phải đồ thị có hấp dẫn hay không, mà là nó có trả lời đúng hơn câu hỏi tiếng Việt của nhân viên hay không; chỉ thử nghiệm có đối chứng mới trả lời được.
Bài nghiên cứu dựa trên nguồn nào và giới hạn ở đâu?
Cognee lọt vào danh sách đề tài nhờ bản lưu GitHub Trending mục Python ngày 24/01/2026, nơi dự án đứng thứ bảy với khẩu hiệu “Memory for AI Agents in 6 lines of code” [12]; đến nay README giới thiệu nó là nền tảng bộ nhớ AI cho agent [1]. Bản lưu ấy chỉ gồm bốn ngôn ngữ Python, Go, JavaScript và Swift, lại thiếu hai ngày 03/09 và 12/10, nên việc chọn bài mang tính biên tập, không dựa trên một Top 100 chính thức nào của GitHub.
Mọi đối chiếu bám vào commit 0ec7a9fa61c9ff04bf7e02e0d57af363a993a5e1, tạo ngày 08/10/2026 và được kiểm lại ngày 12/10/2026. Tệp đã đọc gồm README, LICENSE, SECURITY.md, hướng dẫn Helm, skill companion [1][5][6][7][8], cộng thêm chỉ mục task, trang so sánh recall với search, hướng dẫn Docker Compose tối giản, NOTICE.md và licenses/README.md [2][3][4][9][10]. Riêng architecture_guide.md trong bộ tệp ghim hóa ra là dữ liệu mẫu mô tả một “Acme sync engine” hư cấu, nên không được dùng làm căn cứ về kiến trúc Cognee [11].
Phương pháp là đọc và đối chiếu tài liệu với AI trợ giúp; bài không phải công trình khoa học đã được bình duyệt, và Cognee chưa hề được cài hay chạy trong quá trình viết. Kịch bản nhà thuốc, phần chi phí và kế hoạch thử là đề xuất mang tính giả định.
Xem mã nguồn Cognee trên GitHub