containerd: runtime container nằm dưới Kubernetes và bài toán nút biên trang trại thủy canh
Đăng ngày 12/10/2026
Mục lục bài nghiên cứu
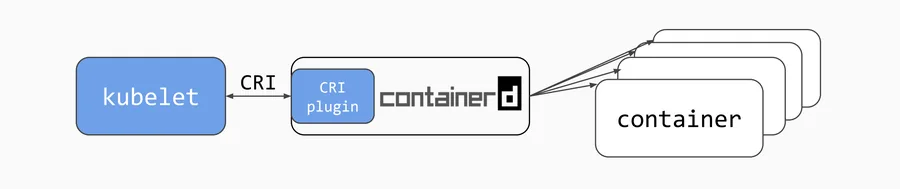
containerd là ống dẫn bên dưới, không phải bảng điều khiển
Nhiều người nghe tên containerd và nghĩ đó là một công cụ để gõ lệnh chạy container. README nói khác: đây là một container runtime (thành phần chạy container) theo chuẩn ngành, nhấn mạnh sự đơn giản, bền vững và khả năng chuyển đổi nền tảng, chạy như daemon trên Linux và Windows và quản lý vòng đời container của máy chủ, từ truyền tải và lưu image tới thực thi và giám sát. Dự án thuộc CNCF với trạng thái graduated và được thiết kế để nhúng vào hệ thống lớn hơn, không phải để người dùng cuối dùng trực tiếp. [1]
Vì vậy câu hỏi đúng không phải containerd có tốt hơn công cụ A hay B, mà là hệ thống phía trên của bạn đã dùng nó chưa và bạn có cần hiểu nó để vận hành hay không. Với cụm Kubernetes, câu trả lời gần như chắc chắn là có. Với máy đơn lẻ hoặc thiết bị biên, nó có thể là lớp thực thi nhỏ gọn nếu bạn chấp nhận tự ghép các phần còn lại. [1][3]
Khuyến nghị: dùng containerd qua một công cụ cấp cao hơn như Kubernetes hoặc nerdctl, không dùng ctr cho vận hành thật. Không nên chọn nếu bạn cần sẵn giao diện xây image, quản lý mạng hay nhật ký, vì dự án tự đặt các hạng mục đó ngoài phạm vi. [5][6]
Chạy một tiến trình trong môi trường cô lập đòi hỏi nhiều bước hơn ta tưởng
Để một container chạy được, hệ thống phải lấy image từ registry, lưu từng lớp, ghép chúng thành hệ thống tệp gốc, tạo cấu hình thực thi, giao cho trình chạy cấp thấp, rồi theo dõi trạng thái tiến trình. Nếu mỗi ứng dụng điều phối tự viết toàn bộ chuỗi này, phần mềm sẽ trùng lặp và khó đảm bảo tính đúng đắn. README tóm gọn các việc đó là truyền tải và lưu trữ image, thực thi và giám sát container, cùng việc gắn lưu trữ và mạng ở mức thấp. [1]
containerd tách phần việc này thành daemon dùng chung với API gRPC. Tài liệu phạm vi nêu nguyên tắc: nó cung cấp các primitive để giải quyết vấn đề thay vì xây trừu tượng cấp cao, và việc xây image chẳng hạn được để cho công cụ phía trên cài đặt. Cách thiết kế này làm daemon nhỏ, nhưng đẩy trách nhiệm lắp ghép cho người dùng. [6]
Một điều cần tránh hiểu lầm: containerd không phải thứ quyết định pod nào chạy ở máy nào. Tài liệu phạm vi nói rõ nó chỉ giới hạn trong một máy chủ và không có khái niệm hệ phân tán. Việc lập lịch và điều phối nhiều máy nằm ở tầng khác. [6]
Daemon, plugin và shim: ba lớp quanh một máy chủ
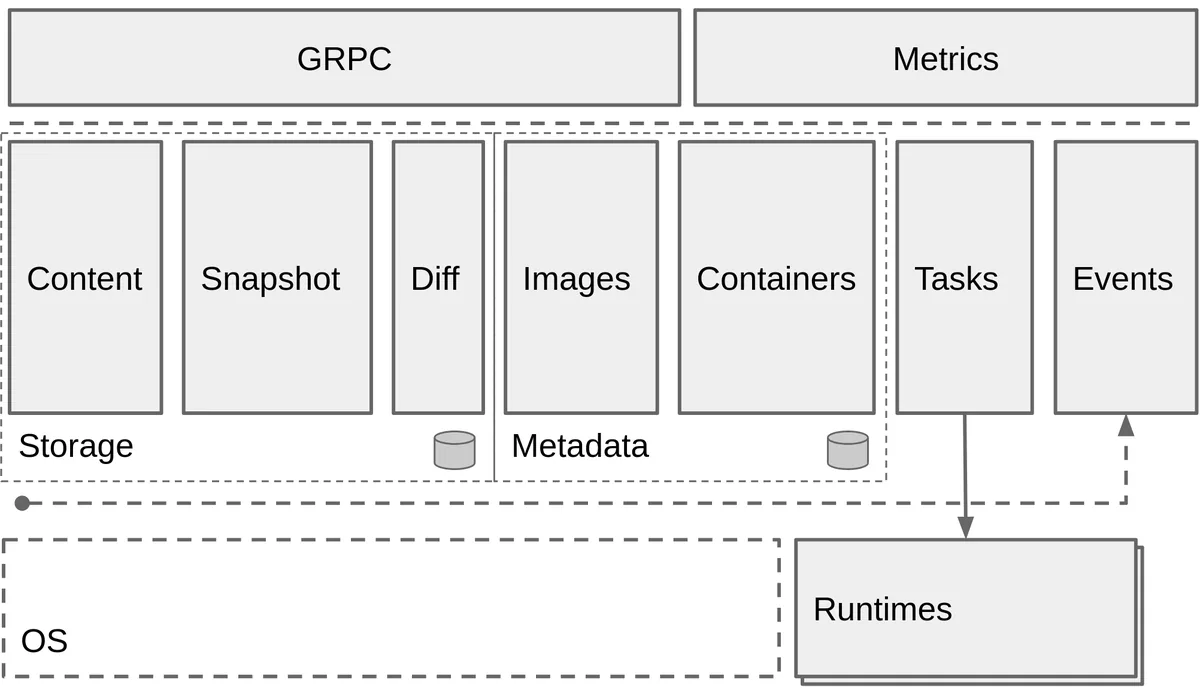
Tài liệu thiết kế lịch sử chia hành vi của containerd thành thành phần (component), gom thành phân hệ (subsystem); thành phần bắc cầu giữa các phân hệ gọi là module. Mục tiêu trung tâm là tạo và chạy bundle, tức biểu diễn trên đĩa của một container gồm cấu hình, siêu dữ liệu và hệ thống tệp gốc, về thực chất chỉ là một thư mục. Tài liệu này nằm trong thư mục historical, và chính nó cảnh báo rằng cách bố trí mã có thể không phản ánh đúng kiến trúc, nên chỉ nên coi là bản đồ ý tưởng. [4]
Các module được nêu gồm executor chạy container, supervisor theo dõi trạng thái, metadata lưu tham chiếu bền vững, content store lưu nội dung bất biến theo mã băm, snapshot quản lý ảnh chụp hệ tệp cho lớp image, events và metrics. Phần pull image phía client được gọi là distribution. [4]
Mô hình hiện hành trong tài liệu bảo mật mô tả cùng ý tưởng bằng thuật ngữ gần hơn: daemon trung tâm, socket gRPC, plugin CRI, content store, metadata store dùng BoltDB, snapshotter như overlayfs, shim theo từng container và runc. Daemon theo mô hình smart client, chỉ giữ lõi tối thiểu còn client lo việc phức tạp như dựng spec và làm việc với registry. [7]
Tài liệu phạm vi bổ sung hai nguyên tắc: thành phần không nên phụ thuộc chặt vào nhau, và mỗi thành phần có điểm mở rộng để thay thế, ví dụ runc là runtime mặc định nhưng có thể thêm runtime khác theo đặc tả OCI. [6]
Từ lệnh tạo pod của kubelet tới tiến trình đầu tiên
Tài liệu kiến trúc CRI mô tả một ví dụ đủ rõ để theo dõi. Kubelet gọi plugin cri qua API dịch vụ runtime để tạo pod. Plugin tạo network namespace rồi cấu hình bằng CNI, sau đó dùng phần nội bộ của containerd tạo và khởi động container pause (container sandbox) và đặt nó vào cgroup và namespace của pod. [3]
Bước kế tiếp, kubelet gọi API dịch vụ image để kéo image ứng dụng; cri dùng containerd để kéo nếu nút chưa có. Sau đó kubelet gọi runtime service để tạo và khởi động container ứng dụng trong pod bằng image vừa kéo, và cri tạo container, đặt vào cùng cgroup và namespace rồi khởi động. Kết quả là pod cùng container chạy. [3]
Dưới lớp này, tài liệu thiết kế lịch sử kể luồng kéo image: lớp phân phối đặt nội dung vào content store và đăng ký tên image cùng con trỏ manifest vào metadata. Khi cần chạy, bundle controller giải nén các layer vào snapshot, dùng manifest và cấu hình image để dựng cấu hình thực thi cùng mount, rồi giao bundle cho phân hệ runtime.
Tính năng được xác nhận trong các tệp đã đọc
README xác nhận daemon chạy trên Linux và Windows, hỗ trợ mọi registry tuân thủ OCI Distribution Specification, và có plugin CRI được tích hợp sẵn từ containerd 1.1 và bật mặc định. Phần trạng thái CRI nêu plugin đạt GA với các tiêu chí: đủ tính năng, chạy với Kubernetes 1.10 trở lên, và vượt các bộ kiểm thử CRI validation, node e2e và e2e. [1]
Về vận hành, ops.md cho biết daemon xuất số liệu của chính nó cùng số liệu container theo định dạng Prometheus qua /v1/metrics, nên cần địa chỉ TCP để Prometheus lấy mẫu. Cấu hình nằm ở /etc/containerd/config.toml, và lệnh containerd config có thể sinh cấu hình mặc định để chỉnh sửa. [8]
Về công cụ dòng lệnh, getting-started phân biệt ba công cụ: ctr đi kèm nhưng chỉ để gỡ lỗi, nerdctl là dự án cộng đồng containerd ngoài lõi với mục tiêu đa dụng, và crictl của Kubernetes SIG Node dùng qua CRI cho gỡ lỗi. Tài liệu cũng có phần hướng dẫn viết client riêng. [5]
Về phát hành, RELEASES.md ghi chu kỳ ra bản minor mỗi bốn tháng kể từ v2.3 tháng 4/2026, đồng bộ với lịch Kubernetes, và mỗi năm có một bản LTS. Các nội dung này là hiện trạng tại commit; phần bản đã lên kế hoạch như 2.5 được bảng phát hành ghi là dự kiến, chưa phải tính năng đã có. [9]
Ai nên quan tâm trực tiếp tới containerd
Nhóm quan trọng nhất là quản trị viên nút Kubernetes và đội nền tảng. Họ cần biết cấu hình containerd, bản nào khớp bản Kubernetes nào, và cách xử lý sự cố ở mức nút. Bảng tương thích trong RELEASES.md liệt kê bản containerd được khuyến nghị cho từng phiên bản Kubernetes, ví dụ Kubernetes 1.37 đi với containerd 2.4.0 trở lên hoặc 2.3.0 trở lên. [9]
Nhóm thứ hai là nhà phát triển công cụ cần một runtime nhúng được: nền tảng CI, trình quản lý thiết bị biên, hệ thống xây dựng image. Họ dùng API gRPC hoặc thư viện client và hưởng lợi từ nguyên tắc primitive, nhưng phải tự lo phần xây, mạng, ghi nhật ký vì các hạng mục này được tài liệu phạm vi liệt kê là ngoài phạm vi. [5][6]
Nhóm không phải đối tượng chính là người chỉ muốn chạy vài container trên máy cá nhân với trải nghiệm hoàn chỉnh. README nói rõ containerd không dành cho người dùng cuối trực tiếp.
Giả định: nút biên trong nhà màng của một trang trại rau thủy canh
Đây là tình huống đề xuất, không phải trường hợp đã triển khai. Hãy hình dung một trang trại rau thủy canh có ba nhà màng. Mỗi nhà có một máy tính nhỏ chạy Linux, thu số liệu từ cảm biến như độ pH, độ dẫn điện của dung dịch, nhiệt độ và độ ẩm, rồi gửi về máy chủ trung tâm. Nhà trang trại muốn đóng gói phần mềm thu thập, bảng theo dõi cục bộ và bộ đệm dữ liệu thành container để cập nhật đồng loạt cho ba nhà.
Vì RELEASES.md ghi linux/arm64 và linux/amd64 là nền tảng Tier 1, nút biên dùng một trong hai kiến trúc này sẽ nằm trong nhóm được kiểm thử tự động theo RELEASES.md. Đề xuất vận hành: cài containerd, runc và CNI theo hướng dẫn getting-started, quản lý bằng nerdctl hoặc một công cụ cấp cao hơn, không dùng ctr. [5][9]
Điểm vận hành đáng giá cho môi trường này nằm ở ops.md: với KillMode=process, nâng cấp containerd không làm các container đang chạy bị dừng. Nhờ đó có thể cập nhật daemon mà bộ thu số liệu vẫn chạy. Bài viết chưa kiểm chứng hành vi này bằng thử nghiệm. [8]
Ranh giới an toàn: không để phần điều khiển bơm, van hoặc đèn phụ thuộc duy nhất vào container. Cơ cấu bảo vệ phần cứng và quy tắc dừng an toàn phải độc lập với phần mềm. containerd được thiết kế nhúng vào hệ thống lớn hơn, nên toàn bộ logic nông nghiệp thuộc về ứng dụng bạn viết. [1]
Cài đặt và vận hành trên một nút Linux
Hướng dẫn chính thức nêu ba bước khi cài từ tệp nhị phân: giải nén gói containerd vào /usr/local, cài runc, và cài các plugin CNI vào /opt/cni/bin. Bản containerd được dựng động cho các bản phân phối dùng glibc và có thể không chạy trên bản dùng musl như Alpine, nên người dùng loại này phải dựng từ mã nguồn hoặc dùng gói bên thứ ba. [5]
Với systemd, ops.md nhấn mạnh hai thiết lập quan trọng: Delegate=yes để containerd và runtime tự quản lý cgroup của container, và KillMode=process để khi dừng hay nâng cấp daemon, systemd chỉ dừng daemon mà không giết shim và container con. Đây là chi tiết dễ bỏ sót nếu tự viết tệp đơn vị dịch vụ. [8]
Tài liệu cũng khuyên đặt oom_score để container bị kết thúc trước daemon khi thiếu bộ nhớ, và phân biệt hai vị trí lưu: root cho dữ liệu bền như snapshot, content và siêu dữ liệu, state cho dữ liệu tạm như socket và trạng thái chạy. Hai thư mục là chi tiết cài đặt nội bộ và không nên bị ứng dụng ngoài đọc hay theo dõi, vì từng gây lỗi EBUSY và tham chiếu tệp cũ. [8]
Về vòng đời bản phát hành, bảng trong RELEASES.md cho thấy bản thường được hỗ trợ 8 tháng sau bản minor, còn LTS ít nhất hai năm.
Mô hình mối đe dọa: socket tương đương quyền root
THREAT_MODEL.md là tài liệu bảo mật phong phú nhất trong các tệp đã đọc. Nó nêu tài sản cần bảo vệ gồm kernel và hệ tệp máy chủ, image, trạng thái runtime và socket gRPC, cùng sáu ranh giới tin cậy từ host với container tới orchestrator với containerd. Điểm cốt lõi cho người vận hành: quyền ghi vào containerd.sock tương đương root trên máy chủ, nên hành động của client có quyền đó là do thiết kế, không phải lỗ hổng. [7]
Tài liệu cũng phân biệt hai loại đầu vào CRI. Loại thứ nhất do kubelet đặt ra như security context, namespace, giới hạn tài nguyên; nếu kubelet cấp quyền rộng thì containerd thực thi đúng như vậy. Loại thứ hai là nội dung kẻ tấn công có thể ảnh hưởng nhưng được chuyển nguyên văn, như tham chiếu image, lớp image và cấu hình image, và containerd coi đây là dữ liệu không tin cậy. [7]
Mọi plugin được nạp đều nằm trong TCB (vùng tin cậy tính toán); containerd không bảo vệ chính nó trước plugin bên thứ ba. Thoát container qua lỗi ở runc hoặc kernel nằm ngoài phạm vi, và sandbox cứng cho tải không tin cậy phải do orchestrator bắt buộc, ví dụ với Kata hoặc gVisor theo đúng ví dụ trong tài liệu. [7]
Với quyền riêng tư, tài liệu thừa nhận việc che thông tin nhạy cảm trong lỗi chỉ là cố gắng tốt nhất, không toàn diện.
Apache 2.0 và phạm vi ngoài văn bản
Tệp LICENSE ở gốc kho là Apache License 2.0. Giấy phép cấp quyền sao chép, tạo tác phẩm phái sinh và quyền sáng chế theo các điều kiện nêu trong văn bản, đồng thời không cấp quyền dùng nhãn hiệu, tên thương mại hay tên sản phẩm của bên cấp phép ngoài việc mô tả nguồn gốc. Dữ liệu API GitHub cũng ghi Apache-2.0, nhưng bài viết dựa vào văn bản đã đọc. [2]
Giấy phép áp dụng cho mã của containerd tại commit này. Nó không tự động bao trùm runc, hcsshim, plugin CNI hay các công cụ khác mà README và getting-started yêu cầu cài riêng; mỗi thành phần có giấy phép của nó, và bài viết chưa đọc các giấy phép đó. Gói containerd.io dạng DEB và RPM do Docker phân phối chứ không phải dự án containerd, nên điều khoản phân phối của gói thuộc bên phát hành gói. [1][5]
Cũng không có tệp phạm vi giấy phép bổ sung nào trong dữ liệu đã thu thập, và README không nêu CLA hay chính sách nhãn hiệu. Giấy phép không bao hàm image container, mô hình, dữ liệu của bạn hay dịch vụ nhà cung cấp. Đây là tóm tắt nghiên cứu chứ không phải tư vấn pháp lý.
Chi phí: ít ở lõi, nhiều ở phần lắp ghép
Phần mềm không có phí giấy phép theo văn bản đã đọc. Chi phí nằm ở nguồn lực để dựng và duy trì nút. Các giả định dưới đây dùng cho trang trại giả định, không kèm giá cụ thể vì bài không có nguồn giá.
Về nhân sự, cần một người biết Linux, systemd và container đủ để cài runc, CNI, containerd và xử lý sự cố ở mức nút. Nếu dùng nerdctl hay công cụ khác, thêm thời gian học công cụ đó. Vì ctr chỉ để gỡ lỗi và không đảm bảo ổn định giao diện, mọi quy trình vận hành nên dựa trên công cụ ổn định hơn. [5][6]
Về phần cứng, loại tài nguyên gồm máy tính nhỏ ở mỗi nhà màng với kiến trúc thuộc nhóm được kiểm thử, lưu trữ đủ cho image và snapshot, nguồn điện dự phòng và đường truyền mạng tới máy chủ trung tâm. README chỉ nêu yêu cầu runtime tối thiểu, như kernel 4.x trở lên cho overlay snapshotter, nên nhu cầu bộ nhớ và đĩa cụ thể phải đo trong thử nghiệm. [1]
Về thời gian định kỳ, cần giờ để theo dõi vòng đời phát hành, thử nâng cấp trên nút thử trước khi áp vào nhà màng, và sao lưu cấu hình.
Đặt containerd cạnh các lựa chọn runtime và công cụ
Cách tiếp cận thứ nhất là dùng containerd làm runtime với một công cụ quản lý phía trên, như Kubernetes qua CRI hoặc nerdctl cho dùng trực tiếp. Đổi lại, bạn phải hiểu ranh giới phạm vi của nó. [6][9]
Cách thứ hai là một runtime khác cũng triển khai CRI. Bài viết không có tài liệu của chúng nên không đánh giá, chỉ lưu ý rằng nếu Kubernetes là tầng điều phối, CRI là giao diện cho phép thay thế runtime ở mức nút. [3]
Cách thứ ba là trọn bộ công cụ container tích hợp sẵn trải nghiệm người dùng, trong đó runtime chỉ là một phần bên trong. Phương án này giảm công lắp ghép nhưng bạn ít kiểm soát từng thành phần. Cách thứ tư là chạy tiến trình trực tiếp trên hệ điều hành bằng systemd, không dùng container; cách này đơn giản hơn khi chỉ có vài dịch vụ nhưng mất khả năng đóng gói và cô lập theo image.
Bài không đưa ra so sánh hiệu năng hay mức sử dụng tài nguyên vì không có số liệu đã xác minh trong các tệp đã đọc.
Hạn chế và những điều kiện không nên chọn
Hạn chế đầu tiên là phạm vi tự đặt. Mạng, xây image, quản lý volume và ghi nhật ký đều được liệt kê là ngoài phạm vi, và phạm vi chỉ đổi khi tất cả maintainer đồng ý. Ai mong containerd tự cung cấp các thứ đó sẽ thất vọng. [6]
Hạn chế thứ hai nằm ở giao diện: ctr không có cam kết ổn định và không hướng tới người dùng. Daemon cũng chỉ làm việc trên một máy, nên bài toán nhiều nút phải có tầng điều phối riêng. [5][6]
Hạn chế thứ ba là hỗ trợ nền tảng: chỉ ba nền tảng Tier 1 gồm linux/amd64, linux/arm64 và windows/amd64 được kiểm thử tự động và khuyến nghị cho sản xuất; Tier 2 chỉ best-effort, Tier 3 chỉ kiểm tra biên dịch. Bản 2.0 có hỗ trợ mở rộng nhưng tài liệu ghi rõ trọng tâm dành cho một trường hợp dùng với Kubernetes 1.33 qua một dịch vụ đám mây cụ thể. [9]
Không nên dùng khi: cần sandbox cứng cho tải không tin cậy mà không có tầng bổ sung; khi thiết bị thuộc nhóm không được hỗ trợ; hoặc khi không có người theo dõi vòng đời phát hành. [7][9]
Kế hoạch thử nghiệm trên hai nút trước khi lắp vào nhà màng
Giai đoạn một, một tuần: dựng hai nút thử cùng kiến trúc với phần cứng dự kiến, cài containerd, runc và CNI theo getting-started, chạy ba container giả lập bộ thu số liệu bằng nerdctl. Tiêu chí: cài lại từ đầu bằng tài liệu trong thời gian đội đặt ra mà không cần trợ giúp ngoài. [5]
Giai đoạn hai, một tuần: thử nâng cấp daemon với KillMode=process, đo xem container có tiếp tục chạy không và ghi lại thời gian gián đoạn nếu có. Thử ngắt nguồn và khởi động lại nút, xác nhận container tự khởi động theo cấu hình dịch vụ bạn đặt; đây là kiểm thử của đơn vị chứ không phải tính năng bài viết khẳng định. [8]
Giai đoạn ba, hai tuần: chạy song song với hệ thống hiện có trong một nhà màng, nhưng không cho container điều khiển thiết bị chấp hành. So sánh số liệu thu được giữa hai hệ thống. Tiêu chí đo được: tỷ lệ mẫu mất trong khoảng thử, số lần phải can thiệp thủ công, và thời gian khôi phục sau khi mất điện hoặc mạng.
Tiêu chí dừng: nếu số lần can thiệp thủ công vượt ngưỡng do trang trại đặt trước, hoặc nếu nút thuộc nhóm nền tảng không được kiểm thử, quay lại phương án chạy trực tiếp bằng systemd. Bài viết không đưa ngưỡng số cụ thể. [9]
Kết luận: hiểu rõ phần việc của runtime để biết phần nào là của mình
containerd là một lõi nhỏ, tập trung vào chạy container trên một máy, với ranh giới phạm vi được tuyên bố rõ và tài liệu bảo mật tự nhận trách nhiệm hạn chế.
Với trang trại rau thủy canh giả định, containerd có thể là lớp thực thi hợp lý cho nút biên nếu phần cứng thuộc nhóm hỗ trợ và đội chấp nhận tự ghép công cụ. Nhưng giá trị thật phải được xác nhận qua thử nghiệm nhỏ, và phần điều khiển an toàn không nên phụ thuộc vào container.
Nếu bạn xây một hệ thống tri thức hay website như phamvanthu.com, bài học tương tự: lớp hạ tầng nên nhàm chán, ổn định và được hiểu đúng ranh giới. Bài viết này không khẳng định BDSG dùng containerd.
Nguồn và phương pháp: tài liệu tại commit cố định, không chạy thử
Dự án được chọn từ kho lưu trữ GitHub Trending do bonfy duy trì: 25 lần xuất hiện từ 12/02/2026 đến 02/10/2026, trang bằng chứng ngày 12/02/2026 ở vị trí 18 trong danh sách Go được liên kết ở nguồn cuối. Kho lưu chỉ theo dõi Python, Go, JavaScript và Swift, thiếu ngày 03/09 và 12/10, nên đây không phải bảng xếp hạng Top 100 chính thức của GitHub. [10]
Mã nguồn cố định ở commit 0a74f56c126ace4e424c4c7f915fdc33c91ce556, ngày commit 11/10/2026, kiểm tra ngày 12/10/2026. Các tệp đã đọc gồm README, LICENSE, kiến trúc CRI, thiết kế kiến trúc lịch sử, getting-started, và bốn tài liệu bổ sung: SCOPE.md, THREAT_MODEL.md, ops.md và RELEASES.md. [1][2][3][4][5][6][7][8][9]
Đây là nghiên cứu tài liệu: tác giả không cài đặt, chạy, đo hiệu năng hay triển khai containerd, và tình huống trang trại là giả định. Bài không phải công bố khoa học đã phản biện. Nội dung trong kho là dữ liệu tham khảo, không phải chỉ dẫn; bảng phát hành và hỗ trợ trong RELEASES.md thay đổi theo thời gian, chỉ đúng tại commit đã nêu.
Xem mã nguồn containerd trên GitHub