
Học máy cho người làm kinh doanh: chọn bài toán, kiểm dữ liệu và đọc kết quả mô hình
Đăng ngày 23/10/2026
Mục lục bài nghiên cứu
Tóm tắt và điều cần nhớ
Bài này giải thích học máy (machine learning, ML) bằng ngôn ngữ của người ra quyết định: máy học thế nào, cần dữ liệu gì, đo chất lượng ra sao, rủi ro ở đâu và nên thử thế nào ở doanh nghiệp Việt Nam. Không cần nền tảng toán hay lập trình.
- Học máy để hệ thống tự rút quy luật từ dữ liệu quá khứ thay vì chạy theo luật người viết; hợp với bài toán nhiều ví dụ, quy luật khó diễn đạt.
- Bốn kiểu học: có nhãn, không nhãn, bán giám sát, tăng cường; chọn kiểu nào tuỳ bạn đã có “đáp án” của quá khứ hay chưa.
- Dữ liệu đặt trần chất lượng; một con số độ chính xác cao chưa nói lên gì nếu chưa biết mỗi loại sai lầm tốn bao nhiêu tiền.
- Rủi ro nằm ở quá khớp, dữ liệu lệch, hộp đen, quyền riêng tư; từ 1/3/2026 Luật Trí tuệ nhân tạo chia hệ thống AI thành ba mức rủi ro [1]. Khởi đầu an toàn là một quyết định, một chỉ số, 2–4 tuần chạy song song quy trình cũ.
Vì sao người làm kinh doanh cần hiểu học máy
Phần lớn phần mềm doanh nghiệp chạy theo luật do người viết: đơn trên một mức tiền thì cần duyệt, khách quá hạn ba tháng thì khoá tài khoản. Giả sử một chuỗi có vài trăm cửa hàng, mỗi nơi bán vài nghìn mã hàng: mỗi ngày có hàng trăm nghìn cặp cần quyết định đặt hàng, và luật viết tay cho từng cặp sẽ chồng chéo, lỗi thời nhanh hơn tốc độ cập nhật.
Học máy đảo ngược cách làm: đưa vào các ví dụ kèm kết quả đã biết, để thuật toán tự tìm quy luật nối đầu vào với kết quả rồi áp cho trường hợp mới. Đổi lại, chất lượng phụ thuộc dữ liệu, mô hình có thể sai mà không báo, lý do của dự đoán không phải lúc nào cũng đọc được. Người quản lý không cần viết thuật toán nhưng cần làm tốt bốn việc: chọn bài toán, kiểm dữ liệu, đọc thước đo theo chi phí, dựng cơ chế giám sát.
AI, học máy, học sâu và các thuật ngữ cần thuộc
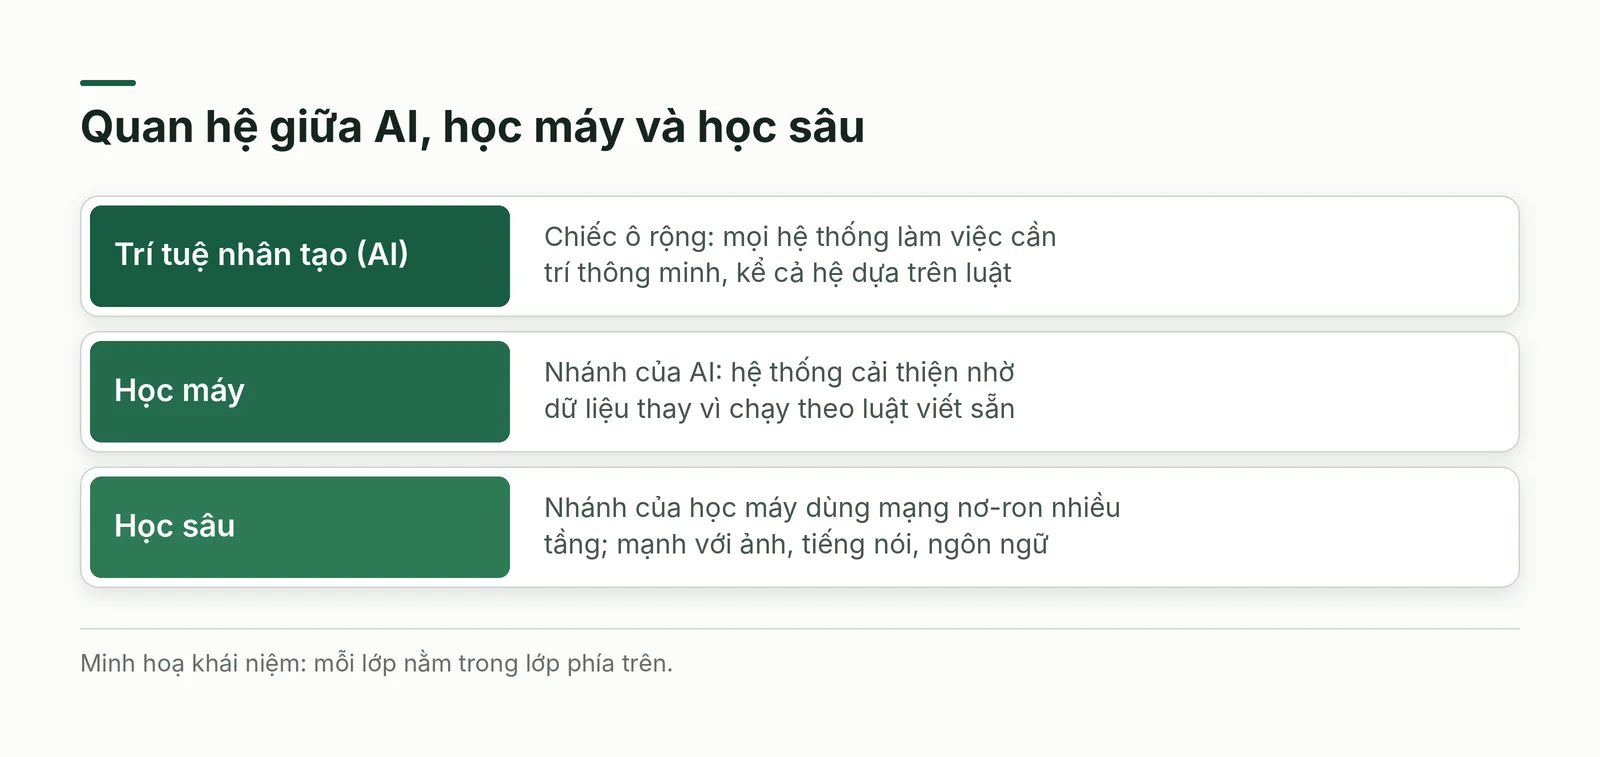
Trí tuệ nhân tạo (artificial intelligence, AI) là chiếc ô rộng cho mọi hệ thống làm việc cần trí thông minh, gồm hệ thống dựa trên luật (rule-based) chạy theo quy tắc cố định, hệ chuyên gia (expert system) mã hoá kinh nghiệm chuyên gia thành luật, xử lý ngôn ngữ tự nhiên (NLP) và robot. Học máy là nhánh của AI mà hệ thống cải thiện nhờ dữ liệu; học sâu (deep learning) là nhánh của học máy dùng mạng nơ-ron nhiều tầng.
Khác biệt cốt lõi là nơi “tri thức” nằm. Ở hệ thống dựa trên luật, tri thức nằm trong mã do người viết: dễ giải thích nhưng không tự thích nghi. Ở học máy, tri thức nằm trong tham số do dữ liệu quyết định: thích nghi được khi có dữ liệu mới nhưng khó giải thích và lệ thuộc chất lượng dữ liệu. Thực tế thường kết hợp: luật giữ ràng buộc pháp lý và an toàn, mô hình lo phần dự đoán.
Vài thuật ngữ lặp lại xuyên suốt: đặc trưng (feature) là mỗi cột thông tin đầu vào; nhãn (label) là đáp án đã biết; mô hình (model) là sản phẩm sau huấn luyện, nhận đặc trưng và trả dự đoán; siêu tham số (hyperparameter) là núm vặn do người đặt trước khi huấn luyện; khái quát hoá (generalization) là khả năng làm tốt trên dữ liệu chưa từng thấy, thứ doanh nghiệp thật sự trả tiền để có.
Bốn cách học của máy và câu hỏi kinh doanh tương ứng
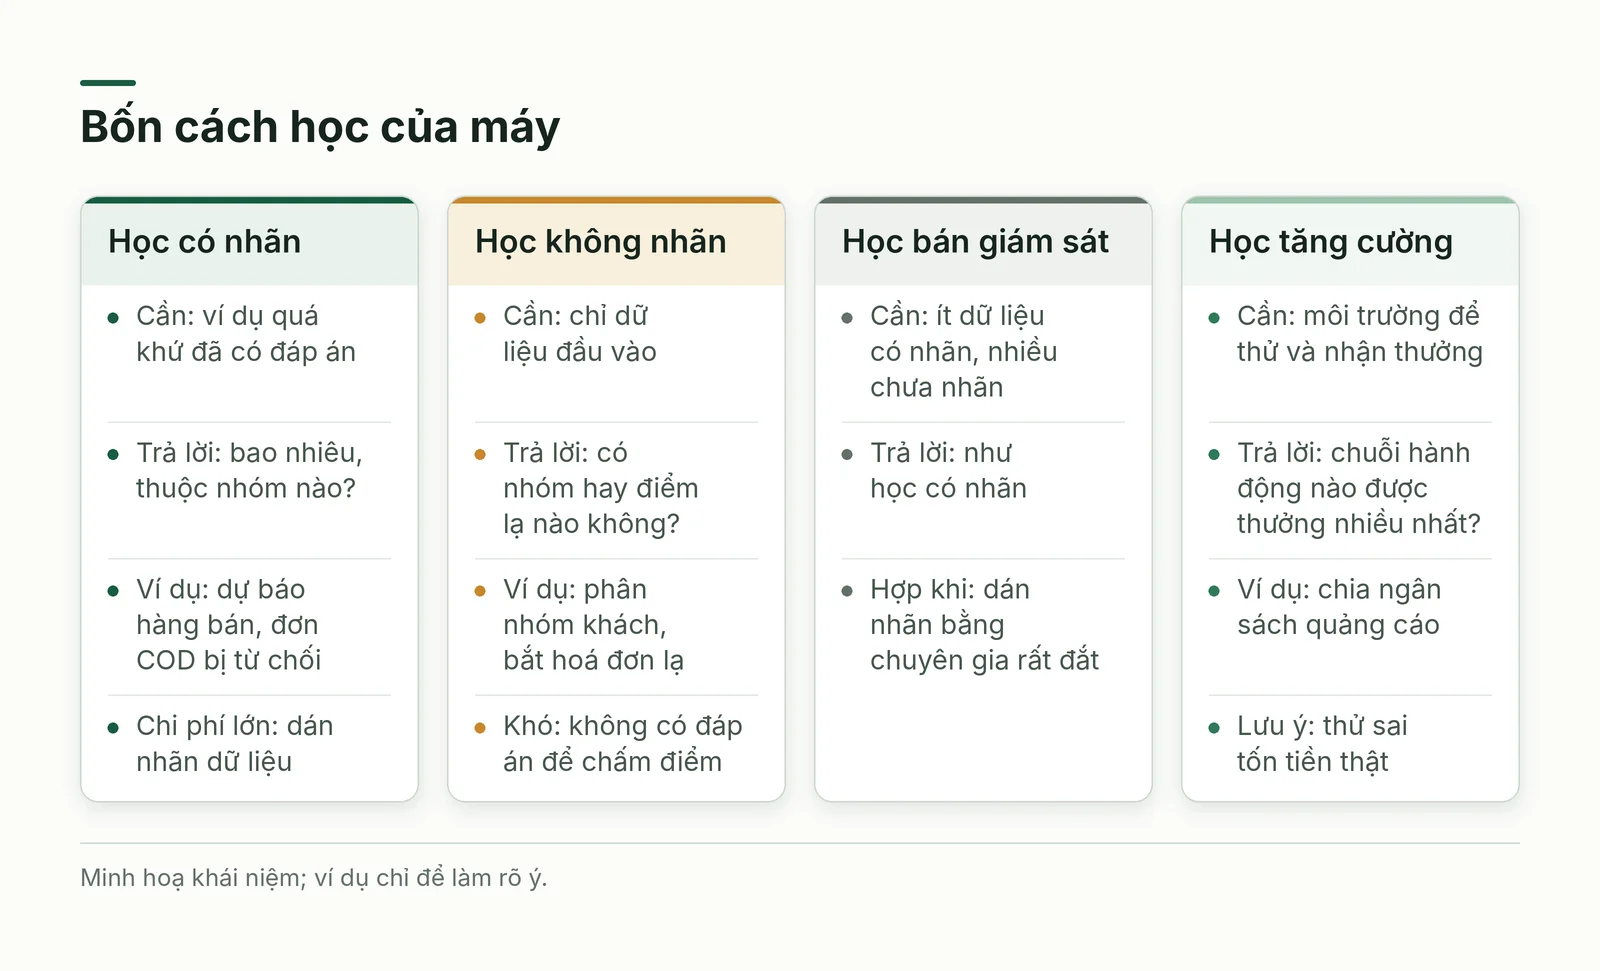
Học có nhãn (supervised learning) dùng ví dụ đã có đáp án để học phép nối từ đặc trưng sang nhãn. Đáp án là con số thì gọi là hồi quy (regression), như dự báo số ký rau củ mỗi cửa hàng bán ngày mai; đáp án là nhóm thì gọi là phân loại (classification), như đơn thu tiền khi giao (COD) sẽ được nhận hay bị từ chối. Điều kiện tiên quyết là đã lưu kết quả thật của quá khứ; nhiều nơi có dữ liệu giao dịch mà chưa ghi “đáp án”, và dán nhãn thường là khoản chi lớn nhất.
Học không nhãn (unsupervised learning) chỉ có đầu vào và để thuật toán tìm cấu trúc ẩn: phân nhóm khách hàng (clustering), phát hiện điểm bất thường (anomaly detection) như hoá đơn lạ, giảm số chiều (dimensionality reduction) để nén hàng trăm cột về vài nhân tố, học luật kết hợp để tìm món hay nằm chung giỏ. Không có đáp án để chấm nên người trong nghề phải xét các nhóm tìm được có nghĩa không. Học bán giám sát (semi-supervised) dùng ít dữ liệu có nhãn cộng nhiều dữ liệu chưa nhãn, hợp khi dán nhãn bằng chuyên gia rất đắt.
Học tăng cường (reinforcement learning) khác hẳn: không có bảng đáp án mà có tác nhân hành động trong môi trường và nhận thưởng hay phạt. Có thể chọn kiểu học bằng ba câu hỏi. Đã có đáp án của quá khứ thì học có nhãn. Chưa có mà muốn khám phá cấu trúc hay bất thường thì học không nhãn. Quyết định nối tiếp nhau, mỗi hành động đổi tình huống sau và có điểm phản hồi thì cân nhắc học tăng cường.
Dữ liệu quyết định trần chất lượng: dạng dữ liệu và cách chuẩn bị
Dữ liệu có cấu trúc nằm trong bảng hàng cột như đơn hàng, sổ quỹ; dễ dùng nhất và là nền của hầu hết dự án đầu tiên. Dữ liệu phi cấu trúc gồm văn bản, ảnh, âm thanh, giàu thông tin nhưng khó xử lý. Chuỗi thời gian hợp với dự báo; dữ liệu đồ thị mô tả quan hệ giữa các thực thể, như mạng lưới giao hàng; dữ liệu luồng đến liên tục từ cảm biến, nhật ký ứng dụng và cần xử lý ngay.
Bốn đặc điểm chất lượng hay gây rắc rối. Dữ liệu mất cân bằng (imbalanced) có một nhóm hiếm hơn nhiều, như đơn bị từ chối nhận; mô hình dễ “lười” đoán nhóm đông, nên cần lấy mẫu lại, đặt trọng số hoặc đổi thước đo. Dữ liệu nhiễu (noisy) lẫn lỗi và thông tin thừa. Dữ liệu thưa (sparse) phần lớn ô trống hoặc bằng không, thường gặp ở khuyến nghị sản phẩm. Dữ liệu nhiều chiều (high-dimensional) có hàng nghìn cột, như điểm ảnh, dễ dẫn đến quá khớp.
Dữ liệu lớn (big data) thường mô tả bằng ba chữ V: khối lượng, tốc độ, độ đa dạng. Nhiều dữ liệu giúp mô hình học tốt hơn nhưng không chữa được lệch: một triệu dòng của cùng một nhóm khách vẫn không nói gì về nhóm khác. Khi dữ liệu thật khó có, dữ liệu tổng hợp (synthetic) do máy sinh ra giúp thử mô hình nhưng không thay được dữ liệu thật.
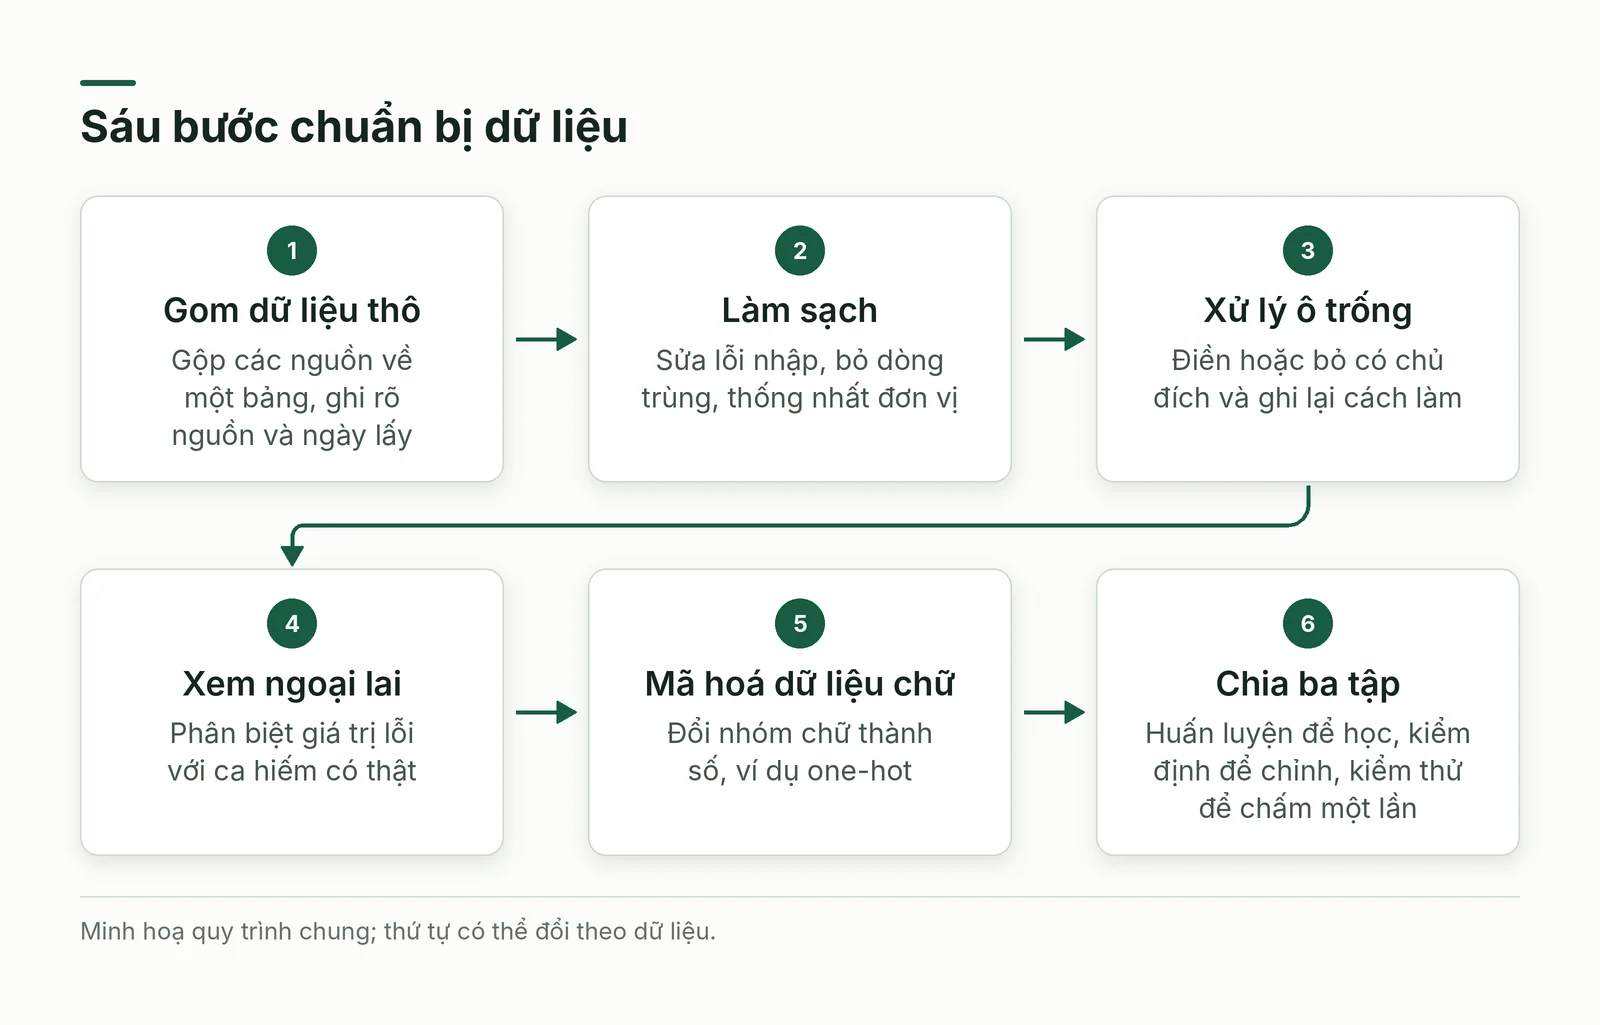
Quy trình chuẩn bị gồm sáu bước như hình dưới. Trước đó hãy vẽ biểu đồ phân bố từng cột để thấy ngoại lai, ô trống, nhóm bị thiếu: trực quan hoá là cách rẻ nhất để bắt lỗi dữ liệu. Dữ liệu chữ như tên tỉnh cần mã hoá thành số, phổ biến là one-hot: mỗi nhóm thành một cột nhận 0 hoặc 1.
Hộp công cụ thuật toán: mỗi loại giỏi việc gì và cách chọn
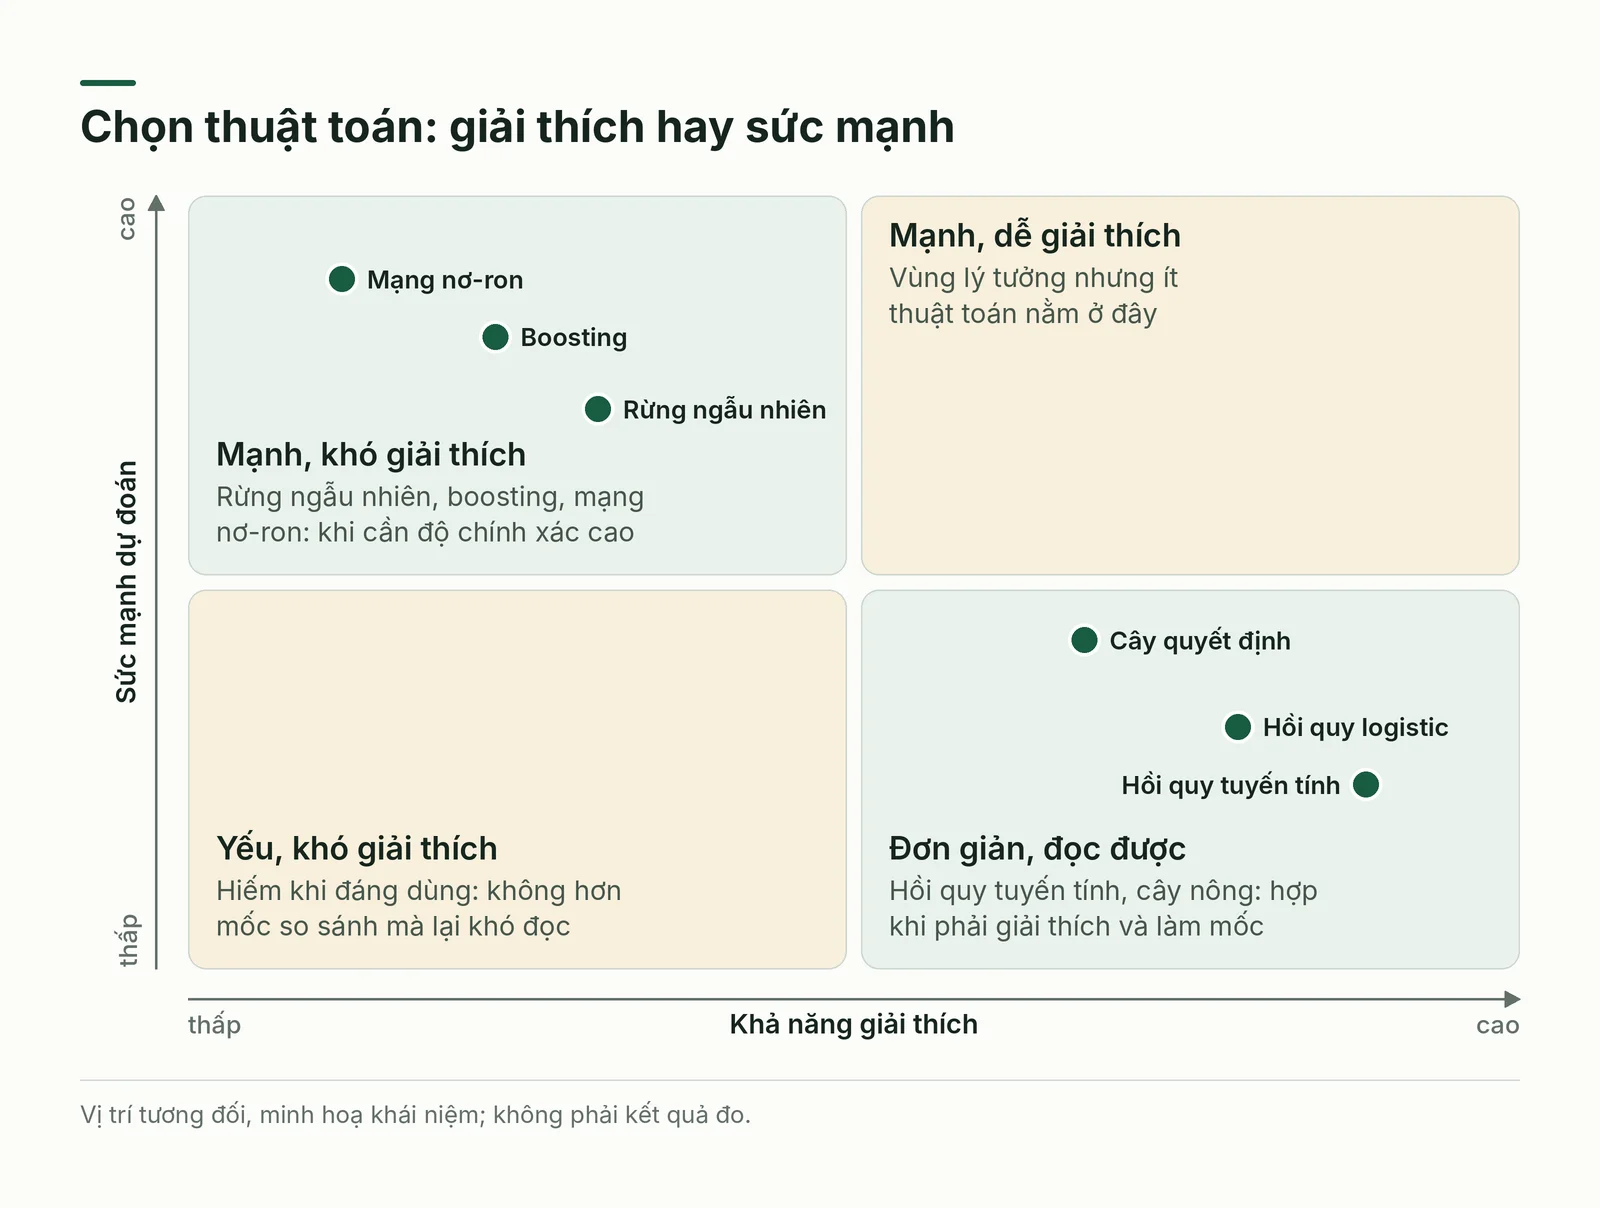
Với dữ liệu bảng có nhãn: hồi quy tuyến tính (linear regression) vẽ đường phù hợp nhất để dự báo con số; hồi quy logistic cho xác suất từ 0 đến 1 với kết quả hai khả năng như khách rời bỏ hay ở lại; cây quyết định (decision tree) hỏi lần lượt các câu có hoặc không nên dễ đọc; rừng ngẫu nhiên (random forest) huấn luyện nhiều cây trên mẫu con rồi lấy ý kiến chung; máy vector hỗ trợ (SVM) tìm ranh giới rộng nhất giữa các nhóm; k-NN và Naive Bayes dùng láng giềng gần nhất hay xác suất, gọn và nhanh. Nhóm boosting (AdaBoost, gradient boosting) xếp nhiều mô hình yếu nối tiếp, mô hình sau sửa lỗi mô hình trước.
Với dữ liệu chưa nhãn: k-means và phân cụm phân cấp chia nhóm; PCA, SVD nén số chiều; SOM chiếu dữ liệu nhiều chiều lên mặt phẳng; EM, ICA, NMF lo ước lượng mô hình xác suất, tách tín hiệu trộn lẫn, tách chủ đề văn bản; autoencoder và mạng đối nghịch sinh tạo (GAN) sinh dữ liệu mới theo phân bố của dữ liệu cũ. Không có thuật toán tốt nhất cho mọi bài toán, nên hãy chọn theo bốn tiêu chí sau.
- Loại đầu ra: con số, nhóm hay cấu trúc chưa biết.
- Loại dữ liệu: bảng thường hợp cây và boosting; ảnh, tiếng nói, văn bản thường hợp học sâu.
- Nhu cầu giải thích: phải trả lời khách hay cơ quan quản lý vì sao bị từ chối thì ưu tiên mô hình đọc được; cân thêm tốc độ và chi phí vận hành.
- Mô hình chuẩn so sánh (baseline) như trung bình hay luật hiện hành: mô hình phức tạp chỉ đáng dùng khi thắng baseline đủ xa để bù chi phí.
Đo lường và cải thiện mô hình
Nguyên tắc đầu tiên: không chấm mô hình bằng chính dữ liệu đã dùng để dạy nó. Dữ liệu chia làm ba: tập huấn luyện để học, tập kiểm định (validation) để chỉnh siêu tham số và so sánh mô hình, tập kiểm thử (test) khoá đến cuối để chấm một lần, như đề ôn, thi thử, thi thật. Dữ liệu theo thời gian nên cắt theo mốc: học quá khứ rồi thử trên giai đoạn sau.
Thước đo phải gắn với chi phí sai lầm. Độ chính xác tổng thể (accuracy) là tỷ lệ đoán đúng; độ chuẩn xác (precision) là trong số ca máy báo “có”, bao nhiêu ca đúng; độ phủ (recall) là trong số ca thật sự có, máy bắt được bao nhiêu; điểm F1 là trung bình điều hoà của hai thước đo này. Giả sử cứ hai mươi đơn COD có một đơn bị từ chối nhận: mô hình luôn đoán “đơn nào cũng được nhận” đúng 19 trên 20 đơn, tức độ chính xác tổng thể rất cao, nhưng độ phủ bằng 0. Hãy hỏi bỏ sót một đơn rủi ro tốn bao nhiêu, báo nhầm một đơn tốt tốn bao nhiêu, rồi chỉnh ngưỡng theo tỷ lệ đó. Với dự báo con số, dùng sai số như MAE, RMSE.
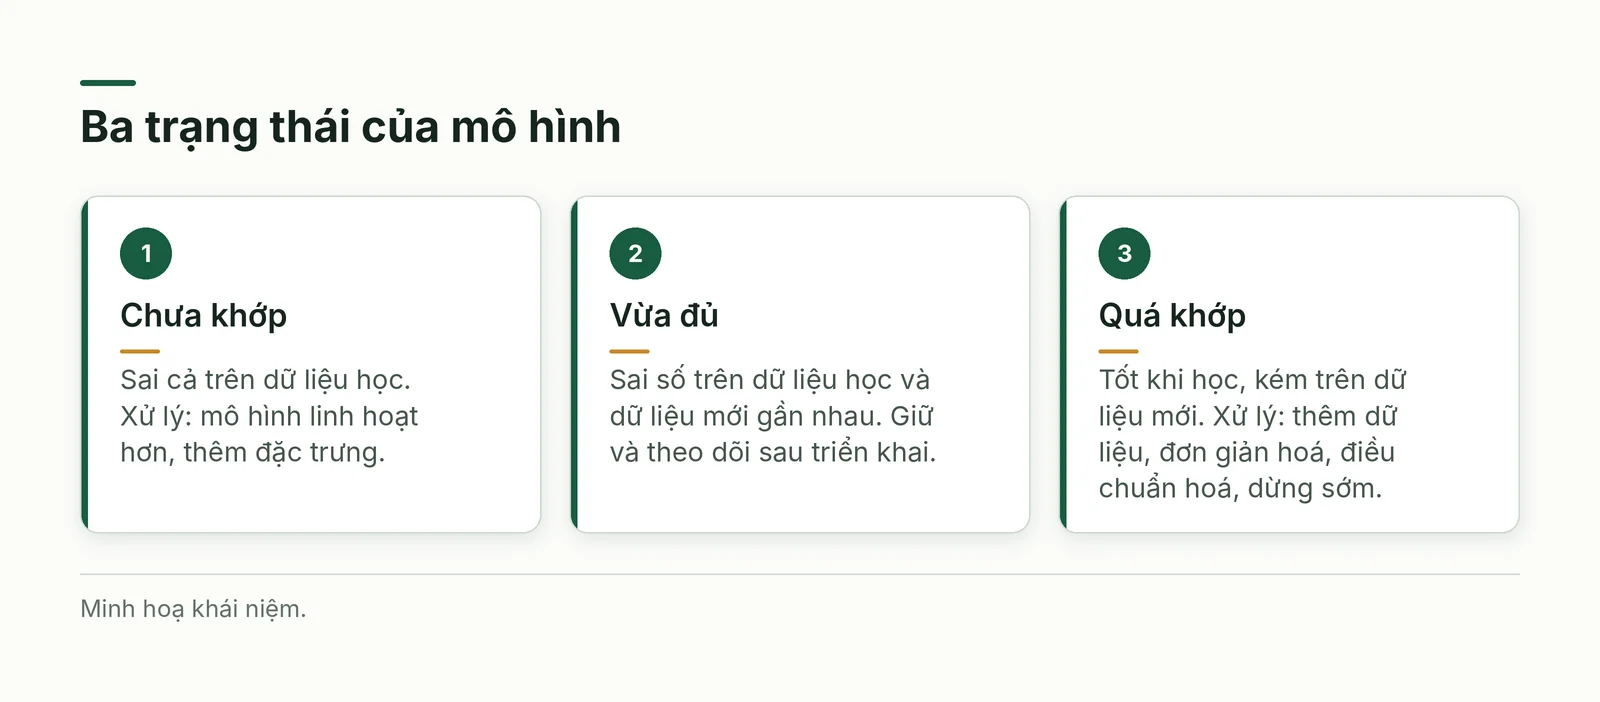
Hai bệnh kinh điển: chưa khớp (underfitting), khi mô hình quá đơn giản nên sai cả trên dữ liệu học; quá khớp (overfitting), khi mô hình học thuộc cả nhiễu nên tốt lúc học, kém khi gặp dữ liệu mới. Gốc rễ là thiên lệch (bias), do giả định quá đơn giản, và phương sai (variance), do quá nhạy với mẫu huấn luyện. Chữa quá khớp bằng thêm dữ liệu, đơn giản hoá, điều chuẩn hoá (regularization) hay dừng sớm; chữa chưa khớp bằng mô hình linh hoạt hơn.
Khi mô hình đơn lẻ chạm trần có bốn hướng. Ghép nhiều mô hình (ensemble): bagging huấn luyện nhiều mô hình độc lập rồi lấy trung bình, boosting huấn luyện nối tiếp để sửa lỗi; ổn định hơn nhưng tốn sức tính, khó giải thích. Học chuyển giao (transfer learning) tinh chỉnh mô hình sẵn có bằng ít dữ liệu của bạn, hợp doanh nghiệp nhỏ. Học trực tuyến (online learning) cập nhật khi có dữ liệu mới. Cuối cùng là theo dõi sau triển khai, vì dữ liệu thực tế trôi dần khỏi dữ liệu đã dạy.
Học sâu và học tăng cường: hai nhánh mạnh nhưng đắt
Mạng nơ-ron (neural network) gồm các lớp “nơ-ron” nhân tạo nối với nhau, mỗi lớp biến đổi dữ liệu thêm một chút; nhiều lớp thì thành học sâu. Lợi thế là tự học đặc trưng từ dữ liệu thô như điểm ảnh, sóng âm, nên học sâu chiếm ưu thế ở nhận dạng ảnh, tiếng nói, ngôn ngữ. Cái giá là nhu cầu dữ liệu và sức tính lớn, khó giải thích vì quyết định trải ra hàng triệu tham số, và nguy cơ tấn công đối nghịch (adversarial attack): sửa rất nhỏ đầu vào để mô hình đoán sai.
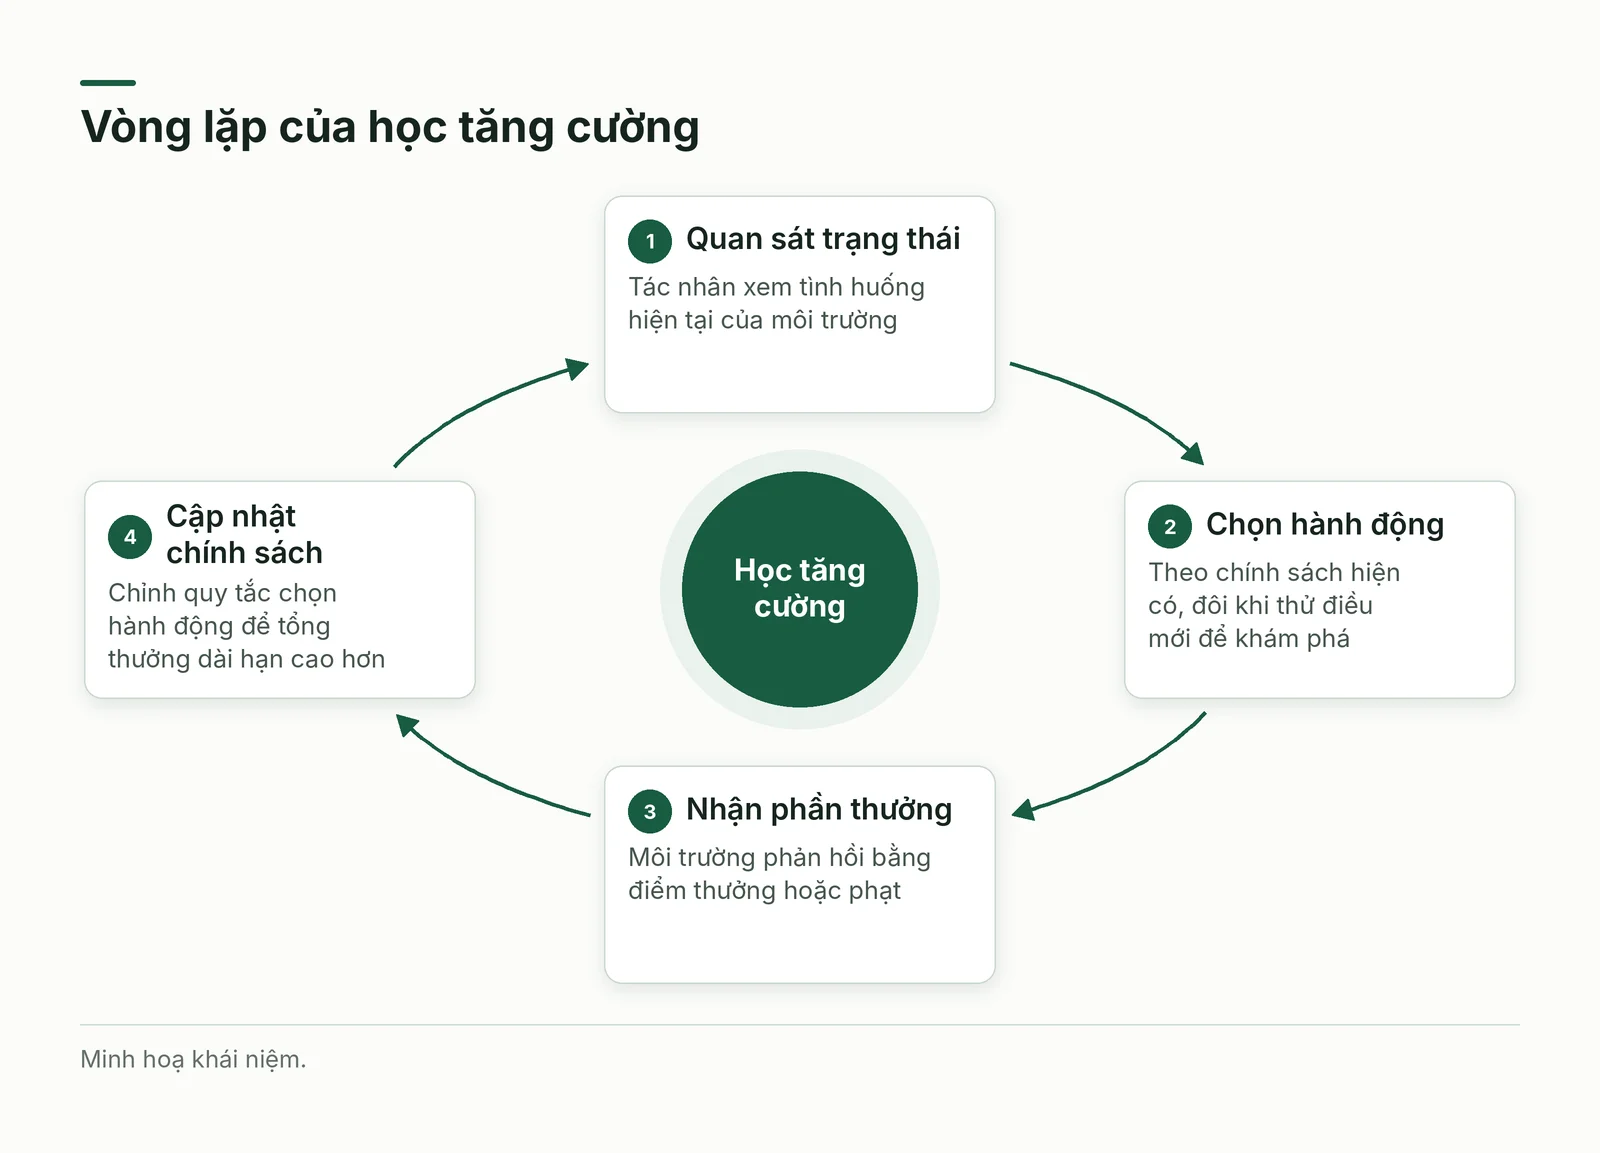
Học tăng cường: tác nhân (agent) quan sát trạng thái (state) của môi trường (environment), chọn hành động (action), nhận phần thưởng (reward) rồi cập nhật chính sách (policy), tức quy tắc chọn hành động, để tổng thưởng dài hạn cao hơn; hàm giá trị ước lượng thưởng tương lai của một trạng thái. Thách thức cốt lõi là cân bằng khám phá, tức thử điều mới, với khai thác, tức làm điều đang có lãi, như chia ngân sách quảng cáo giữa mẫu mới và mẫu đang chạy tốt.
Với doanh nghiệp, phần thưởng là đòn bẩy quản trị: tối đa hoá lượt nhấp có thể phá trải nghiệm khách vì tác nhân khai thác mọi kẽ hở của thước đo, nên chỉnh tín hiệu thưởng (reward shaping) cần người nắm nghiệp vụ. Khám phá tốn tiền thật, nên thử trong mô phỏng hoặc phạm vi nhỏ trước. Học tăng cường sâu ghép mạng nơ-ron vào vòng lặp này khi dữ liệu cảm biến nhiều chiều.
Ngôn ngữ, hình ảnh, dự báo và bản đồ ứng dụng theo ngành
Xử lý ngôn ngữ bằng học máy giúp máy đọc, hiểu và sinh văn bản: dịch, phân loại, phân tích cảm xúc, hỏi đáp. Văn bản được tách từ (tokenization), đưa về dạng gốc (stemming, lemmatization), bỏ từ dừng rồi đổi thành số, từ one-hot đến vector nhúng từ (word2vec, GloVe) để từ gần nghĩa nằm gần nhau. Mô hình chuỗi sang chuỗi và cơ chế chú ý (attention) lo dịch, tóm tắt.
Thị giác máy tính (computer vision) cho máy phân loại ảnh, nhận diện đối tượng; ảnh được đổi cỡ, số hoá rồi qua mạng nơ-ron tích chập (CNN) để trích đặc trưng. Phân tích dự báo (predictive analytics) dùng dữ liệu lịch sử ước lượng khách rời bỏ, gian lận, nhu cầu, thường bằng hồi quy, cây quyết định, rừng ngẫu nhiên. Ba mảng này là các kiểu học đã nêu áp lên loại dữ liệu khác nhau; danh sách sau gắn chúng với ngành.
- Bán lẻ, thương mại điện tử, chuỗi cung ứng: khuyến nghị sản phẩm, dự báo nhu cầu, quản lý tồn kho, tối ưu tuyến giao.
- Tài chính, ngân hàng: chấm điểm tín dụng, phát hiện gian lận, dự báo rủi ro.
- Sản xuất, năng lượng, vận tải: kiểm tra chất lượng bằng ảnh, bảo trì dự đoán theo cảm biến, dự báo phụ tải.
- Y tế, giáo dục, nông nghiệp: đọc ảnh chẩn đoán, cá nhân hoá bài học, dự báo năng suất từ ảnh vệ tinh.
- Quảng cáo, mạng xã hội, chăm sóc khách hàng: nhắm đối tượng, lọc thư rác, chatbot.
- Nhân sự, viễn thông, an ninh mạng: sàng lọc hồ sơ (cần kiểm soát thiên lệch), phân bổ tài nguyên mạng, phát hiện đăng nhập bất thường.
- Ghép với công nghệ khác: cảm biến IoT cấp dữ liệu, điện toán đám mây cấp sức tính theo nhu cầu, nền tảng dữ liệu lớn lo lưu trữ; doanh nghiệp nhỏ nên thuê đám mây hoặc dùng phần mềm đóng gói thay vì tự xây.
Đạo đức, quyền riêng tư và trách nhiệm khi dùng học máy
Mô hình chỉ biết những gì dữ liệu cho nó thấy. Nếu dữ liệu lệch, như thiếu một nhóm khách hoặc phản ánh quyết định thiên vị của quá khứ, kết quả lệch theo và lặp lại bất công dưới vẻ khách quan của con số. Hãy kiểm tra độ phủ dữ liệu theo nhóm, đo sai số riêng từng nhóm thay vì chỉ đo trung bình. Tuyển dụng, tín dụng, bảo hiểm cần thận trọng nhất vì quyết định tác động trực tiếp đến cơ hội của một con người.
Khả năng giải thích (explainability) là điều kiện để phát hiện sai và để có người chịu trách nhiệm. Mạng nơ-ron sâu thường là hộp đen; khi khoản vay bị từ chối, khách có quyền hỏi lý do và doanh nghiệp cần trả lời được. Hãy xác định trước ai chịu trách nhiệm về quyết định của thuật toán, ai có quyền ngắt hoặc sửa, ca hệ trọng có luôn qua người duyệt không.
Học máy cần nhiều dữ liệu nên kéo theo rủi ro quyền riêng tư: thu thập quá mức, dùng sai mục đích, mô hình bị tấn công hay lạm dụng. Luật Trí tuệ nhân tạo của Việt Nam, được Quốc hội thông qua ngày 10/12/2025 và có hiệu lực từ 1/3/2026, chia hệ thống AI thành ba mức rủi ro: cao, trung bình, thấp [1]. Theo VnEconomy, luật yêu cầu giám sát của con người với quyết định quan trọng và đặt tiêu chuẩn chặt hơn cho ứng dụng rủi ro cao như trong tài chính, y tế, tư pháp, lao động, giáo dục [2].
Luật Bảo vệ dữ liệu cá nhân số 91/2025/QH15 có hiệu lực từ 1/1/2026; một bài hướng dẫn trên website VCCI khuyến nghị doanh nghiệp rà soát chính sách quyền riêng tư, hợp đồng và chuẩn bị hồ sơ đánh giá tác động [3]. Với dự án học máy, hệ quả thực tế là ghi lại nguồn dữ liệu, mục đích sử dụng, phiên bản mô hình và người duyệt để giải trình khi cần.
Cách áp dụng: bảy bước đưa học máy vào một quyết định cụ thể
Quy trình dưới đây dành cho dự án học máy đầu tiên của doanh nghiệp: nhỏ, đo được, dừng lúc nào cũng không hại vận hành. Mỗi bước có một sản phẩm đầu ra cụ thể để người quản lý nghiệm thu, tránh cảnh dự án chạy nhiều tháng mà không ai biết đã đi được bao xa.
- Bước 1: Chọn một quyết định lặp lại, có giá trị tiền đo được; viết ra “đáp án” cần dự đoán và chi phí từng loại sai lầm.
- Bước 2: Kiểm kê dữ liệu: nguồn, độ dài lịch sử, có ghi kết quả thật không, ai có quyền dùng theo luật bảo vệ dữ liệu cá nhân.
- Bước 3: Làm sạch, chia tập theo thời gian, khoá tập kiểm thử lại.
- Bước 4: Dựng mô hình chuẩn so sánh (baseline) như trung bình, luật hiện hành hay hồi quy đơn giản, và ghi điểm số của nó.
- Bước 5: Thử hai đến ba mô hình ứng viên trên tập kiểm định, chốt ngưỡng quyết định theo chi phí.
- Bước 6: Chấm một lần trên tập kiểm thử; xem lỗi theo nhóm khu vực, loại khách; đọc các ca sai lớn nhất cùng người nghiệp vụ.
- Bước 7: Chạy song song quy trình cũ, theo dõi sai số hằng tuần, đặt điều kiện dừng; chỉ mở rộng khi mô hình thắng baseline ổn định.
Ví dụ quốc tế: khi mô hình dự báo giá gặp thị trường đổi chiều
Zillow, công ty bất động sản trực tuyến của Mỹ, từng mua nhà bằng vốn riêng để bán lại trong mảng Zillow Offers. Thư gửi cổ đông quý III/2021 thông báo thu hẹp mảng này, ghi giảm 304 triệu USD giá trị nhà tồn kho vì mua với giá cao hơn ước tính của chính công ty về giá bán tương lai, cắt khoảng 25% nhân sự và nêu lý do là chưa dự báo chính xác được giá nhà [4]. Thư không bàn về thuật toán, nhưng vụ việc minh hoạ hai giới hạn chung của mô hình dự báo: quan hệ học từ quá khứ có thể đổi khi thị trường biến động, và sai số bị nhân lên theo vốn đặt cược.
Tình huống tại Việt Nam: bán lẻ, ngân hàng và tín dụng
Báo chí cho biết chuỗi Bách Hóa Xanh áp dụng AI để đếm lượt khách, đo sức mua, sức bán và tính theo mùa vụ [5]. Tại cuộc họp ngày 10/2/2026, ông Vũ Đăng Linh, Tổng giám đốc CTCP Đầu tư Thế Giới Di Động, nói AI giúp phân bổ hàng hợp lý hơn, tỷ lệ hủy hàng giảm; bài đăng không nêu con số [6].
Về kỹ thuật, các việc ấy tương ứng ba bài toán: đếm người bằng thị giác máy tính, dự báo chuỗi thời gian theo cửa hàng, tối ưu phân bổ dựa trên dự báo; hai bài không nêu kỹ thuật cụ thể. Với hàng tươi, dư thì hủy, thiếu thì mất doanh thu, nên thước đo sai số phải phản ánh sự bất đối xứng ấy. Đây là lời của lãnh đạo, chưa có đánh giá độc lập.
Trong ngân hàng, Quyết định 2345/QĐ-NHNN của Ngân hàng Nhà nước, ban hành ngày 18/12/2023 và có hiệu lực từ 1/7/2024, yêu cầu xác thực sinh trắc học với chuyển tiền trực tuyến trên 10 triệu đồng mỗi giao dịch hoặc tổng trên 20 triệu đồng mỗi ngày, bằng đặc điểm như khuôn mặt, vân tay, mống mắt hay giọng nói [7]. So khớp khuôn mặt thuộc nhóm thị giác máy tính; ngưỡng chấp nhận quyết định sự đánh đổi giữa chặn nhầm khách thật và để lọt kẻ giả mạo, đúng tinh thần độ chuẩn xác và độ phủ.
Một bài trên Tạp chí Thị trường Tài chính Tiền tệ ngày 13/9/2025 tổng hợp việc các ngân hàng dùng AI cho chấm điểm tín dụng, phòng chống gian lận và nêu các trở ngại như dữ liệu và bảo mật, mô hình hộp đen khó giải thích lý do từ chối vay, thiếu nhân lực chuyên môn [8]. Bài không dẫn nguồn gốc cho nhiều số liệu nên chỉ dùng để phác bức tranh chung. Điểm chung của ba tình huống: dữ liệu sẵn có trong vận hành, quyết định lặp lại với chi phí sai lầm đo được, ngưỡng chấp nhận do doanh nghiệp hoặc cơ quan quản lý đặt ra.
Sai lầm thường gặp, giới hạn và khi nào không nên dùng
Sai lầm gốc là bắt đầu với công cụ thay vì với quyết định cần cải thiện: mua “AI” rồi mới đi tìm việc cho nó. Những sai lầm còn lại thường rơi vào đo lường và vận hành, và đều có thể phát hiện sớm bằng vài câu hỏi đơn giản.
- Chỉ nhìn độ chính xác tổng thể, nhất là khi một nhóm rất hiếm.
- Chấm mô hình bằng dữ liệu đã dùng để dạy, hoặc để lọt thông tin của đáp án vào đặc trưng (rò rỉ dữ liệu).
- Kỳ vọng mô hình phức tạp trên dữ liệu ít, lệch hoặc không có nhãn.
- Chọn mô hình khó giải thích khi khách hàng hoặc quy định đòi lời giải thích.
- Triển khai rồi bỏ mặc, trong khi mùa vụ, giá, hành vi khách đổi mà không ai theo dõi sai số.
- Nhầm tương quan với nhân quả: hai thứ đi cùng nhau chưa chắc tác động vào thứ này sẽ đổi thứ kia.
Không nên dùng học máy khi luật đã đủ và ổn định, như quy định thuế; khi dữ liệu quá ít để chia tập kiểm thử đáng tin; khi một sai lầm đơn lẻ gây hậu quả nặng mà không có người duyệt từng ca; khi quyết định bắt buộc giải thích được từng bước; hoặc khi thu thập dữ liệu vi phạm quyền riêng tư. Khi ấy bảng tính, thống kê mô tả hay luật rõ ràng thường rẻ hơn và đáng tin hơn.
Kế hoạch thử nghiệm bốn tuần và ba câu hỏi tự kiểm
Mỗi tuần dưới đây có một đầu ra cụ thể để người quản lý nghiệm thu và quyết định tiếp tục hay dừng; nếu cuối tuần 4 mô hình không thắng mô hình chuẩn so sánh, dừng lại cũng là một kết quả có giá trị.
- Tuần 1: Chọn quyết định, viết định nghĩa nhãn và bảng chi phí sai lầm; kiểm kê dữ liệu và quyền sử dụng.
- Tuần 2: Làm sạch, chia tập theo thời gian, dựng mô hình chuẩn so sánh, ghi điểm số.
- Tuần 3: Huấn luyện hai đến ba mô hình, chỉnh ngưỡng theo chi phí, xem lỗi theo nhóm cùng người nghiệp vụ.
- Tuần 4: Chạy song song quy trình cũ trên dữ liệu mới, so kết quả, quyết định mở rộng, chỉnh hoặc dừng.
Ba câu hỏi tự kiểm trước khi chi tiền: loại sai lầm nào đắt hơn và thước đo đang dùng có phản ánh điều đó không; nếu mô hình đúng chín ca trên mười thì ca còn lại gây hậu quả gì và ai sẽ phát hiện; khi dữ liệu đổi, ai sẽ biết trước khi khách hàng biết.
Kết luận
Học máy là cách ra quyết định bằng quy luật học từ dữ liệu: mạnh ở việc lặp lại có nhiều ví dụ, yếu khi dữ liệu nghèo, khi thế giới đổi hoặc khi người ta đòi lời giải thích. Lợi thế thuộc về doanh nghiệp biết đặt đúng câu hỏi, giữ dữ liệu sạch, đo bằng chi phí thật và duy trì giám sát của con người. Hãy bắt đầu từ một quyết định nhỏ, một chỉ số rõ, một mô hình chuẩn so sánh, rồi mở rộng bằng bằng chứng.
Nguồn và phương pháp
Bài là tổng hợp và phân tích có hỗ trợ AI, diễn đạt lại bằng lời riêng, không phải bản dịch. Kiến thức nền dựa trên tài liệu “Machine Learning EXPLAINED” của Business Explained (bản v2, tệp Machine-Learning-EXPLAINED-by-Business-Explained-v2.pdf, toàn bộ phạm vi trang 1–89); cấu trúc, ví dụ, hình vẽ và các phân tích so sánh do bài tự xây dựng. Độc giả nên tìm tài liệu gốc để đọc đầy đủ.
Dữ kiện về Việt Nam và quốc tế lấy từ các nguồn web có đánh số [1]–[8]: báo Đại biểu Nhân dân và VnEconomy về Luật Trí tuệ nhân tạo, website VCCI về Luật Bảo vệ dữ liệu cá nhân, thư gửi cổ đông quý III/2021 của Zillow trên SEC, Nhịp sống thị trường (qua Stockbiz) và 24hmoney về Bách Hóa Xanh, LuatVietnam về Quyết định 2345/QĐ-NHNN, Tạp chí Thị trường Tài chính Tiền tệ về AI trong ngân hàng. Ngày truy cập tất cả nguồn web: 20/10/2026.
Điều chưa kiểm chứng: các phát biểu về hiệu quả AI của Bách Hóa Xanh là lời của lãnh đạo doanh nghiệp, chưa có đánh giá độc lập; bài ngân hàng trên Tạp chí Thị trường Tài chính Tiền tệ có nhiều số liệu không dẫn nguồn gốc nên không được dùng làm số liệu; các ví dụ giả định (chuỗi nhiều cửa hàng, đơn COD bị từ chối nhận) chỉ để minh hoạ, không gắn với doanh nghiệp thật.