LightRAG: RAG dựa trên đồ thị tri thức, từ bài báo khoa học tới máy chủ vận hành
Đăng ngày 12/10/2026
Mục lục bài nghiên cứu
Tóm lược: LightRAG đáng thử khi câu hỏi xoay quanh quan hệ giữa các thực thể
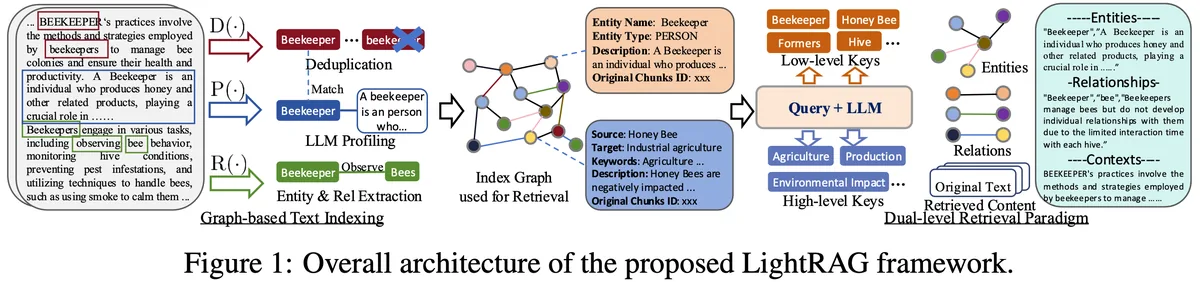
LightRAG là khung RAG dựa trên đồ thị tri thức (knowledge graph, mạng lưới thực thể và quan hệ) của nhóm HKUDS, đi kèm bài báo arXiv 2410.05779. [1] README mô tả kiến trúc hai tầng quản lý cả đồ thị lẫn vector embedding, tự định vị là phương án hiệu quả thay Microsoft GraphRAG; dự án gồm thư viện Python và LightRAG Server có Web UI, REST API. [1][6]
Nên cân nhắc khi kho tài liệu giàu thực thể như nhân vật, tổ chức, sản phẩm, điều khoản, và người dùng hỏi về liên hệ xuyên nhiều tài liệu. Năm chế độ truy vấn cho phép chọn giữa truy xuất theo thực thể cụ thể, theo chủ đề rộng, hay kết hợp truy xuất đoạn văn truyền thống. [1]
Không nên chọn khi thiếu kỹ sư Python, ngân sách LLM cho lập chỉ mục hạn hẹp, hoặc cần hệ thống tài khoản đầy đủ, vì tài liệu máy chủ cho biết mới hỗ trợ cấu hình tài khoản quản trị. [6] Khuyến nghị: dùng PostgreSQL thay bộ lưu trữ mặc định, bật xác thực từ đầu, tự đo trên dữ liệu của mình thay vì dựa vào bảng kết quả trong README.
Giới hạn của truy xuất theo đoạn văn rời rạc
RAG truyền thống cắt tài liệu thành đoạn, nhúng thành vector rồi lấy các đoạn gần câu hỏi nhất; tệp mẫu trong thư mục đánh giá của kho tóm tắt mô hình này thành hệ truy xuất, mô hình embedding và LLM. [10] Cách này hợp với câu hỏi tra một chi tiết, nhưng khó với câu hỏi tổng hợp như “nhân vật nào liên hệ với phe A qua các chương”.
README nêu đúng điểm này: lập chỉ mục có cấu trúc đồ thị nắm được phụ thuộc ngữ nghĩa giữa thực thể, khắc phục giới hạn ngữ cảnh rời rạc của truy xuất theo đoạn, còn truy xuất hai mức kết hợp chi tiết cụ thể với khái niệm trừu tượng. [1]
Các hướng GraphRAG thường tốn kém khi lập chỉ mục và khó cập nhật tăng dần. LightRAG cho biết không dựa vào báo cáo cộng đồng hay suy luận nhiều bước nên giảm lời gọi LLM, và hỗ trợ cập nhật tăng dần, xóa chọn lọc nhờ cache LLM [1]; đây là tuyên bố của nhóm phát triển, mức tiết kiệm thực tế tùy dữ liệu và mô hình.
Hai tầng chỉ mục, bốn loại lưu trữ và bốn vai trò mô hình
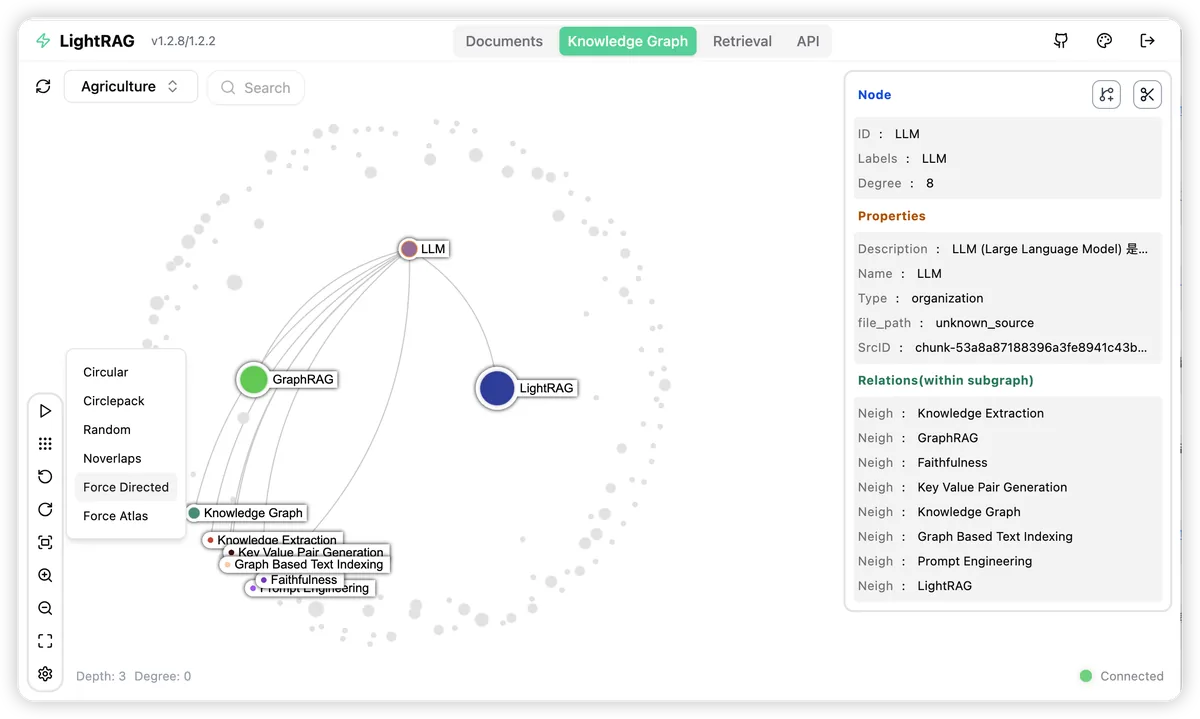
LightRAG dùng bốn loại lưu trữ: KV_STORAGE cho cache phản hồi LLM, đoạn văn, kết quả trích xuất; VECTOR_STORAGE cho vector của đoạn, thực thể, quan hệ; GRAPH_STORAGE cho đồ thị; DOC_STATUS_STORAGE cho trạng thái tài liệu. [1][6] Mặc định là JSON, NanoVectorDB và NetworkX; các lựa chọn khác gồm PostgreSQL, MongoDB, OpenSearch, Redis, Milvus, Qdrant, Neo4j, Memgraph. [6]
Bộ mặc định nằm hoàn toàn trong RAM của tiến trình, tệp trong WORKING_DIR chỉ để lưu bền, nên chỉ hợp thử nghiệm. [1] Theo tài liệu thiết kế, NetworkXStorage ghi đồ thị vào một tệp GraphML duy nhất, mỗi workspace một tiến trình ghi. [8] PostgreSQL được khuyến nghị cho production vì một mình phục vụ cả bốn loại lưu trữ. [1][6]
Tầng mô hình có bốn vai trò: EXTRACT trích xuất thực thể–quan hệ và tóm tắt khi gộp, KEYWORD sinh từ khóa truy vấn, QUERY viết câu trả lời, VLM phân tích ảnh, bảng, công thức; vai trò không cấu hình riêng dùng thiết lập LLM gốc. [6] README khuyên mô hình không bật suy nghĩ cho EXTRACT, KEYWORD và mô hình mạnh hơn cho QUERY. [1]
Lớp phục vụ là LightRAG Server: Web UI, REST API và giao diện tương thích Ollama cho các ứng dụng chat như Open WebUI; chạy Uvicorn đơn tiến trình hoặc Gunicorn nhiều worker cho production, chế độ sau không hỗ trợ Windows. [6]
Vòng đời tài liệu: PENDING, PARSING, ANALYZING, PROCESSING, PROCESSED
Từ v1.5, pipeline có bốn engine: legacy chỉ lấy văn bản thô, native chạy cục bộ cho DOCX, Markdown, textpack, còn MinerU và Docling là dịch vụ ngoài. [6][7] Quy tắc định tuyến trong LIGHTRAG_PARSER theo phần mở rộng tệp, ghi đè được bằng gợi ý trong tên tệp; kết quả lưu ở định dạng LightRAG Document có siêu dữ liệu mục và đoạn để truy vết. [7]
Tài liệu đi qua các trạng thái PENDING, PARSING, ANALYZING, PROCESSING, PROCESSED. [7] ANALYZING gọi VLM cho ảnh và vai trò EXTRACT cho bảng, công thức khi bật tùy chọn i, t, e; PROCESSING chia đoạn theo F, R, V hoặc P, trích xuất thực thể–quan hệ, gộp đồ thị và ghi vector; tùy chọn dấu chấm than bỏ qua đồ thị, chỉ giữ vector đoạn văn. [7]
Khi truy vấn, local lấy thực thể và thuộc tính liên quan trực tiếp, global lấy chuỗi quan hệ theo chủ đề rộng, hybrid gộp hai chế độ, naive chỉ dùng vector đoạn văn, mix (mặc định) gộp cả ba. [1] Reranker tùy chọn thường thêm một đến hai giây [1]; API trả tham chiếu gồm mã và đường dẫn tệp, kèm được nội dung đoạn. [6]
Hai quy tắc cần nhớ: tài liệu trùng tên hoặc trùng nội dung bị ghi FAILED, không ghi đè bản cũ; engine và tùy chọn xử lý cố định lúc xếp hàng, muốn đổi phải xóa rồi tải lại. [7]
Đọc bảng kết quả của bài báo trong README với con mắt phản biện
README trích bảng kết quả từ bài báo, so LightRAG với NaiveRAG, RQ-RAG, HyDE và GraphRAG trên bốn miền nông nghiệp, khoa học máy tính, pháp lý, hỗn hợp, theo độ bao quát, độ đa dạng, mức trao quyền và tổng thể. [1] Mỗi cặp là hai tỉ lệ cộng lại 100%, ví dụ tổng thể miền pháp lý là 84,8% cho LightRAG, 15,2% cho NaiveRAG. [1]
Với GraphRAG, khoảng cách hẹp hơn nhiều: tổng thể miền khoa học máy tính là 52,0% so với 48,0%, còn ở miền hỗn hợp GraphRAG nhỉnh hơn, 50,4% so với 49,6%. [1] Bảng không đo độ chính xác sự kiện hay độ trễ, và bài chưa đọc Reproduce.md mô tả cách chấm nên chưa đánh giá được phương pháp đo.
Kết luận thực dụng: đây là kết quả do chính nhóm tác giả công bố trên bộ dữ liệu của họ, cho thấy hướng tiếp cận có cơ sở nghiên cứu nhưng không thay được phép thử trên dữ liệu tiếng Việt của từng tổ chức.
Tính năng đã kiểm chứng trong README và tài liệu máy chủ
Truy xuất: năm chế độ truy vấn, reranker qua Cohere hoặc vLLM, Jina, Aliyun, trích dẫn nguồn, cache LLM cho truy vấn lặp lại. [1][6] Qua giao diện tương thích Ollama, tiền tố như /local, /global hay /bypass trong tin nhắn chọn chế độ truy vấn. [6]
Xử lý tài liệu: engine native, MinerU, Docling và engine bên thứ ba; bốn chiến lược chia đoạn cố định, đệ quy, ngữ nghĩa vector, ngữ nghĩa theo đoạn; phân tích ảnh, bảng, công thức; tự sửa tiêu đề trong tệp Word. [1][7] Theo mục tin tức, RAG-Anything được gộp vào LightRAG từ tháng 5/2026. [1]
Biên tập tri thức qua SDK: tạo, sửa, đổi tên thực thể kèm chuyển quan hệ; tạo, sửa quan hệ; gộp thực thể; xóa theo thực thể, quan hệ hoặc mã tài liệu; hook kg_extraction_validator loại thực thể không đạt trước khi gộp vào đồ thị. [9] Tính năng chỉ có trong SDK là thử nghiệm, có thể không tương thích phiên bản sau. [1]
Vận hành: lối /webui cho quản trị và /workspace chỉ để hỏi đáp; workspace cách ly dữ liệu giữa các instance; công cụ bảo trì như lightrag-rebuild-vdb; đánh giá bằng RAGAS và theo dõi bằng Langfuse theo mục tin tức. [1][6]
Nhóm phù hợp: đội có kỹ sư Python và kho tài liệu giàu thực thể
LightRAG hợp với đội có ít nhất một kỹ sư Python đọc được tệp env.example dài, hiểu cơ sở dữ liệu và chịu chỉnh mô hình theo vai trò. README khuyên tích hợp qua REST API của máy chủ; SDK chủ yếu dành cho ứng dụng nhúng, nghiên cứu và đánh giá. [1]
Dữ liệu hưởng lợi nhiều là loại mà thực thể và quan hệ là trọng tâm: hồ sơ pháp lý, tài liệu tài chính, cẩm nang kỹ thuật, kho tri thức về nhân vật và thế giới hư cấu. README nhắc riêng pháp lý và tài chính như các miền dọc cần hiểu tổng thể. [1]
Nhóm nghiên cứu, giảng dạy về RAG là đối tượng tự nhiên nhờ bài báo, hướng dẫn tái lập và công cụ đánh giá. [1] Với ghi chép về quản trị tri thức trên phamvanthu.com, LightRAG gợi ý cách tổ chức tri thức theo quan hệ thay vì theo thư mục, dù vẫn cần người biên tập đồ thị.
Đề xuất cho một studio game độc lập: kho lore truy vấn được theo quan hệ
Tình huống giả định: studio game độc lập 14 người ở Đà Nẵng làm game nhập vai lấy cảm hứng từ truyện dân gian Việt Nam, với “kinh thánh thế giới” về nhân vật, phe phái, địa danh, vật phẩm, thiết kế nhiệm vụ dạng DOCX, kịch bản hội thoại, phản hồi playtest. Vấn đề: biên kịch mới khó nắm lore, chi tiết giữa các nhiệm vụ mâu thuẫn, nhóm bản địa hóa thiếu ngữ cảnh.
Thiết kế: một LightRAG Server dùng PostgreSQL cho cả bốn loại lưu trữ, mỗi dự án game một workspace [6]; tệp ENTITY_TYPE_PROMPT_FILE khai báo loại thực thể như nhân vật, phe phái, địa danh, vật phẩm, nhiệm vụ [6]; tài liệu DOCX dùng engine native với chiến lược P. [7] Câu hỏi “Bà Chúa Sương liên quan tới nhiệm vụ nào” hợp chế độ local, “chủ đề phản bội đi qua các chương ra sao” hợp global hoặc mix. [1]
Biên tập đồ thị là việc thường xuyên: edit_entity đổi tên nhân vật và chuyển mọi quan hệ, merge_entities gộp biệt danh, kg_extraction_validator loại tên không có trong đoạn nguồn. [9] Với tiếng Việt, cần thử SUMMARY_LANGUAGE [1]; chuỗi phân tách mặc định của chiến lược R có dấu câu tiếng Trung nhưng cố ý bỏ dấu chấm, hỏi, than kiểu Latin [7], nên cân nhắc đặt lại CHUNK_R_SEPARATORS. [6]
Lore chưa phát hành là tài sản trí tuệ: dùng LLM nội bộ hoặc nhà cung cấp cam kết không huấn luyện trên dữ liệu, bật xác thực, đặt máy chủ sau VPN. Web UI có tiếng Việt [6], lối /workspace đủ cho biên kịch chỉ cần hỏi đáp [1]; câu trả lời về lore vẫn cần trưởng nhóm cốt truyện xác nhận.
Triển khai: từ Docker Compose tới PostgreSQL và nâng cấp có dừng ghi
Cách nhanh nhất là Docker Compose với .env lấy từ env.example, hoặc để make env-base, env-storage, env-server sinh cấu hình. [1][4] Máy chủ mặc định nghe cổng 9621, dữ liệu nằm trong data/rag_storage và data/inputs; image chính thức chạy tiến trình bằng người dùng không phải root và được ký bằng Sigstore Cosign. [4]
Với PostgreSQL, tài liệu khuyên dùng image pgvector chính thức khi chọn PGTableGraphStorage vì không cần Apache AGE, và lưu ý dữ liệu khác phiên bản chính không tương thích nên không quay lui được. [4] Số đo kèm PR 3103 được tài liệu máy chủ dẫn lại: lấy đồ thị trung vị 39 ms so với 1.099 ms của PGGraphStorage, trên đồ thị khoảng 8 nghìn nút. [6]
Hai ràng buộc lớn: không đổi được loại lưu trữ khi đã có tài liệu, trừ vài đường di trú cụ thể; nâng cấp lên bản đổi giao thức điều phối thì phải dừng mọi tiến trình ghi cũ trước. [6] Môi trường không internet phải cài sẵn gói phụ thuộc và cache tiktoken vì LightRAG cài vài gói động; image Docker đã sẵn cho ngoại tuyến. [5]
Khi pipeline rơi vào trạng thái không chắc chắn, hàng rào recovery_required khiến mọi thao tác ghi trả về 503 cho tới khi quản trị viên xử lý; tài liệu giải thích lúc nào khởi động lại là đủ, lúc nào cần công cụ sửa. [7]
Xác thực, phạm vi API và ranh giới giao diện
Mặc định máy chủ nghe trên mọi giao diện mạng và không yêu cầu xác thực; README cảnh báo khi chưa cấu hình thì mọi endpoint đều công khai. [1] Có hai cơ chế: khóa API qua header X-API-Key, và tài khoản JWT HS256 với AUTH_ACCOUNTS, TOKEN_SECRET, mật khẩu lưu được dạng bcrypt. [6]
Ba chi tiết dễ bỏ sót: chỉ có khóa API mà thiếu tài khoản thì web UI vẫn vào được với vai khách nên API vẫn hở; route tương thích Ollama dưới /api mặc định được miễn xác thực; và ẩn giao diện quản trị khỏi /workspace không phải ranh giới bảo mật. [6][1] Lệnh make env-security-check rà .env tìm xác thực thiếu, whitelist không an toàn, khóa JWT yếu. [4]
Thân yêu cầu bị giới hạn mặc định 1 MiB cho route thường, trường gửi tới mô hình có trần cố định [6]; engine native chỉ tải ảnh ngoài trong Markdown từ IP công khai. [7] Bảng phiên bản hỗ trợ trong SECURITY.md chỉ ghi 1.2.x, 1.3.x dù README đã mô tả v1.5, nên cần hỏi lại phạm vi hỗ trợ. [3][1]
Nội dung tài liệu đi tới LLM khi trích xuất và tới VLM nếu bật phân tích ảnh; Ollama hay vLLM chạy nội bộ giữ dữ liệu trong mạng. [6][4] Tài liệu đã đọc chỉ mô tả cách ly ở cấp workspace, không mô tả phân quyền theo tài liệu hay người dùng. [6]
Giấy phép MIT của LightRAG Team và những gì nằm ngoài phạm vi
LICENSE ở gốc kho là MIT, ghi Copyright (c) 2025 LightRAG Team: được dùng, sao chép, sửa, xuất bản, phân phối, cấp phép lại và bán, với điều kiện giữ thông báo bản quyền và giấy phép; không bảo hành. [2] Danh sách tệp tài liệu và giấy phép thu thập tại commit này không cho thấy thư mục con nào mang giấy phép khác.
Phạm vi chỉ là mã tại commit 4d0afc1b. Giấy phép không bao trùm LLM, mô hình embedding hay reranker được gọi, như BAAI/bge-m3 và bge-reranker-v2-m3 được gợi ý cho triển khai cục bộ [1][4]; dịch vụ MinerU đám mây có giới hạn sử dụng riêng [1]; image PostgreSQL bên thứ ba gói Apache AGE và pgvector [4]; hay các mô hình spaCy được ghim cho smart_heading. [5]
Bản lưu trữ LanceDB và Nebula nằm ở nhánh phát triển do cộng đồng đóng góp. [6] README đề nghị trích dẫn bài báo khi dùng trong nghiên cứu, đó là chuẩn mực học thuật chứ không phải điều kiện của MIT [1][2]; RAG-Anything, VideoRAG, MiniRAG là kho riêng [1], và các tệp đã đọc không nhắc tới bản thương mại.
Ngân sách tính theo lời gọi LLM khi lập chỉ mục, không chỉ theo máy chủ
Khác RAG vector thuần, LightRAG gọi LLM trên từng đoạn để trích xuất thực thể, quan hệ, và README nói nó đòi mô hình mạnh hơn RAG truyền thống. [1] Chi phí lập chỉ mục vì thế tỉ lệ với số đoạn: dùng mô hình rẻ, không bật suy nghĩ cho EXTRACT, giữ mô hình mạnh cho QUERY [1][6]; chạy cục bộ thì README coi Qwen3-30B-A3B-Instruct là mức tối thiểu hợp lý. [1]
Giả định cho studio: vài nghìn trang tài liệu thiết kế, cập nhật hằng tuần. Cần máy chủ ứng dụng cùng PostgreSQL; GPU hoặc ngân sách API cho LLM; tùy chọn GPU cho vLLM chạy embedding, reranker [4]; một kỹ sư định kỳ lo cấu hình, sao lưu, nâng cấp. Cache LLM giúp lần xử lý lại dùng kết quả cũ thay vì trả phí lần nữa. [7]
Giờ biên tập là khoản hay bị quên: ai đó phải rà đồ thị, gộp biệt danh, sửa quan hệ sai. Với studio nhỏ, khoản này có thể lớn hơn tiền máy chủ, nên cần đưa vào kế hoạch từ đầu.
So với GraphRAG, RAG vector và các nền tảng RAG có giao diện
Microsoft GraphRAG là mốc so sánh mà README tự đặt ra; LightRAG nhấn mạnh việc bỏ báo cáo cộng đồng để giảm lời gọi LLM. [1] Bài không đánh giá GraphRAG, nên lựa chọn giữa hai bên cần thử trên cùng dữ liệu và cùng mô hình.
RAG vector thuần, tự viết hay qua ứng dụng chat tài liệu, rẻ hơn khi lập chỉ mục và dễ vận hành; LightRAG có sẵn chế độ naive làm mốc trong cùng hệ thống. [1] RAGFlow hay AnythingLLM thiên về giao diện, người dùng, xử lý tài liệu; LightRAG thiên về truy xuất theo đồ thị với nhiều lựa chọn lưu trữ.
Tự dựng đồ thị bằng Neo4j với ontology do người thiết kế cho độ chính xác cao nhưng tốn công nhập liệu; đưa toàn bộ tài liệu vào ngữ cảnh dài của LLM thì đơn giản nhưng tốn kém mỗi câu hỏi và khó trích dẫn. LightRAG nằm giữa: đồ thị do LLM sinh, con người hiệu chỉnh qua API.
Hạn chế đã thấy trong tài liệu và điều kiện không nên dùng
Hệ thống tài khoản còn sơ khai: tài liệu máy chủ ghi hiện chỉ hỗ trợ cấu hình tài khoản quản trị và mật khẩu, hệ thống tài khoản đầy đủ chưa được phát triển. [6] Tổ chức cần phân quyền theo người dùng nên đặt LightRAG sau một lớp xác thực khác hoặc chọn nền tảng khác.
Vài lựa chọn gần như không đảo ngược: mô hình embedding phải chốt trước khi lập chỉ mục, loại lưu trữ không đổi được khi đã có tài liệu. [1][6] README còn tự mâu thuẫn: một đoạn nói chưa có công cụ nhúng lại, đoạn khác và tài liệu SDK giới thiệu lightrag-rebuild-vdb để dựng lại vector [1][9]; nên thử công cụ này trên bản sao dữ liệu.
Không nên dùng khi thiếu ngân sách LLM cho lập chỉ mục, khi buộc chạy production nhiều worker trên Windows [6], khi định dùng bộ lưu trữ mặc định cho dữ liệu lớn [1], hoặc khi cần hỗ trợ thương mại, điều mà các tệp đã đọc không đề cập.
Kế hoạch thử nghiệm năm tuần trên một chương lore
Tuần 1: dựng LightRAG Server bằng Docker với PostgreSQL, bật cả khóa API lẫn tài khoản, chạy make env-security-check [4][6], rồi nạp một tệp DOCX theo hướng dẫn kiểm tra lần chạy đầu: xem tuyến parser qua endpoint supported_file_types, theo dõi trạng thái, kiểm tra sidecar. [7] Có thể nạp trước các tài liệu mẫu trong thư mục đánh giá của kho để kiểm tra đường ống. [10]
Tuần 2–3: nạp lore một chương và tài liệu nhiệm vụ liên quan; biên kịch soạn 80 câu hỏi chia ba nhóm: chi tiết một thực thể, quan hệ nhiều thực thể, tổng hợp chủ đề. So naive với local, global, mix, có và không có reranker, theo tỉ lệ đúng, tỉ lệ tham chiếu đúng tài liệu, số thực thể phải sửa tay, token lập chỉ mục.
Tuần 4–5: đổi tên một nhân vật bằng edit_entity, gộp biệt danh bằng merge_entities rồi kiểm tra câu trả lời [9]; xóa một tài liệu, xác nhận đồ thị được dựng lại; gọi thử API và route /api khi chưa xác thực. Dừng nếu có endpoint mở khi chưa xác thực, hoặc chế độ đồ thị không vượt naive ở câu hỏi quan hệ theo ngưỡng đặt trước. Kế hoạch này chưa có kết quả.
Kết luận: đồ thị tri thức chỉ có giá trị khi có người chăm
LightRAG đưa RAG theo đồ thị từ bài báo vào một máy chủ có Web UI, REST API, pipeline tài liệu chi tiết và nhiều lựa chọn lưu trữ, với tài liệu vận hành viết kỹ từ trạng thái tài liệu tới quy trình khôi phục. [1][6][7]
Giá trị chỉ thành hiện thực khi tổ chức chấp nhận ba cam kết: chi phí LLM cho lập chỉ mục, một cơ sở dữ liệu production thay cho bộ lưu trữ mặc định, và người biên tập đồ thị. [1][9] Lớp bảo mật cần bổ sung bên ngoài vì hệ thống tài khoản còn hạn chế. [6]
Với studio game, nhà xuất bản hay đơn vị có kho tri thức dày nhân vật và quan hệ, LightRAG đáng đưa vào thử nghiệm đối chứng với RAG vector, dưới giấy phép MIT thuận lợi [2]; quyết định nên dựa trên số đo với dữ liệu tiếng Việt của chính mình.
Phạm vi nguồn, commit khảo sát và giới hạn của phương pháp
LightRAG thuộc nhóm RAG và quản trị tri thức, được chọn từ kho lưu độc lập các danh sách GitHub Trending; dữ liệu tuyển chọn ghi 8 lần xuất hiện từ 07/01 đến 21/08/2026, bằng chứng là danh sách Python ngày 07/01/2026, vị trí thứ 11. [11] Kho chỉ phủ Python, Go, JavaScript, Swift và khuyết ngày 03/09, 12/10; loạt bài là tuyển chọn biên tập, không phải Top 100 chính thức.
Phiên bản đọc là commit 4d0afc1bc36e6a34d4a5895b68efe9413748627a (ngày commit 12/10/2026), kiểm tra ngày 12/10/2026, gồm README, LICENSE, SECURITY.md, hướng dẫn Docker, hướng dẫn ngoại tuyến, một tài liệu mẫu đánh giá [1][2][3][4][5][10] và bốn tài liệu bổ sung: hướng dẫn LightRAG Server, đặc tả pipeline xử lý tệp, hợp đồng thiết kế NetworkX, hướng dẫn lập trình với lõi. [6][7][8][9]
Toàn bộ phân tích dựa trên đọc tài liệu với công cụ AI hỗ trợ: không cài đặt, không chạy, không tái lập kết quả bài báo, và không phải công bố khoa học có phản biện. Số liệu trích từ tài liệu dự án, có ghi nguồn; tình huống studio, chi phí, kế hoạch thử nghiệm là đề xuất. Khi triển khai, hãy ghim một bản phát hành và đối chiếu lại.
Xem mã nguồn LightRAG trên GitHub