LocalAI: một API cho văn bản, giọng nói và hình ảnh trên hạ tầng tự quản
Đăng ngày 12/10/2026
Mục lục bài nghiên cứu
Tóm tắt: một cửa API cho nhiều loại mô hình, chạy trên hạ tầng của chính mình
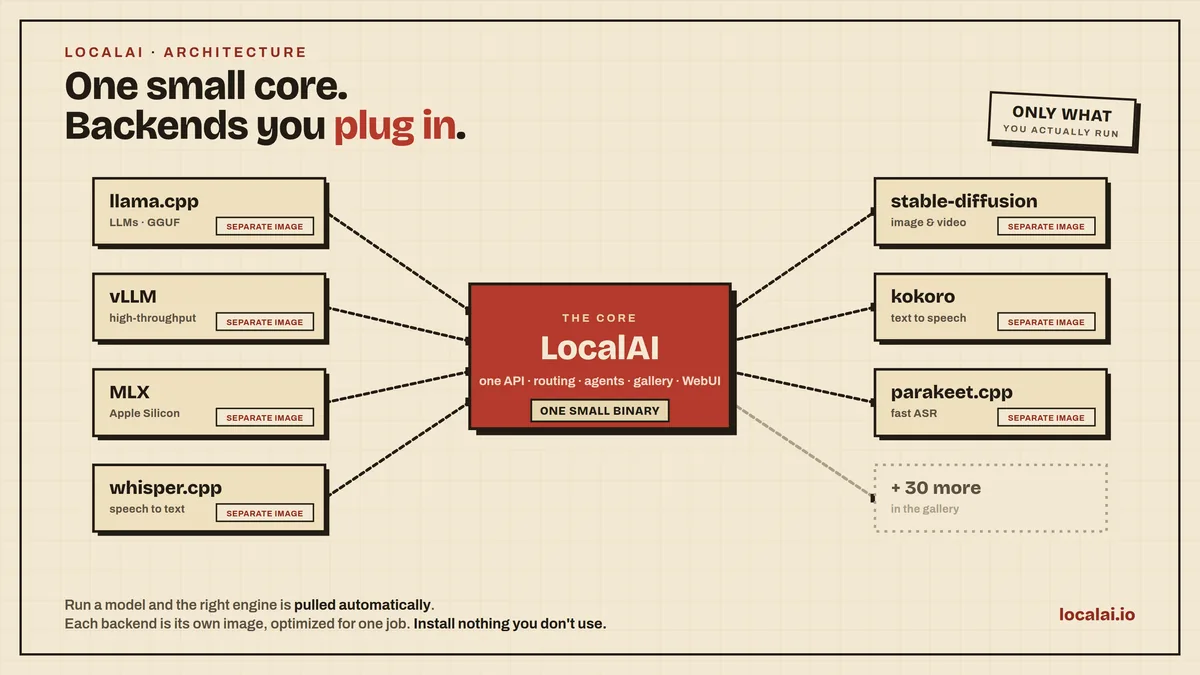
LocalAI tự giới thiệu là AI engine mã nguồn mở chạy LLM, mô hình thị giác, giọng nói, hình ảnh và video trên nhiều loại phần cứng, kể cả máy không có GPU [1]. README tóm thiết kế bằng câu “lõi nhỏ, không phải gói gộp”: mỗi backend bọc một engine như llama.cpp, vLLM hay whisper.cpp trong image riêng, chỉ kéo về khi cần, và tất cả nằm sau một API tương thích OpenAI, Anthropic, ElevenLabs [1].
Đáng cân nhắc khi cần một điểm truy cập chung cho chat, embedding, giọng nói và ảnh trên hạ tầng tự quản, kèm tài khoản, vai trò và thống kê mức dùng [1][7]. Không nên chọn khi mục tiêu duy nhất là thông lượng tối đa cho một LLM, hoặc khi không ai chịu trách nhiệm bảo mật, bởi nếu chưa bật chế độ xác thực nào thì middleware không chặn yêu cầu [7].
Khuyến nghị: bật hệ thống người dùng với OIDC hoặc đăng ký có duyệt, buộc chữ ký cho image backend, không chuyển tiếp ra đám mây dữ liệu chưa được phép rời tổ chức, và thử chất lượng tiếng Việt của từng mô hình trước khi dùng thật [7][8][11].
Vấn đề: mỗi engine một kiểu cài, một kiểu API, một kiểu phần cứng
Một tổ chức dùng AI nghiêm túc hiếm khi chỉ cần mô hình chat: tìm kiếm cần embedding (vector biểu diễn nghĩa) và reranker (mô hình xếp hạng lại kết quả), cuộc họp cần chuyển giọng nói thành văn bản, nội dung cần đọc thành tiếng. Mỗi engine mã nguồn mở có cách cài, giao diện và yêu cầu phần cứng riêng, nên ghép chúng thành một dịch vụ dùng chung tốn nhiều công.
Tài liệu kiến trúc kể LocalAI bắt đầu từ nhu cầu gọi llama.cpp bằng Go, rồi thành lớp thay thế tương thích OpenAI để phần mềm viết cho SDK OpenAI chạy được cục bộ, kể cả trên phần cứng phổ thông [3]. Đi kèm là bài toán quản trị ai được dùng và dùng bao nhiêu, mà tài liệu xác thực giải bằng vai trò, khóa API theo người và thống kê token [7].
LocalAI không giải bài toán chất lượng: câu trả lời đúng hay sai, giọng đọc tự nhiên hay gượng vẫn do mô hình được nạp quyết định.
Kiến trúc: lõi Go, backend là máy chủ gRPC đóng gói thành image OCI
Theo tài liệu kiến trúc, LocalAI là API viết bằng Go; backend bên trong chỉ là máy chủ gRPC viết bằng C++, Go hoặc Python, và người dùng có thể tự xây máy chủ gRPC hay chỉ định tệp chạy bên ngoài để LocalAI quản lý [3]. README nêu hơn 60 backend, trong đó vài engine C/C++/GGML do chính nhóm LocalAI viết như vllm.cpp, privacy-filter.cpp, cùng kho vector local-store [1].
Backend được phát hành thành image OCI (định dạng image container chuẩn) với các biến thể CPU, CUDA, ROCm, SYCL, Vulkan, Metal, Jetson và cài từ backend gallery [8]. Mỗi backend đã cài là một thư mục có run.sh bắt buộc và metadata.json tùy chọn; nhờ alias, LocalAI tự chọn biến thể khớp phần cứng, ví dụ trên máy NVIDIA ưu tiên CUDA, rồi Vulkan, rồi CPU [8].
Mô hình được mô tả bằng tệp YAML gồm tên, backend, tham số, template, gọi hàm, cấu hình TTS và lọc PII; mục artifacts có thể ghim kho Hugging Face vào một commit bất biến [10]. Khi cần mở rộng ngang, README mô tả chế độ phân tán dùng PostgreSQL và NATS [1].
Từ tệp YAML đến tệp âm thanh: đường đi của một yêu cầu đọc văn bản
Lấy ví dụ yêu cầu đọc văn bản thành tiếng: client gửi POST tới /v1/audio/speech với model, input và tùy chọn voice [9]. Khi đã cấu hình xác thực, middleware chặn mọi route ngoài nhóm công khai nếu thiếu thông tin xác thực, kể cả tệp đã sinh dưới /generated-audio/ [7].
LocalAI đọc YAML của mô hình để biết backend, rồi chọn giọng theo thứ tự: voice trong yêu cầu, có thể là hồ sơ localai://voice-profiles/..., sau đó tts.voice, tts.audio_path, cuối cùng là giọng mặc định của backend [9]. Backend chưa chạy thì được khởi động và hỏi trạng thái Health qua gRPC, mặc định 20 lần cách nhau 2 giây [10]; kết quả là audio/wav hoặc luồng âm thanh [9].
Với chat, nếu mô hình bật lọc PII, bộ phát hiện dựa trên NER (nhận dạng thực thể có tên) che hoặc chặn thực thể ở phía đầu vào; bộ phát hiện không nạp được thì yêu cầu bị từ chối với HTTP 503 [10]. Nếu mô hình dùng backend cloud-proxy, thân yêu cầu được chuyển gần như nguyên văn tới nhà cung cấp bên ngoài [11]. Mỗi yêu cầu của người dùng đã đăng nhập được ghi token, mô hình, endpoint và thời lượng [7].
Tính năng hiện hành theo tài liệu, tách khỏi bản alpha và thử nghiệm
README liệt kê sinh văn bản, chuyển văn bản thành giọng nói và ngược lại, sinh ảnh, API công cụ tương thích OpenAI, Realtime API, embedding, ràng buộc ngữ pháp, Vision API, phát hiện vật thể, reranker, suy luận P2P, chế độ phân tán, MCP, agent tích hợp, backend gallery, phát hiện giọng nói (VAD) và giao diện web [1].
Tài liệu xác thực mô tả khóa API kiểu cũ, hệ thống người dùng với vai trò admin và user, đăng nhập GitHub OAuth hoặc OIDC, khóa API cá nhân đặt được hạn dùng, ba chế độ đăng ký open, approval, invite và thống kê mức dùng [7]. API TTS tương thích OpenAI và ElevenLabs, có thư viện giọng nhân bản và streaming ở một số backend [9].
Cần tách mức độ sẵn sàng: vllm.cpp được README giới thiệu trong bản 4.8.0 dưới dạng bản dựng phát triển alpha, còn transformers-musicgen là hỗ trợ thử nghiệm [1][9]. Một số tính năng phụ thuộc cách build: hệ thống xác thực cần build tag auth, có sẵn trong Docker image mặc định, còn backend Piper cần GO_TAGS=tts [7][9].
Phù hợp với ai: từ máy trạm một phòng ban đến cụm nhiều nút
LocalAI hợp với doanh nghiệp vừa và nhỏ, trường học, phòng thí nghiệm hay tòa soạn muốn một trạm AI nội bộ đa năng, và với nhà phát triển muốn thay API OpenAI bằng máy chủ cục bộ mà ít sửa mã [3]. Phần cứng trải từ CPU tới GPU NVIDIA, AMD, Intel, Apple Silicon, Vulkan và Jetson [1].
Khởi chạy đơn giản là lợi thế với đội ít người: một lệnh docker theo loại phần cứng, hoặc một tệp nhị phân Linux chạy kèm tên mô hình để tự tải từ gallery [1][6]; systemd socket activation còn cho phép chỉ khởi động khi có kết nối đầu tiên [6].
Không hợp là dịch vụ công khai lớn cần tối ưu thông lượng sâu cho một LLM; khi đó nên vận hành trực tiếp engine như vLLM hoặc SGLang, vốn cũng nằm trong danh sách backend của LocalAI [1]. Cũng không hợp với tổ chức không có người duy trì cấu hình bảo mật.
Đề xuất cho một nhà xuất bản sách: trợ lý biên tập, tra cứu kho sách và sách nói nháp trong mạng nội bộ
Tình huống giả định: một nhà xuất bản sách ở Hà Nội có ban biên tập khoảng hai mươi người, bộ phận bản quyền, nhóm truyền thông và một nhóm nhỏ thử làm sách nói. Bản thảo chưa xuất bản là tài sản nhạy cảm, thường có điều khoản bảo mật trong hợp đồng với tác giả, nên ban giám đốc không muốn gửi lên dịch vụ AI công cộng.
Bốn tác vụ đề xuất: tóm tắt bản thảo và nháp lời giới thiệu bìa sau, từ khóa, mô tả cho sàn thương mại điện tử; tra cứu ngữ nghĩa kho sách đã xuất bản bằng embedding, reranker và local-store [1]; chuyển ghi âm buổi ra mắt sách thành văn bản; và tạo bản đọc nháp sách nói cho đầu sách đã có quyền khai thác bản ghi âm.
Một máy chủ tại văn phòng chạy LocalAI với LOCALAI_AUTH bật, đăng nhập qua OIDC của email công ty hoặc lời mời, đăng ký ở chế độ approval hay invite [7]. Biên tập viên mang vai trò user, chỉ gọi endpoint suy luận; chỉ bộ phận CNTT là admin; thống kê theo người và theo khóa giúp phân bổ chi phí giữa các ban [7].
Không cấu hình cloud-proxy cho mô hình nào nhận bản thảo; nếu cần mô hình đám mây cho việc không nhạy cảm, như viết bài quảng bá từ thông tin đã công bố, hãy tạo mô hình proxy riêng có lọc PII [11]. Đây là đề xuất phân tích, không mô tả nhà xuất bản nào đã triển khai.
Sách nói và giọng đọc: quyền, sự đồng ý và giới hạn ngôn ngữ
Sách nói là chỗ LocalAI hấp dẫn nhất với nhà xuất bản và cũng dễ sai nhất. Voice Library cho admin lưu hồ sơ giọng để nhân bản: tối đa mười đoạn tham chiếu, mỗi đoạn 1 đến 120 giây, không quá 50 MiB, khuyến nghị 6 đến 30 giây âm thanh sạch [9].
Quy trình yêu cầu xác nhận có quyền nhân bản giọng qua trường consent_confirmed, và tài liệu coi âm thanh hồ sơ là dữ liệu sinh trắc học riêng tư, chỉ phát cho người dùng TTS đã xác thực [9]. Ô xác nhận chỉ là dấu vết kỹ thuật; nhà xuất bản vẫn cần hợp đồng với người đọc, nêu phạm vi, thời hạn và quyền rút lại sự đồng ý.
Danh sách ngôn ngữ của backend Qwen3-TTS trong tài liệu gồm tiếng Anh, Trung, Nga, Nhật, Hàn, Đức, Pháp, Tây Ban Nha, Ý, Bồ Đào Nha; giá trị ngoài danh sách rơi về tiếng Anh [9]. Nguồn đã đọc không khẳng định backend nào đọc tốt tiếng Việt, nên phải nghe thử bằng hội đồng có chuyên môn; quyền làm sách nói cũng thường phải thỏa thuận riêng với chủ sở hữu quyền tác giả.
Cài đặt, nâng cấp và tính toàn vẹn của backend
Có ba đường cài: Docker image theo loại phần cứng, tệp nhị phân Linux và gói DMG cho macOS, mà README lưu ý chưa được Apple ký [1][6]. LocalAI tự phát hiện GPU để tải backend phù hợp [1]. Build từ nguồn cần Go 1.21 trở lên, GCC, gRPC, và một số kiến trúc mô hình cần thư viện Python không có trong tệp nhị phân [5].
LocalAI không giữ phiên bản cũ của backend nên không có thao tác quay lui [8]; cần ghim phiên bản image và thử bản cập nhật trên máy phụ. Mô hình lớn có thể cần tăng số lần kiểm tra gRPC khi khởi động [10], và với llama.cpp nên đặt max_tokens để yêu cầu bị bỏ dở không giữ slot quá lâu [8].
Gallery backend mặc định thử lần lượt index.localai.io, tệp index trên GitHub rồi gallery OCI có ký [8]. Có thể buộc mọi image có chữ ký Sigstore keyless khớp issuer và workflow khai báo bằng LOCALAI_REQUIRE_BACKEND_INTEGRITY=1; không bật chế độ này thì gallery OCI thiếu chính sách xác minh vẫn cài được, chỉ kèm cảnh báo [8]. Tệp mô hình khai báo trong download_files có thể kèm sha256 [10].
Trên Linux, systemd có thể chạy dịch vụ dưới người dùng riêng localai [6]. Tài liệu build vẫn clone từ go-skynet/LocalAI trong khi kho khảo sát là mudler/LocalAI [5], nên quy trình nội bộ nên ghi rõ địa chỉ kho hiện hành.
Xác thực và riêng tư: “riêng tư theo mặc định” chỉ đúng khi đã bật
Điểm mấu chốt nằm ở một câu trong tài liệu xác thực: nếu không cấu hình xác thực bằng cơ sở dữ liệu hay khóa API, middleware không hạn chế yêu cầu [7]. Khi đã cấu hình, bề mặt HTTP trở thành riêng tư theo mặc định, chỉ chừa route khám phá API, kiểm tra sức khỏe, đăng nhập và tài nguyên giao diện [7]. README ghi bản 4.9.0 đưa vào xác thực từ chối theo mặc định [1], nhưng vẫn phải bật một trong hai chế độ.
Bốn bẫy cấu hình: khóa API kiểu cũ cấp toàn quyền admin; người đầu tiên đăng nhập tự thành admin, nên phải tạo tài khoản quản trị ngay khi dựng; build từ nguồn thiếu tag auth thì LOCALAI_AUTH=true không có tác dụng; cờ miễn khóa cho yêu cầu GET có thể làm lộ route đọc [7].
README hứa dữ liệu không rời hạ tầng [1], nhưng điều đó phụ thuộc cấu hình: cloud-proxy chuyển yêu cầu tới OpenAI, Anthropic hay nhà cung cấp tương thích, và bộ định tuyến thông minh có thể đẩy lời nhắc phức tạp lên đám mây [11]. Agent dòng lệnh đọc tệp và chạy lệnh trên máy, có hỏi phê duyệt khi thay đổi trạng thái [1], nên chỉ dùng trên máy không chứa dữ liệu nhạy cảm.
SECURITY.md hướng dẫn báo lỗ hổng qua email, mục tiêu phản hồi trong 48 giờ, không có tiền thưởng [4]; nhưng bảng phiên bản được hỗ trợ chỉ nhắc 1.x, 2.x, 3.x trong khi README đã nói tới 4.x [4][1], nên cần hỏi dự án về chính sách vá lỗi cho dòng 4.x.
MIT cho lõi LocalAI; backend, mô hình và giọng đọc có giấy phép riêng
Tệp LICENSE là giấy phép MIT, ghi Copyright (c) 2023-2025 Ettore Di Giacinto [2]. MIT cho phép dùng, sao chép, sửa, phân phối, cấp phép lại và bán, với điều kiện giữ thông báo bản quyền và giấy phép; phần mềm được cung cấp nguyên trạng, không bảo hành [2]. Tài liệu kiến trúc kể tác giả chọn MIT để mọi người cùng hưởng lợi [3].
MIT phủ mã LocalAI tại commit này, không tự động phủ các engine bên thứ ba trong image backend như llama.cpp, whisper.cpp hay vLLM [1][8]; mỗi engine mang giấy phép của dự án gốc. Trọng số mô hình, giọng đọc, hồ sơ giọng và nội dung từ gallery hay Agent Hub cũng nằm ngoài phạm vi; cây tệp còn có một tệp giấy phép riêng cho dữ liệu kiểm thử của backend omnivoice mà bài chưa đọc.
Nguồn đã đọc không mô tả phiên bản thương mại; README nêu dự án nhận tài trợ và nhà tài trợ hỗ trợ chi phí CI [1]. Khi dùng cloud-proxy tới OpenAI hay Anthropic [11], dữ liệu và đầu ra còn chịu điều khoản của nhà cung cấp đó, điều giấy phép MIT không thay đổi được.
Chi phí: CPU đủ cho việc gì, GPU cần cho việc gì
Không có phí giấy phép. README khẳng định không bắt buộc GPU [1], còn tài liệu Linux nói yêu cầu phần cứng tùy kích thước mô hình, cách lượng tử hóa và backend [6]. Giả định cho nhà xuất bản: embedding, reranker, chuyển giọng nói ngắn và LLM nhỏ đã lượng tử hóa có thể thử trên CPU; LLM lớn hơn, sinh ảnh, TTS chất lượng cao và nhân bản giọng nên dự trù một GPU tầm trung.
Nhân lực gồm một cán bộ CNTT kiêm nhiệm cấu hình, sao lưu, cập nhật; biên tập viên chấm chất lượng; người phụ trách bản quyền rà điều kiện dùng mô hình và giọng đọc. Thời gian vận hành dành cho cập nhật backend không có quay lui [8], kiểm tra chữ ký và xoay vòng khóa API có hạn dùng [7].
Để định cỡ bằng số liệu thay vì phỏng đoán, README cho biết bản 4.10.0 thêm lệnh local-ai benchmark đo độ trễ và thông lượng mô hình [1], nên chạy trên máy dự kiến mua. Thống kê token theo người và theo khóa [7] giúp tách chi phí giữa các ban. Bài không nêu giá vì giá phần cứng, điện và nhân sự thay đổi theo thời điểm.
So sánh cách tiếp cận: engine chuyên dụng, công cụ một mô hình, API đám mây
Chạy trực tiếp engine chuyên dụng như vLLM hay SGLang cho kiểm soát sâu hơn về thông lượng, nhưng mỗi engine phục vụ một nhóm mô hình và tổ chức phải tự ghép xác thực, hạn mức, giao diện. LocalAI có thể dùng chính các engine này làm backend [1], nên hai cách không loại trừ nhau.
Công cụ chạy LLM cục bộ gọn nhẹ như Ollama hay máy chủ đi kèm llama.cpp có ít thành phần hơn, hợp với một người hoặc một mô hình. LocalAI thêm nhiều phương thức, nhiều người dùng và hạn mức; README còn nhắc khả năng tải mô hình từ registry OCI của Ollama [1].
API đám mây của OpenAI, Anthropic hay ElevenLabs cho chất lượng cao với ít vận hành, nhưng dữ liệu rời hạ tầng. Vì LocalAI tương thích API với cả ba [1], lộ trình thực tế là dùng API đám mây cho dữ liệu đã công khai, rồi chuyển dần tác vụ nhạy cảm về máy nội bộ khi mô hình mở đạt yêu cầu.
Giới hạn: phạm vi rộng, tài liệu chưa đồng bộ, tiếng Việt chưa được cam kết
Tài liệu tại cùng commit có chỗ không khớp: trang cấu hình mô hình nói lớp lọc PII bằng regex và việc che dữ liệu ở phía phản hồi, streaming đã bị gỡ [10], trong khi trang cloud-proxy vẫn mô tả lọc PII trên luồng SSE và đưa ví dụ dùng pii.patterns [11]; SECURITY.md cũng chưa cập nhật cho 4.x [4]. Với yêu cầu tuân thủ, phải kiểm thử hành vi thực tế.
Phạm vi rộng nghĩa là bề mặt tấn công rộng: hàng chục backend, nhiều backend Python có phụ thuộc riêng, agent chạy lệnh, MCP và chuyển tiếp ra đám mây. Chỉ nên cài backend và bật tính năng thật sự cần.
Nguồn đã đọc không cam kết hỗ trợ tiếng Việt, và danh sách ngôn ngữ Qwen3-TTS không có tiếng Việt [9]. Không nên dùng LocalAI khi cần SLA hay hỗ trợ thương mại chính thức, vì README mô tả dự án do một nhóm nhỏ cùng cộng đồng duy trì [1].
Lộ trình thử nghiệm tám tuần cho ban biên tập
Tuần 1 và 2: dựng một máy, bật xác thực với OIDC hoặc lời mời, bật toàn vẹn backend nghiêm ngặt, chỉ cài backend cần cho bốn tác vụ. Kiểm thử bắt buộc: yêu cầu ẩn danh tới /v1/models và /generated-audio/ phải bị từ chối; tài khoản user không gọi được API cài mô hình [7].
Tuần 3 đến 5: đánh giá chất lượng trên khoảng 30 đầu sách đã xuất bản và có quyền dùng nội bộ; biên tập viên chấm tóm tắt và lời giới thiệu theo thang thống nhất; 50 truy vấn có đáp án cho tìm kiếm ngữ nghĩa; hội đồng năm người nghe thử TTS tiếng Việt theo phát âm, dấu thanh, ngắt nghỉ.
Tuần 6 đến 8: năm đến tám biên tập viên dùng trên việc thật ở dạng bản nháp; theo dõi trang Usage [7] và chạy local-ai benchmark để chốt phần cứng [1].
Dừng nếu TTS tiếng Việt không đạt ngưỡng nghe hiểu (khi đó loại sách nói khỏi phạm vi), phát hiện bản thảo đi ra ngoài, biên tập viên bỏ dùng sau hai tuần, hoặc một kiểm thử bảo mật thất bại. Chỉ mở rộng khi ít nhất hai trong bốn tác vụ đạt ngưỡng do ban biên tập đặt trước và không có sự cố dữ liệu.
Kết luận: tiện ở một API, kỷ luật ở cấu hình
LocalAI hợp với tổ chức muốn một cửa ngõ AI nội bộ cho nhiều phương thức, có tài khoản, vai trò, thống kê mức dùng và cơ chế xác minh backend được mô tả chi tiết [7][8]. Giấy phép MIT của lõi rất thoáng [2], nhưng mỗi backend, mô hình và giọng đọc cần được rà riêng.
Với nhà xuất bản, phần chắc chắn có ích là trợ lý biên tập và tra cứu kho sách trong mạng nội bộ; sách nói tiếng Việt phải được chứng minh bằng thử nghe thực tế và hợp đồng quyền rõ ràng.
Ở quy mô nhỏ hơn, những hệ tri thức kiểu bộ não thứ hai mà loạt bài trên phamvanthu.com bàn tới có thể dùng LocalAI làm tầng embedding và hỏi đáp tại chỗ; đó là gợi ý từ phân tích, không mô tả hệ thống nào đang vận hành.
Nguồn tư liệu, phạm vi kiểm chứng và giới hạn
LocalAI nằm trong nhóm Mô hình và suy luận AI của loạt 100 nghiên cứu ứng dụng mã nguồn mở xuất hiện trên GitHub Trending năm 2026. Lựa chọn dựa trên một kho lưu trữ độc lập ghi lại Trending theo từng ngôn ngữ: LocalAI có mặt 30 lần trong giai đoạn 15/01 đến 28/09/2026, và lần được dùng làm bằng chứng là danh sách Go ngày 15/01/2026, nơi dự án đứng đầu [12]. Phạm vi kho chỉ gồm Python, Go, JavaScript, Swift, lại khuyết ngày 03/09 và 12/10, nên đây là tín hiệu tuyển chọn chứ không phải xếp hạng chính thức.
Phiên bản đối chiếu là commit 14381c0fca753a609a4c0e6458bcb49a9212ad90 (ngày commit 12/10/2026, kiểm tra cùng ngày), với README, LICENSE, tài liệu kiến trúc, SECURITY.md, hướng dẫn build và cài trên Linux, cùng năm tài liệu bổ sung về xác thực, backend, chuyển văn bản thành giọng nói, cấu hình mô hình và cloud-proxy [1][2][3][4][5][6][7][8][9][10][11]. README nhắc bản 4.11.0 phát hành tháng 10/2026 [1].
Nghiên cứu dựa hoàn toàn trên tài liệu, có hỗ trợ AI; LocalAI không được cài, chạy hay đo hiệu năng, và bài không phải công trình khoa học đã phản biện. Tình huống nhà xuất bản, giả định chi phí và lộ trình là đề xuất; số liệu về LocalAI trích từ tài liệu dự án, còn con số trong lộ trình là tham số gợi ý.
Xem mã nguồn LocalAI trên GitHub